AI生成D&D奇幻角色肖像:桌游玩家的创作新利器

AI肖像生成:桌游玩家的创作新利器
在桌上角色扮演游戏(TRPG)的世界里,一张生动的角色肖像往往能让玩家更深入地代入自己所扮演的英雄、法师或盗贼。TRPG起源于1974年由Gary Gygax与Dave Arneson共同创作的《龙与地下城》(Dungeons & Dragons,简称D&D)——玩家在游戏主持人(DM,Dungeon Master)构建的虚构世界中,通过描述行动、掷骰决定结果来共同推进故事叙事,是一种以想象力和规则系统为载体的协作叙事游戏。
D&D目前由威世智(Wizards of the Coast)持有版权,现行第五版(5e)自2014年发布以来因规则简化、社区活跃而迎来史上最大规模的玩家增长——这一增长在很大程度上得益于「Critical Role」等实际游戏直播节目的推广,以及疫情期间Roll20、Foundry VTT等线上平台的普及,使全球玩家基数在2020-2023年间翻倍扩张。在这一生态中,角色肖像不仅是装饰品,更是桌游「具象化」叙事的核心工具——它帮助玩家在数小时乃至数年的战役中,将抽象的角色设定转化为可感知的视觉锚点。Reddit社区近期流传的一组AI生成《龙与地下城》风格奇幻角色肖像引发热烈讨论,发帖者的评价言简意赅:"These are excellent. Just keeps getting better(这些作品太棒了,而且还在持续进步)"。
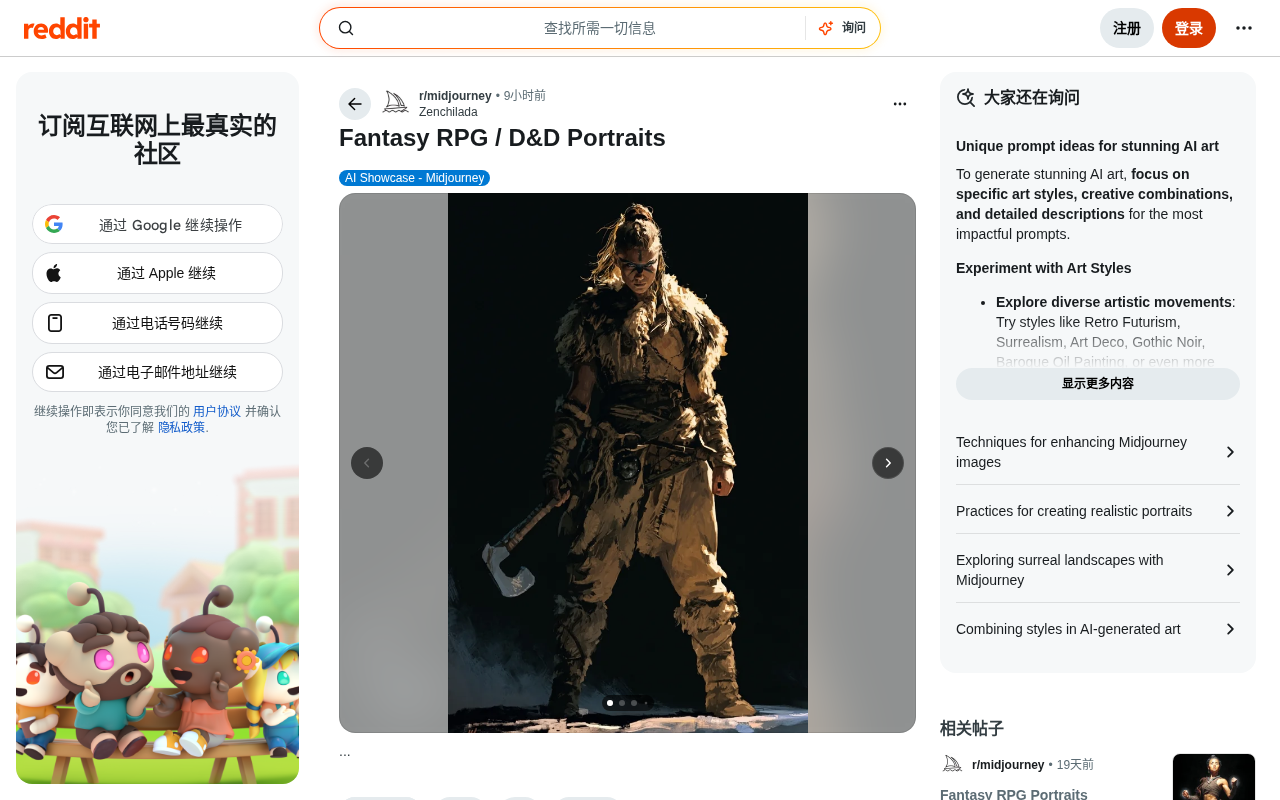
这句话背后,折射出AI图像生成技术在奇幻角色设计这一垂直领域中的快速成熟。对于长期依赖专业插画师或现成素材库的桌游玩家而言,AI角色肖像生成正在从根本上改变他们定制角色形象的方式。
为什么奇幻角色肖像是AI图像生成的理想场景
风格化需求天然契合扩散模型
奇幻RPG角色肖像有着相对明确的视觉语言:夸张的装备造型、鲜明的种族特征(精灵尖耳、兽人獠牙、龙裔鳞片)、戏剧化的光影处理以及浓郁的史诗氛围。这种高度风格化的创作需求,恰恰是现代扩散模型(Diffusion Models)最擅长应对的方向。
扩散模型是当前主流AI图像生成技术的核心架构,其理论根源可追溯至物理学中的扩散过程与热力学。2020年UC伯克利团队发表的DDPM(去噪扩散概率模型)论文首次系统性地将其用于图像生成,工作原理是先向训练图像逐步添加随机噪声,再训练神经网络学习如何将噪声逆向还原为清晰图像。这一"加噪-去噪"的双向过程赋予了模型强大的图像生成能力。随后OpenAI的DALL-E 2(2022)、Stability AI的Stable Diffusion(2022)相继问世,将这一技术推向大众应用。
与此前流行的GAN(生成对抗网络)相比,扩散模型在生成多样性、细节保真度和训练稳定性上均有显著优势。GAN容易出现「模式崩溃」(mode collapse)问题,即生成器陷入只产出少数几种图像的困境;而扩散模型通过逐步去噪的迭代机制,能够更均匀地覆盖数据分布。在计算效率层面,潜在扩散模型(Latent Diffusion Model,LDM)将扩散过程从像素空间压缩至低维潜空间,使生成速度提升数倍,这也是Stable Diffusion系列能够在消费级GPU上流畅运行的关键所在。相比需要精确还原现实的写实摄影,奇幻艺术给了AI更大的创作空间,也更容易产出令人眼前一亮的效果。
海量训练数据奠定坚实基础
从《龙与地下城》官方美术、Magic: The Gathering卡牌插画,到数量庞大的同人创作与概念设计稿,奇幻艺术领域积累了极为丰富的高质量视觉素材,为AI模型提供了扎实的学习基础。
以Magic: The Gathering(万智牌)为例,自1993年发行至今,它已积累超过两万张由全球顶级概念画师创作的卡牌插画,涵盖奇幻、恐怖、科幻等多种视觉风格,是全球最大、最系统的奇幻插画数据库之一。这批数据的视觉质量极高且风格多元,涵盖从写实油画到平面插图的宽广谱系,对AI模型理解奇幻美学中的光影、材质、生物设计规律具有重要价值。这使AI模型能够准确捕捉奇幻美学的精髓——无论是盔甲的金属质感,还是法术特效的流光溢彩。然而这也使万智牌画师群体成为AI训练数据争议的焦点之一,这一点我们将在后文详述。
"持续进步":AI角色生成的技术迭代轨迹
发帖者所说的"keeps getting better"绝非溢美之词。从早期的Stable Diffusion 1.5,到SDXL、Flux等新一代基础模型,再到针对奇幻风格精细微调的LoRA和专用模型,AI在角色一致性、细节表现力和构图美感上的进步已肉眼可见。
LoRA(Low-Rank Adaptation,低秩适配)是一种参数高效的模型微调技术,最初由微软研究院于2021年提出,后被广泛移植至图像生成领域。其核心思想是冻结预训练模型的原始权重,仅在特定层插入少量可训练的低秩矩阵,从而以极低的计算成本实现风格或内容的精确定制。在奇幻角色生成场景中,社区创作者可以用数十张特定画师风格或特定角色的图片训练一个LoRA插件,将其叠加至基础模型上,便能稳定复现目标风格。
LoRA技术催生了活跃的创作者生态:在Civitai等模型共享平台上,流通的LoRA模型已超过十万个,奇幻与RPG类别是下载量最高的类目之一。LoRA文件体积通常只有几十MB,远小于完整模型动辄数GB的体积,极大降低了传播和加载成本。这种"基础模型+LoRA叠加"的组合范式,已成为Stable Diffusion生态中最主流的定制化工作流。值得注意的是,LoRA生态也衍生出新的伦理争议:部分创作者在未征得原作画师同意的情况下,使用其作品训练个人风格LoRA并公开发布,使「风格复制」问题从平台层面下沉至个人创作者层面。
角色一致性迎来关键突破
对桌游玩家而言,最核心的痛点之一是如何保持角色形象的连贯性——同一个角色在不同场景、不同情绪状态下,应当呈现出可辨认的"同一张脸"。随着IP-Adapter参考图控制、ControlNet等技术逐步成熟,AI已能较好地维持角色核心特征。
IP-Adapter(Image Prompt Adapter)由腾讯研究院于2023年提出,通过引入图像编码器(通常基于CLIP模型)将参考图的视觉特征压缩为特征向量,再通过解耦的交叉注意力机制注入扩散模型的生成过程,使生成结果在构图或姿态变化的同时保持对参考角色面部与身份特征的高度忠实——作用类似于给模型提供一张「角色身份证」。传统文本提示词在描述具体人物面貌时存在天然局限,语言难以精确描述面部几何特征的细微差异,IP-Adapter正是针对这一瓶颈的定向解决方案。
ControlNet则由斯坦福大学张吕敏于2023年提出,支持骨骼关键点(OpenPose)、Canny边缘、法线贴图、深度图等多种条件输入,通过提取参考图的骨骼姿态、边缘线条或深度信息作为条件信号,精确控制生成图像中人物的姿势与构图布局。
两者配合使用,实质上构建了一套「身份锁定+姿态自由」的角色生成控制框架:玩家可以固定角色面貌的同时自由切换战斗、休憩、施法等多种姿态。这对需要跨越数月乃至数年持续推进的长期战役(Campaign)的桌游玩家而言,极具实用价值。
细节刻画与氛围营造双双提升
新一代模型在处理精细细节(如武器纹样、织物褶皱、面部微表情)和渲染整体氛围(光照逻辑、色彩基调、景深层次)方面,表现已显著优于早期版本。生成的肖像不再停留在"勉强能用"的层次,而是逐步迈向接近专业插画的品质标准。
AI角色肖像对创作生态的影响与思考
大幅降低角色创作门槛
AI肖像生成最直接的价值在于创作的普惠性。过去,一张定制角色插画可能需要花费数十乃至数百美元委托画师,且交付周期往往以周计算。如今,玩家只需输入描述性提示词,几秒钟内便能获得多个可选方案。对于预算有限的业余玩家团体和独立游戏主持人(DM)来说,这无疑是重大利好。
版权归属与艺术家权益的持续争议
然而,AI艺术的核心争议在奇幻领域同样无法回避:训练数据是否包含未经授权使用的艺术家作品?AI生成图像的版权归属该如何界定?
这场争议自2022年起在全球范围内持续发酵,并已进入实质性法律阶段。美国方面,视觉艺术家Karla Ortiz、Kelly McKernan等人于2023年对Stability AI、Midjourney和DeviantArt提起集体诉讼,指控其未经授权抓取数十亿张图像用于模型训练;Getty Images也对Stability AI提起独立诉讼,要求赔偿高达十亿美元。欧盟《人工智能法案》(AI Act)于2024年正式生效,要求AI系统提供商公开训练数据中受版权保护内容的使用摘要。美国版权局则于2023年明确表示,纯粹由AI生成的图像不受版权保护,人类创作者须对生成物有实质性创意贡献方可主张权利。
在奇幻艺术社区,Greg Rutkowski、Alphonse Mucha等具有高辨识度风格的画师是模型训练数据的重灾区,许多知名概念画师的个人风格,正是模型重点学习的对象。这些法律动态将深刻影响AI图像生成工具的商业模式,也将在相当程度上决定奇幻艺术家与AI平台之间博弈的最终走向。社区在赞美技术进步的同时,也需要正视这一工具对原创艺术家生计可能造成的冲击。
人机协作或成长期可持续路径
一个更为务实的视角认为,AI肖像工具未必是插画师的替代者,而更可能成为创作流程的效率加速器。画师可借助AI快速生成草图和构图参考,再投入精力进行深度精修;玩家则可先用AI创建"占位肖像",待预算充裕时再委托专业创作者进行定制。这种人机协同的工作模式,或许才是长期可持续的健康形态。
结语
Reddit上这组D&D角色肖像引发的广泛好评,是AI图像生成技术在垂直应用领域日益成熟的一个生动缩影。从扩散模型的架构突破,到LoRA的社区化微调生态,再到IP-Adapter与ControlNet带来的角色一致性革命,每一层技术进步都在切实回应桌游玩家的现实需求。对于桌游社区而言,AI正在让"人人都能拥有精美角色肖像"从愿景变为现实。技术的加速进化固然令人振奋,但关于版权边界、艺术价值与创作伦理的讨论也理应同步深入——无论是正在推进的全球性司法裁决,还是艺术家社群的自我保护实践,都将共同塑造这一生态的未来面貌。正如那句评价所言——它"还在持续进步",而我们对如何负责任地使用这项技术的思考,同样需要与之并进。
核心要点
核心要点
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。