AI生成代码占Linux内核补丁17.25%?数据背后的信号

AI生成代码据称占Linux内核9月补丁的17.25%,引发对基础设施软件质量与责任认定的讨论。
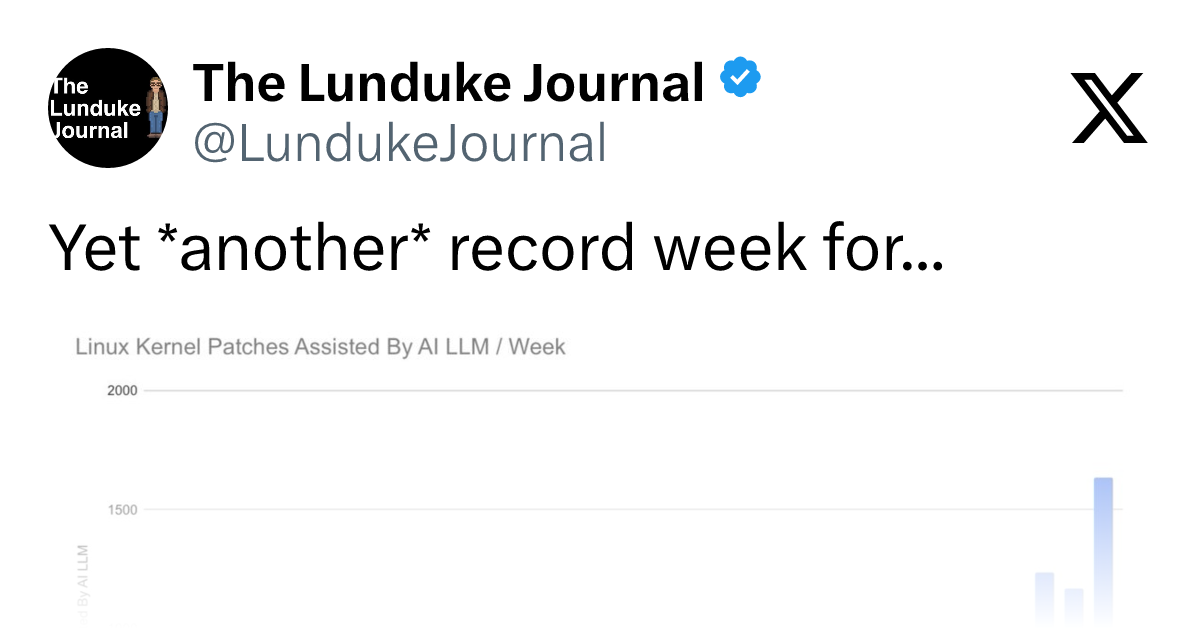
来自Hacker News的讨论称,AI生成代码在九月份已占Linux内核全部补丁的17.25%。文章围绕这一数据点展开分析,指出其核心争议在于统计口径——完全自主生成与人机协作辅助生成的含义差异极大。Linux内核以多层级邮件列表评审机制著称,即便AI参与生成,补丁仍须通过相同的人工审查流程。作者同时警示,AI代码在基础设施软件中占比上升带来了逻辑缺陷难以察觉、许可证合规存疑以及责任认定模糊等新挑战。文章最终以审慎态度收尾:该数字缺乏公开验证与方法学说明,更适合被视为值得追踪的信号,而非已成定论的事实。
AI代码正在渗透开源核心项目
一则来自Hacker News的讨论引发关注:据称在九月份,AI生成的代码已占据Linux内核所有补丁的17.25%。作为全球最重要、审核最严格的开源项目之一,Linux内核的补丁贡献历来以高质量和严格的代码评审著称。如果这一比例属实,它意味着AI辅助编程已经不再是边缘实验,而是开始进入生产级、基础设施级软件的日常开发流程。
需要说明的是,原始素材信息量有限,仅给出了一个百分比数字,缺乏完整的统计口径、数据来源与验证方法说明。因此本文更多是围绕这一数据点展开背景分析与理性讨论,而非将其作为确凿结论。
17.25%这个数字意味着什么
统计口径决定解读方式
判断这一数据的价值,关键在于如何定义"AI生成的代码"。它可能指完全由AI工具(如各类代码助手)生成后提交的补丁,也可能包括开发者在AI辅助下编写、再经人工修改的代码。这两种口径差异极大:前者代表AI的自主贡献能力,后者更接近"人机协作"的真实工作模式。
在实际开发中,越来越多的内核贡献者可能使用AI工具来生成样板代码、修复格式问题、补全注释或处理重复性较高的驱动代码。这类场景下,AI充当的是效率工具,最终的逻辑判断和责任仍由人类维护者承担。
与内核评审机制的关系
Linux内核有着极为严苛的补丁评审流程,每一个补丁都需要经过子系统维护者的审查,最终由核心维护者合并。即便有17%的补丁涉及AI生成的内容,它们依然要通过与人工代码同等的评审标准。这在一定程度上说明:进入内核的AI代码,至少在形式上是经过人类把关的。
Linux内核的补丁提交流程分为多个层级:开发者首先将补丁发送至对应子系统的邮件列表(如[email protected]),由该子系统的维护者(maintainer)进行技术审查,通过后进入子系统的-next分支,最终由Linus Torvalds或其信任的核心维护者合并进主线。整个过程完全基于邮件列表,不依赖GitHub等平台,且每个补丁都有明确的Signed-off-by字段,代表提交者对代码来源和合规性的法律承诺。正是这一机制使得"AI生成占比"的统计本身存在难度——当前流程并不要求标注代码是否由AI辅助生成,维护者可能根本无从区分。部分社区成员已开始讨论是否应引入类似Co-authored-by: AI-tool的约定性标注,但尚未形成统一规范。
为什么这件事值得关注
基础设施软件的特殊性
Linux内核运行在从服务器、手机到嵌入式设备的海量系统上,其代码质量直接关系到全球计算基础设施的稳定与安全。相比一般应用程序,内核对代码的正确性、性能和安全性要求更高。AI生成代码在这类场景中的占比上升,既反映了工具能力的进步,也带来了新的审查挑战。
潜在的质量与责任问题
AI生成代码可能存在难以察觉的逻辑缺陷、许可证合规风险,以及"看起来正确但实际有隐患"的问题。在开源协作中,代码的版权归属和责任认定本就复杂,AI的介入进一步模糊了边界。谁为AI生成的错误负责,如何标注AI贡献,都是社区需要逐步建立规范的议题。
许可证合规风险是AI生成代码面临的一个具体且已有案可查的挑战。AI代码生成模型通常在大量开源代码上训练,存在生成与训练数据高度相似片段的可能。Linux内核采用GPLv2许可证,对代码来源有严格要求。2022年,GitHub Copilot因被发现能复现受版权保护的代码片段而遭到集体诉讼,这一案例至今仍在司法程序中。对于内核这类对许可证合规极度敏感的项目,贡献者需要对AI生成的代码片段保持额外警惕,尤其是算法实现、数据结构等容易与现有实现高度重合的部分。
对开发者与行业的启示
对个人开发者而言,这一趋势提示AI编程工具正从"辅助写业务代码"向"参与核心系统开发"扩展。掌握如何有效使用AI工具、同时保持对生成代码的批判性审查能力,将成为工程师的重要技能。
对整个行业来说,如果连Linux内核这样保守而严谨的项目都出现了可观比例的AI代码,那么在商业软件、Web开发等门槛更低的领域,AI代码的渗透率很可能更高。这既是生产力的机遇,也对代码审查、测试和安全防护体系提出了更高要求。
理性看待单一数据点
最后仍要强调,17.25%这个数字目前缺乏充分的公开验证与方法学说明,来源讨论热度也有限。它更适合被视为一个值得追踪的"信号",而非已成定论的"事实"。在AI编程飞速发展的当下,类似的统计会越来越多,而建立可信、透明的度量标准,或许比数字本身更重要。
无论最终这一比例是否精确,趋势已经清晰:AI正在深度参与软件的编写方式,包括那些最核心的系统。如何驾驭这种变化,将是开发者社区未来几年持续讨论的话题。
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。