AI生成的README正在毁掉开源项目?

AI生成的README充斥营销腔与词汇沙拉,正在拖累优秀的开源项目。
文章从 Reddit 上一则吐槽“vibe coded 项目糟糕 README”的帖子出发,指出越来越多由 AI 辅助生成的项目把 README 写成了营销文案:堆砌同义反复的短句、过度解释、把开发者读者当成第一次接触电脑的幼儿。作者用一个“本地运行”的例子展示何为“词汇沙拉”——一句话能说清的事被扩写成五个排比短句。文章分析这种文风源于大模型训练数据中的营销语料与对齐目标,以及模型无法判断读者背景的缺陷,并给出改进建议:明确 README 目标、删减修饰性内容、对 AI 生成文本手动精简,让文档像代码一样干净利落。
AI生成的README正在毁掉开源项目?
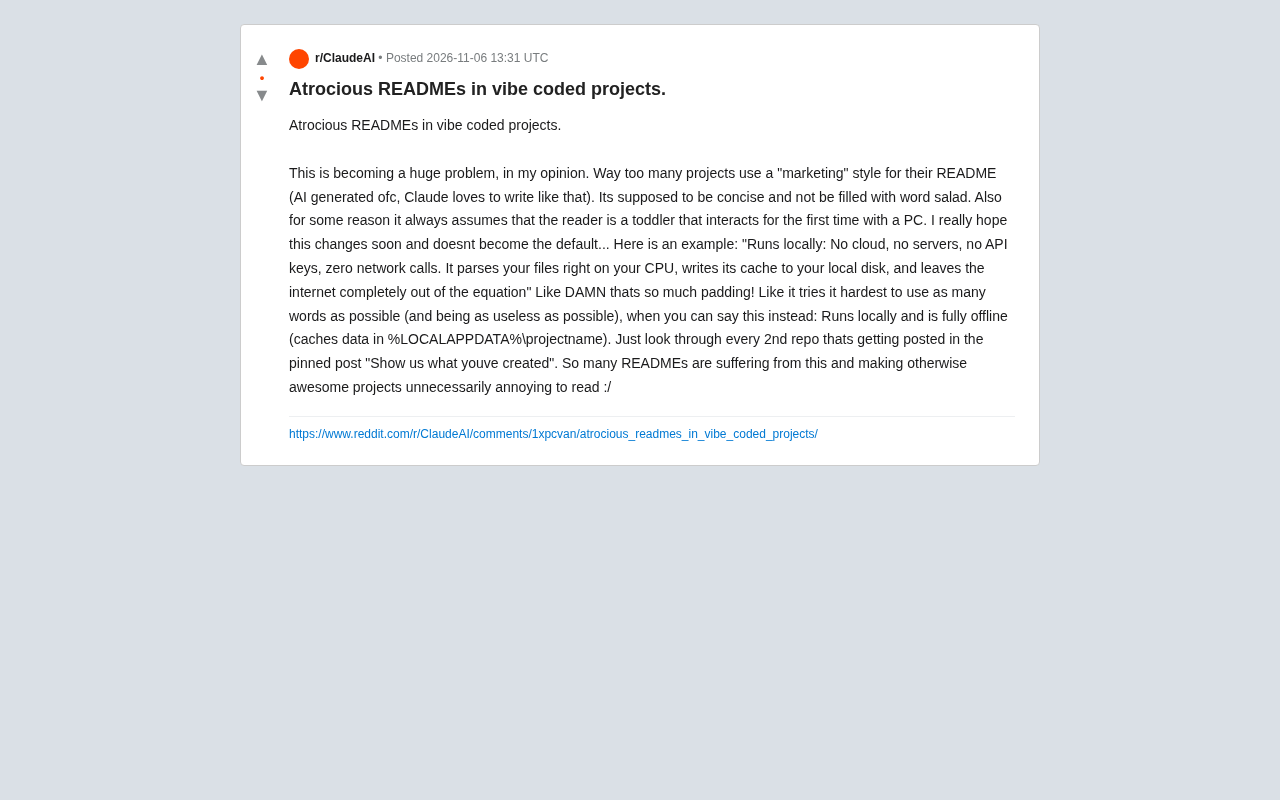
最近,Reddit上一条吐槽“vibe coded项目中的糟糕README”的帖子引发了大量共鸣。发帖人直言不讳地指出,如今越来越多的项目——尤其是那些用AI辅助生成的“vibe coding”项目——把README写成了营销文案,充斥着AI生成的味道。这种现象不仅让项目显得臃肿,还让本来优秀的开源作品变得难以阅读。
README的“营销腔”泛滥成灾
发帖人认为,这个问题已经变得非常严重。许多项目的README不再以简洁清晰为目标,而是采用了一种“营销”风格——这当然也是AI生成的,尤其是Claude,特别爱用这种腔调。作者抱怨道:“它本该简洁,而不是塞满词汇沙拉。”更让人哭笑不得的是,这些README似乎总假设读者是第一次接触电脑的幼儿,恨不得把每个细节都掰开揉碎解释一遍。
这种写法不仅啰嗦,还隐藏着一种对读者智商的低估。开源社区的读者大多是开发者,他们需要的是快速了解项目功能、安装方式和关键配置,而不是被当成需要手把手引导的新手。
vibe coding 是 2025 年初由 Andrej Karpathy 提出并迅速流行的一个说法,指开发者主要靠自然语言向大模型描述意图、由 AI 生成绝大部分代码的编程方式,人只负责把握方向与验收结果。它的特点是上手极快、迭代极短,但产出往往带有明显的“AI 默认风格”,文档尤其如此。与之相关的还有 vibe coded 项目:这类项目常在几天内从想法变成可运行的仓库,作者把精力放在功能上,README 往往直接沿用模型生成的初稿,未经人工精简,于是营销腔、过度解释和词汇沙拉便被一并带入开源社区。
一个典型的“词汇沙拉”案例
为了说明问题,发帖人举了一个例子。某项目的README在描述“本地运行”时写道:
“Runs locally: No cloud, no servers, no API keys, zero network calls. It parses your files right on your CPU, writes its cache to your local disk, and leaves the internet completely out of the equation”
发帖人直接吐槽:“这也太能凑字数了!”明明一句话就能说清楚的事情——“Runs locally and is fully offline (caches data in %LOCALAPPDATA%\projectname)”——却非要堆砌一堆同义反复的短句,用尽可能多的词表达尽可能少的信息。这种写法看似详细,实则空洞,读者读完只觉得浪费时间。
词汇沙拉(word salad) 原为心理学术语,指语句语法通顺但语义空洞、缺乏信息量的表达,后来被广泛借用来形容那种堆砌同义词、排比句和修饰性短语却几乎不增加新信息的文本。判断一段技术文档是否属于词汇沙拉,一个实用标准是“信息密度”:把句子里的同义反复删掉后,剩余信息是否几乎不变。文中那句关于本地运行的描述,删去“no cloud, no servers, no API keys, zero network calls”中的任意几项,读者获得的信息都完全一样,这正是典型症状。
问题普遍存在,甚至出现在推荐帖里
更令人担忧的是,这种现象并非个例。发帖人建议去翻一翻置顶帖“Show us what youve created”里每隔一个repo的README,就会发现大量项目都患有同样的毛病。这些项目本身可能很优秀,但糟糕的文档却成了不必要的障碍,让读者在了解项目之前就先被冗长的文字劝退。
为什么AI偏爱这种文风?
从AI生成文本的机制来看,这种“营销腔”其实有迹可循。大语言模型在训练时吸收了海量的产品文案、营销页面和教程内容,它们倾向于生成“安全”“全面”的表述,以确保覆盖所有可能的场景。于是,“No cloud, no servers, no API keys, zero network calls”这种排比句就成了默认输出——它面面俱到,却忽略了人类读者真正需要的是精炼的信息。
此外,AI往往缺乏对读者背景的判断能力,它不知道面对的是资深开发者还是初学者,只好按照最保守的方式(即对幼儿说话)来写。这种“过度解释”在营销文案中或许有效,但在技术文档中只会适得其反。
大语言模型的训练目标决定了它倾向于生成“高概率、覆盖全面”的文本。模型在预训练中吸收了海量产品落地页、营销文案与入门教程,这些语料本身就偏爱排比、承诺式表述和面面俱到的列举;而在对齐阶段,模型又被奖励“有帮助、不遗漏、语气友好”,于是默认输出往往是安全但冗长的版本。此外,模型无法确知读者的技术水平,只好按最保守的假设写作,这就是技术文档中出现“对幼儿说话”口吻的机制性原因。理解这一点有助于把 AI 输出当作初稿而非终稿。
如何写出不招人烦的README?
发帖人的呼吁很简单:希望这种风气尽快改变,不要成为默认。对于开发者来说,避免AI味过浓的README并不难。首先,明确README的核心目标:告诉读者项目是什么、怎么用、有哪些关键配置。其次,砍掉所有修饰性、重复性的短句,用最直接的动词和名词组合表达。最后,记住读者是开发者,他们不需要被哄着,只需要被尊重。
如果非要用AI辅助写作,不妨在生成后手动精简一遍,把那些“词汇沙拉”删掉。毕竟,一个好的README应该像代码一样干净利落,而不是像广告一样喋喋不休。
README 的经典结构可以作为精简时的参照:一句话项目定位、一段最小可运行示例、安装与依赖、关键配置项、常见问题与许可证。业界常引用的“5 分钟测试”也很实用——新读者能否在五分钟内跑起来并理解项目用途。写作时可遵循“先示例后解释”的顺序,用可复制的命令块和短句替代描述性段落;对于确实需要展开的细节,放入 docs/ 目录或 Wiki,让 README 保持入口页的轻量。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。

Commodore 64经典赛车游戏迎来Driver AI
探索Commodore 64经典赛车游戏《Stunt Car Racer》中的Driver AI实验,了解在资源受限的8位平台上实现自动驾驶AI的技术挑战与启示。

黄仁勋若被替换,开源AI会否生变?Reddit激辩
Reddit网友激辩:如果黄仁勋被替换,英伟达会反对开源AI吗?讨论指出英伟达支持开源AI源于商业利益,需拓宽GPU客户群,而非一人决策。