AI生态金字塔:从底层到应用的完整商业版图

AI生态呈金字塔结构,价值高度集中于芯片与模型层,应用层规模有限,模型公司正面临向应用层渗透的战略压力。
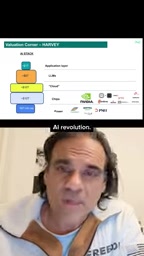
文章将AI商业生态描绘为金字塔结构:底层是能源与芯片,芯片总市值约10万亿美元,远超能源板块不足3万亿美元;中层是云服务与模型,超大规模云厂商与neocloud专业算力公司并存,模型层市值约5万亿美元,分化为美国主导的闭源前沿模型与中国团队为主的开源权重模型两大阵营;顶层应用层虽有小而美的成功案例,但总市值仅约1万亿美元。模型公司因此面临双重焦虑——市场规模天花板和开源免费模型的竞争挤压,可能的出路是向上渗透应用层,推出法律等垂直场景的专用产品。
AI不再只是一个技术概念,它正在演化为一个层次分明的商业生态系统。从提供电力的能源公司到开发前沿模型的研究实验室,再到面向终端用户的应用产品,每个层级都在争夺自己的一席之地。理解这个生态系统的结构,对于判断AI行业的未来走向至关重要。
AI生态系统的基础层:算力与能源
整个AI生态的最底层由能源和芯片两大板块构成。芯片制造商——以NVIDIA为代表——当前总市值约为10万亿美元级别,是增长最快、利润最丰厚的板块之一。而为其提供动力的能源企业,整个标普500中相关公司的总市值加起来还不到3万亿美元,其中真正服务于AI革命的只是其中一小部分。
这种市值差距说明一个现象:AI算力需求的爆发让芯片环节攫取了产业链中最大的价值,而能源层虽然不可或缺,但其商业回报远未达到与之匹配的水平。这种不对称的利润分配,正在吸引更多资本向芯片和基础设施层集中。
云服务商与新兴算力玩家
芯片之上是云服务层,这里聚集了科技行业最重量级的玩家。Amazon、Alphabet、Oracle和Microsoft Azure构成了所谓的超大规模云服务商阵营,Meta和SpaceX也在积极布局算力租赁业务。同时,一批被称为"neocloud"的专业化算力公司正在崛起,CoreWeave和Grok是其中的代表,它们专注于为AI工作负载提供定制化支持。
据YouTube频道分析,这一层的竞争格局正在快速变化,传统云厂商与新兴专业算力提供商的角力将决定AI基础设施的成本结构和可及性。
超大规模云服务商(Hyperscaler) 是指具备全球性数据中心网络、能按需提供大规模计算与存储资源的云平台,通常以年营收百亿美元级和自研基础设施为门槛。Amazon AWS、Microsoft Azure、Alphabet 的 Google Cloud 以及 Oracle Cloud 常被归入这一阵营,它们既是 AI 模型训练所需 GPU 集群的主要出租方,也是模型公司最重要的算力供应商。
Neocloud 则是近两年兴起的专业算力租赁公司,典型代表是 CoreWeave、Lambda Labs、Together AI 等。与超大规模云服务商不同,它们不追求通用云服务的全栈覆盖,而是围绕 GPU 集群针对性优化网络、调度和存储,提供更高密度的 AI 训练与推理环境。其商业模式常以长期合约锁定算力,也因此容易受到 GPU 供应和价格波动影响。
模型层:闭源与开源的路线之争
生态系统的更高层级是模型层,总市值约为5万亿美元。这一层内部分化为两个阵营:美国主导的闭源前沿模型,以Anthropic和OpenAI为代表;以及权重开放的模型,目前以中国团队开发的产品居多。
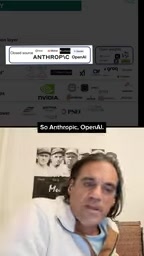
这两个阵营之间的张力构成了当前AI行业最核心的竞争叙事。闭源模型凭借前沿技术能力和产品体验占据优势地位,但开源权重模型正在快速缩小差距。
闭源前沿模型指的是模型权重、训练数据和架构细节不对外公开,仅通过 API 或产品界面提供服务的模型,例如 OpenAI 的 GPT 系列和 Anthropic 的 Claude。其优势在于公司可控制滥用风险、持续迭代并直接变现,但用户无法自行部署或微调。
开源权重模型则公开模型参数,允许任何人下载、修改和本地部署,典型如 Meta 的 Llama 系列、Mistral 以及中国团队开发的 DeepSeek广告、Qwen 等。开源权重模型通常以宽松或受限许可证发布,降低了企业使用门槛,也加速了全球范围内的模型能力扩散。两者之间的核心张力在于:闭源模型追求能力上限和商业闭环,开源模型追求可及性与生态扩散,这一分歧正在重塑 AI 行业的竞争格局。
应用层的悖论与模型公司的战略焦虑
有趣的是,位于金字塔顶端的应用层反而呈现出"小而分散"的特征。虽然Harvey、Replit、Cursor等公司已经取得了商业成功,但据分析,整个应用层所有公司的市值加总也不过1万亿美元左右。
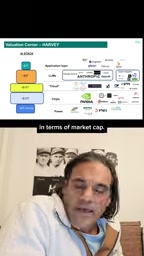
这给模型层的公司带来了两重焦虑。增长可能受限于整体市场规模的天花板;如果开源权重模型持续获得市场份额,闭源模型公司可能被迫与"免费"竞争。即便前沿技术在结果交付上更胜一筹,但在性价比维度上,这场竞争只会越来越激烈。
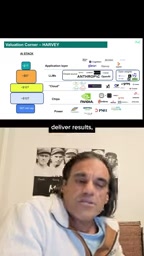
市值加总仅约 1 万亿美元这一数字需要放在对比中理解:它大致相当于 NVIDIA 一家公司市值的十分之一。应用层公司数量众多但单体规模有限,原因在于 AI 应用往往面向特定场景,很难像底层模型或云平台那样形成赢家通吃的规模效应。
这种“小而分散”的结构意味着,即使应用层涌现出 Cursor、Harvey、Replit 等成功案例,整体商业价值仍远低于基础设施和模型层。对模型公司而言,这构成一个战略悖论:它们的技术最终要通过应用层触达用户,但应用层本身的市场规模却可能不足以支撑模型层持续的高估值增长。
模型公司的两条下坡路与上坡路
面对这种压力,模型公司有两个战略方向。向下走,可以自建云基础设施、自研芯片和GPU。但更可能的方向是向上走,渗透到应用层。
Anthropic可能推出"Claude法律版"这样的垂直产品,将Claude的能力专门适配法律实践场景——起草文书、生成简报、进行法律分析。这意味着模型公司不再满足于做底层能力提供者,而是要直接触达终端用户,在应用层寻找新的增长曲线。
这种"模型公司应用化"的趋势,可能会让本来就拥挤的应用层竞争变得更加复杂。当底层模型能力本身成为竞争壁垒时,应用层创业公司的差异化空间将面临严峻考验。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。