AI时代跨语言编程实战:TS调用C++实现高性能计算
演示如何通过Node.js原生扩展实现TypeScript调用C++做向量计算,核心是零拷贝的GB级数据交互优化。
本文基于B站UP主夏老师的演示案例,介绍了AI时代"TypeScript业务编排 + C++高性能计算"混合架构的实现路径。技术核心是通过Node.js的N-API原生扩展机制,将C++编译为`.node`动态库供TS调用,构建工具采用CMake与cmake-js。文章重点剖析了跨语言交互的两大共性问题——环境上下文与变量生命周期管理——以及GB级大数据场景下的零拷贝策略:让JS侧TypedArray与C++侧指针共享同一块堆外内存,绕开垃圾回收并避免数据复制。实测表明接口调用本身开销极小,真正的性能瓶颈在于内存初始化,可通过宿主预分配来优化。这套架构也为后续接入CUDA GPU计算提供了扩展基础。
为什么AI时代要重视跨语言编程
随着大模型和智能体开发的兴起,单一编程语言越来越难以覆盖所有场景。B站UP主夏老师在其演示中提出一个观点:AI时代的开发者需要更广的知识面,因为“各种想法你可以让AI去做,但前提是你得知道”。AI能够执行和辅助判断,却缺乏对可行性的最终把关能力,成本考量与技术选型仍需人来完成。
TypeScript(TS)作为现代开发的热门语言,其应用场景已远超前端。从智能体开发、鸿蒙应用,到服务端程序,TS凭借庞大的生态在越来越多领域落地。而C++则在高性能计算领域不可替代。将两者结合,用TS组织工程与业务逻辑、用C++承担底层重算力任务,成为一种务实的架构思路。
本文基于夏老师的演示案例,梳理如何通过Node.js的C++扩展机制,实现TS调用C++执行大模型相关的向量计算,并重点讨论其中的零拷贝性能优化问题。
技术架构:三份代码协同工作
整个演示需要编写三部分代码,分工明确:
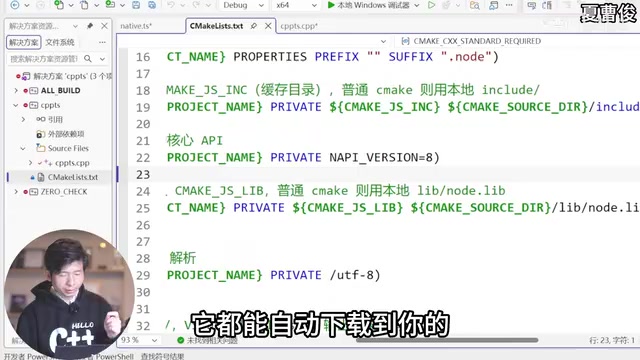
- CMake代码:负责构建配置,把C++编译成Node.js可加载的动态库
- C++代码:实现底层计算逻辑,通过Node API暴露接口
- TypeScript代码:作为调用方,组织数据并触发C++计算
构建基于VS(Visual Studio)与CMake完成。一个关键细节是动态库的后缀名处理:Windows下动态库默认是.dll,但Node.js加载的原生模块要求.node后缀,因此需要在CMake中显式指定输出为SHARED库并改写后缀。
此外,Node.js安装后本地通常已包含所需的头文件与库(如cmake-js相关文件),只需在CMake中引入并锁定版本,避免因版本不兼容导致的编译问题。编译产物默认落在Debug/Release目录,演示中通过CMake配置将其自动复制到当前路径,方便直接运行。
Node.js原生扩展(Native Addon)是Node.js提供的一种机制,允许开发者用C/C++编写模块并在JavaScript/TypeScript中直接调用。其底层依赖Node-API(N-API)——这是Node.js官方提供的一套稳定的C语言接口,设计目标是屏蔽V8引擎版本差异,使编译好的.node文件无需随Node.js升级而重新编译。早期社区也有nan(Native Abstractions for Node.js)方案,但N-API因其ABI稳定性已成为主流选择。cmake-js则是将CMake构建系统与Node.js原生扩展工作流整合的工具,相比传统的node-gyp,它对Windows开发者更友好,能更自然地与Visual Studio工具链协作。.node文件本质上是一个动态链接库(Windows下为DLL,Linux下为.so),只是扩展名被Node.js约定为.node,由require()在运行时动态加载。
C++侧:入口注册与接口暴露
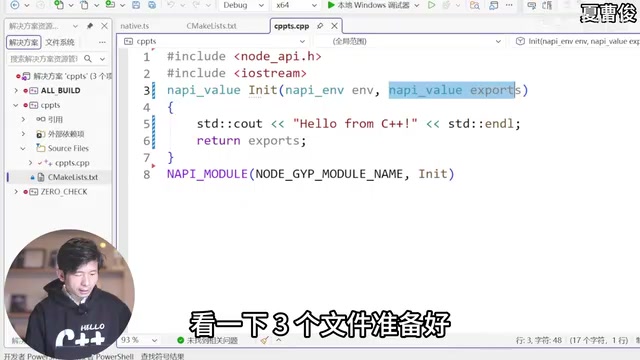
夏老师强调了一个通用的跨语言编程思路:无论写什么程序,第一步都要找到入口。就像标准C++程序的main、ESP32程序的app_main一样,Node.js原生模块也有自己的入口——init初始化函数。
这个入口函数需要通过Node API的宏进行注册。开发者先自己写一个返回类型为napi_value的init函数,在其中完成模块导出(export),再用注册宏声明它。这一步在TS侧对应的正是模块加载(require/load)的动作。
跨语言编程有个共性经验:语言交互本质上要处理两件事——环境上下文与变量生命周期管理。无论是C++调用Python、Lua还是JS,都存在一个环境变量(context/env),以及宿主语言内部变量的生命周期接口。C++需要拿到这两样东西,才能安全地读取参数、创建返回值。
具体的计算函数(如向量点乘dot)同样返回napi_value。与init不同,计算函数被绑定到导出对象上,类似对象的成员函数。函数通过回调信息拿到用户从TS传入的参数,完成计算后再把结果封装回napi_value返回。
零拷贝:大数据交互的核心挑战
这是整个演示中最具价值的部分。夏老师反复强调:现代数据动辄几个G,复制开销非常大,跨语言交互必须尽量做到零拷贝。
演示中构造了一个10000 × 10000 × 10规模的Float32Array作为测试数据,规模达到GB级别。这类大数据有几个关键处理原则:
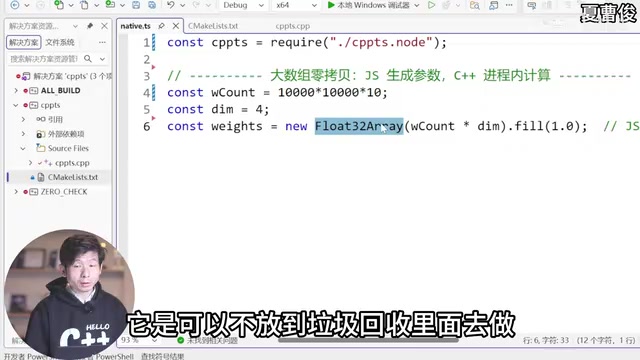
- 绕开垃圾回收(GC):如此大的资源不应交给JS的垃圾回收管理,计算完成后需要手动释放变量、及时归还内存,而不是等GC被动回收
- 共享地址而非复制:结果数组的存储空间,让
node侧变量的地址与C++侧地址指向同一块内存,避免来回拷贝。“但凡你做了接口,就要考虑零拷贝问题” - 权重由TS读取传入:模型权重从文件读出后由TS传给C++,C++在回调中取出参数信息、维度数量,直接在共享内存上计算
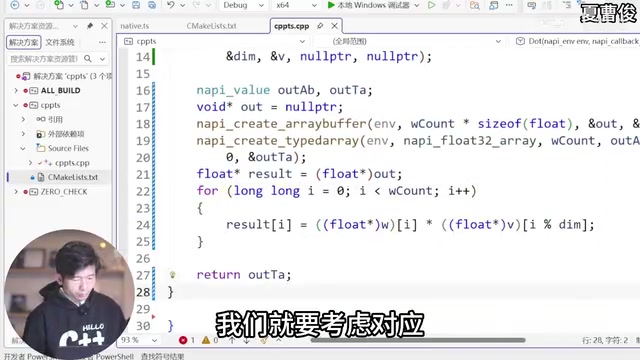
值得关注的一个实测结论:接口调用本身的成本可以忽略。演示中单次计算耗时一秒多,但其中相当部分是4GB内存空间的初始化(约一秒),而非语言交互开销。这也带来一个设计优化方向——把空间初始化提前,或由宿主(TS侧)预先分配内存传入,而不是每次在C++内部生成再返回。
零拷贝(Zero-Copy)在跨语言场景下的核心思路是:让两侧语言的变量直接共享同一块物理内存地址,而非各自持有副本。在Node.js中,TypedArray(如Float32Array)和Buffer的底层数据存储在V8堆外(off-heap),这使得将其内存指针直接传递给C++成为可能——C++拿到的data指针与JS侧TypedArray.buffer指向同一块内存,写入即可被JS侧读取,反之亦然。N-API提供了napi_get_typedarray_info等函数来安全地获取这块内存的指针与长度,而无需任何数据复制。与之对应的是,如果在C++内部new一块内存再将数据序列化传回JS,就必然发生一次拷贝。对于GB级数据,这次拷贝不仅耗时,还会造成峰值内存加倍,是高性能场景下必须规避的反模式。垃圾回收的风险在于:若C++持有JS对象内存的裸指针,而GC在计算过程中移动或回收了该对象,将导致悬空指针。N-API通过引用计数与显式的内存所有权声明(如napi_create_external_arraybuffer)来解决这一问题。
接口开放与调用闭环
光有C++计算函数还不够,必须把它注册到导出对象上,TS才能访问。做法是:在C++侧创建一个函数对象(napi_create_function),将其作为名为dot的属性写入export对象。这样理顺了对象、属性、属性名指向函数的关系后,TS侧即可通过cppts.dot(...)的形式调用。
TS代码本身可以定义完整的类型检查,但在演示阶段夏老师选择先跳过类型约束,聚焦于交互链路的打通。整个闭环建立后,TS负责读取权重、准备大数组、发起调用并计时,C++负责在共享内存上高速运算。
对AI开发者的启示
这个案例的意义不止于技术演示。它折射出AI时代开发者能力模型的变化:技术栈的边界正在模糊,广度要求越来越高。TS的生态优势加上C++的性能优势,通过Node原生扩展机制结合,能够同时兼顾开发效率与计算性能。
对于智能体、大模型推理这类既需要灵活业务编排、又需要高性能算子的场景,这种“TS + C++(甚至CUDA)”的混合架构提供了一条可落地的路径。夏老师也提到后续会继续分享更多跨语言编程的技术案例,将CUDA计算进一步接入这套体系。
需要提醒的是,AI能帮你实现想法,但技术选型的可行性验证、性能瓶颈定位、成本权衡,仍然需要开发者亲自动手实验来确认。
CUDA(Compute Unified Device Architecture)是NVIDIA推出的并行计算平台与编程模型,允许开发者用类C语言直接编写在GPU上运行的代码(称为kernel函数)。在大模型推理场景中,矩阵乘法、向量内积等操作天然适合GPU的大规模并行架构,相比CPU可获得数十倍乃至百倍的吞吐提升。将CUDA接入"TS + C++"体系的思路与本文演示一致:C++层作为桥接,在C++代码中调用CUDA kernel完成GPU计算,再通过N-API将结果以共享内存或零拷贝方式返回给TypeScript。这条路径意味着开发者可以用TypeScript编写智能体的编排逻辑、调度策略与业务接口,同时在底层无缝利用GPU算力,兼顾工程灵活性与推理性能,是本地部署小模型或自定义算子的一种实用方案。
相关推荐

AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。

@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。

ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。