AI时代机器学习工程师如何转型?技能取舍与职业重塑指南

一场关于职业焦虑的公开讨论
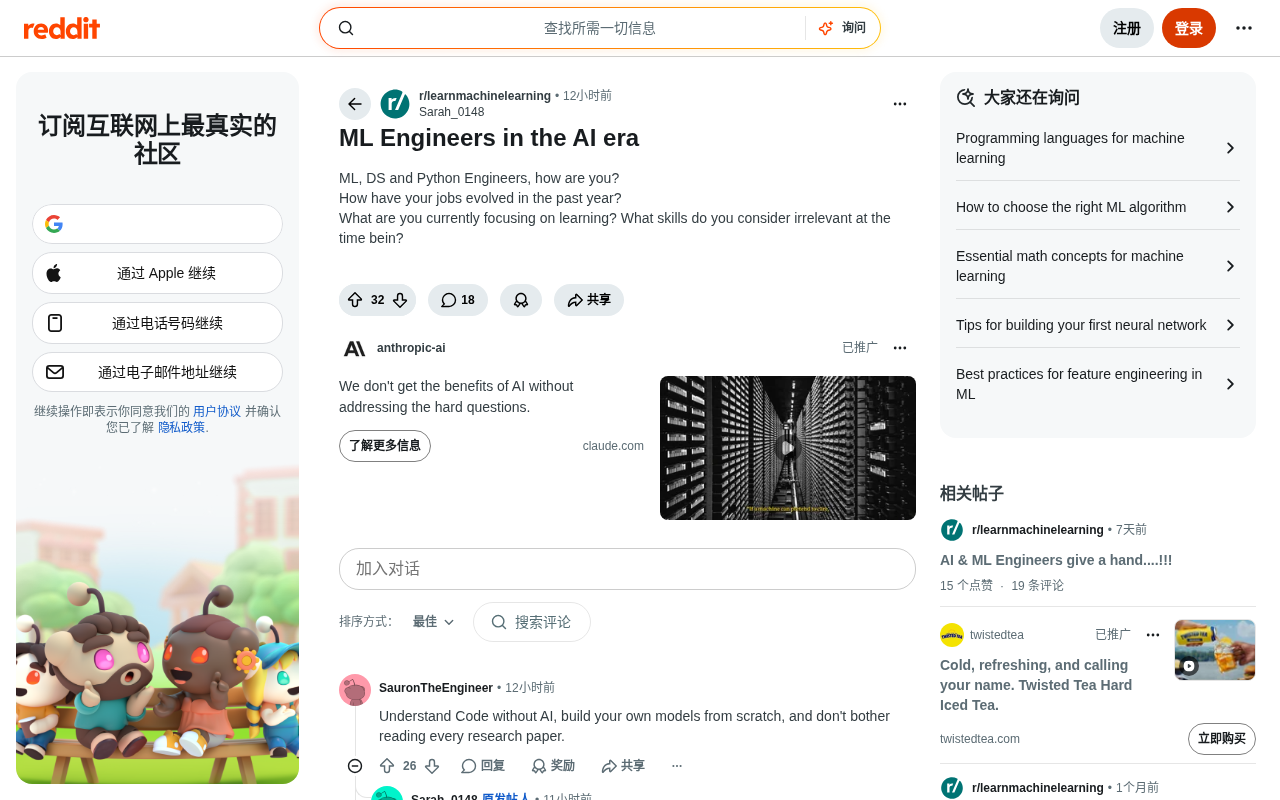
在AI技术狂飙突进的当下,一位Reddit用户抛出了一个引发广泛共鸣的话题:AI时代的机器学习工程师们,你们还好吗?
这条帖子的核心提问简单却直击要害:过去一年里,ML工程师、数据科学家和Python工程师们的工作发生了怎样的演变?大家现在把学习精力放在哪里?又有哪些曾经引以为傲的技能,正在悄悄失去价值?
这个问题之所以能在技术社区引发强烈共鸣,是因为它触碰了整个行业的集体神经。当大语言模型(LLM)能够自动生成代码、当AutoML工具日趋成熟、当各类AI平台持续拉低机器学习的入门门槛,那些花费数年时间打磨专业技能的工程师,不得不重新审视自己的职业定位。
技术背景:大语言模型(LLM)是基于Transformer架构、经过海量文本数据预训练的神经网络模型,代表性产品包括GPT-4、Claude、Gemini等。这类模型通过数千亿甚至万亿级参数的规模效应,展现出强大的代码生成、逻辑推理和自然语言理解能力。AutoML(自动化机器学习)则是一套将特征选择、模型选择、超参数调优等传统ML流程自动化的技术体系,Google的AutoML、H2O.ai等平台使得非专业用户也能快速构建可用模型。两者的结合,从根本上改变了ML工程师的工作边界。
工作内容的悄然转变
回顾近年来ML工程师的日常工作,一个清晰的趋势正在浮现:从"造模型"转向"用模型"。
生成式AI爆发之前,机器学习工程师的大量时间花在数据清洗、特征工程、模型训练与调参上——这是一套相对经典且成熟的工作流程。而今,越来越多的实际场景变成了:如何有效调用预训练大模型、如何设计高质量的提示词(Prompt Engineering)、如何构建RAG(检索增强生成)系统,以及如何将模型能力无缝嵌入产品之中。
RAG系统解析:RAG(Retrieval-Augmented Generation,检索增强生成)是当前LLM应用工程中最重要的架构模式之一。其核心思路是:在向大模型提问前,先从外部知识库中检索出与问题最相关的文档片段,再将这些片段连同原始问题一起输入模型,从而让模型能够基于最新、最准确的私有知识进行回答,有效克服了大模型"知识截止日期"和"幻觉"两大核心缺陷。RAG系统通常依赖向量数据库(如Pinecone、Weaviate、Chroma)存储文本的Embedding表示,并通过语义相似度检索实现高效召回。构建可靠的RAG系统需要工程师深入理解Embedding质量、分块策略、检索排序和上下文窗口管理等多个技术细节。
传统技能的价值重估
这并不意味着传统技能就此失效。恰恰相反,扎实的数学基础、对模型原理的深刻理解、对数据本质的敏锐把握,在AI时代反而成为区分"会用工具的人"和"真正能解决问题的人"的关键分水岭。
那些容易被工具替代的部分——例如简单的模型搭建、标准化的数据处理脚本——确实在贬值。但真正稀缺的,是能够判断"什么时候该用大模型、什么时候不该用",以及"如何评估AI输出可靠性"的工程判断力。这种判断力,恰恰需要深厚的基本功来支撑。
应该学什么,又该放下什么
这场讨论中最具实践价值的部分,是关于学习方向的取舍。
值得重点投入的新技能
LLM应用工程正在成为新的核心竞争力。这包括向量数据库、Embedding技术、Agent框架,以及模型微调(Fine-tuning)等方向。能够将大模型能力工程化、产品化落地,比单纯训练一个小模型更能创造实际业务价值。
Fine-tuning与Prompt Engineering的技术边界:Fine-tuning(模型微调)和Prompt Engineering(提示词工程)代表了将预训练大模型适配特定任务的两种主要路径。Prompt Engineering通过精心设计输入格式、少样本示例(Few-shot)和思维链(Chain-of-Thought)等技巧,在不修改模型权重的前提下引导模型输出,成本极低但效果上限受限于基础模型能力。Fine-tuning则通过在特定领域数据上继续训练,调整模型参数以适应垂直场景,效果更稳定,但需要标注数据和计算资源。近年出现的参数高效微调技术(如LoRA、QLoRA)大幅降低了Fine-tuning的门槛,使得中小团队也能经济地定制专属模型,这正成为ML工程师的新核心技能之一。
系统设计与MLOps能力同样愈发关键。当AI能力被广泛集成进生产系统,如何保障模型服务的稳定性、可扩展性与成本可控,成为衡量资深工程师水平的重要标尺。
MLOps的工程内涵:MLOps(Machine Learning Operations)是将DevOps理念引入机器学习系统全生命周期管理的工程实践体系,涵盖数据版本控制、模型训练流水线自动化、模型注册与部署、线上监控与漂移检测、AB测试等环节。随着AI系统大规模进入生产环境,MLOps能力的重要性已不亚于模型本身的性能。典型工具栈包括MLflow、Kubeflow、Weights & Biases、Seldon等。具备MLOps能力的工程师,能够保障模型服务在高并发、低延迟、成本可控的生产条件下稳定运行,这是纯算法背景工程师往往欠缺的系统工程素养。
此外,跨领域的业务理解能力变得前所未有地重要。当技术门槛被工具拉平,能否精准识别业务痛点、能否将AI能力转化为真实的商业价值,往往决定了一位工程师的职业天花板。
逐渐边缘化的能力
讨论中也不乏对某些技能"贬值"的清醒判断:纯手工特征工程、从零实现常见算法、大量重复性的数据预处理——这些工作正在被自动化工具和大模型逐步接管。并不是说这些知识毫无意义,而是它们已不再构成个人的职业护城河。
AI是威胁还是杠杆?
围绕这一话题,从业者之间存在两种截然不同的声音。
一派认为AI工具正在压缩ML工程师的岗位需求。既然大模型能写代码、能做分析,企业为何还需要维持庞大的算法团队?这种焦虑并非无中生有,尤其对于工作内容偏向执行层面的初级工程师而言,挑战尤为现实。
另一派则认为,AI更像是放大个人能力的杠杆。掌握了AI工具的工程师,生产力可以成倍跃升,一个人足以完成过去整个小团队的工作量。从这个角度看,真正的竞争不是"人vs.AI",而是"会用AI的人"与"不会用AI的人"之间的分化。
这两种判断的分歧,本质上折射出不同职业阶段的从业者面对同一技术浪潮时的真实处境。从劳动经济学的视角来看,这正是"技能偏向型技术进步"(Skill-Biased Technological Change)的经典规律在当下的具体呈现——新技术往往扩大高技能劳动者的相对优势,初级工程师承担的执行性、标准化工作与AI工具能力高度重叠,替代风险最高;而高级工程师和架构师因其对业务、系统和技术边界的综合判断力,在AI时代的稀缺性反而进一步凸显。
给机器学习从业者的几点思考
从这场讨论中,可以提炼出几个具有普遍参考价值的判断:
第一,主动拥抱工具,而非被动抵触。 与其担忧被AI取代,不如尽早成为熟练驾驭AI工具的人,让自己站在技术变革的受益一方。
第二,向价值链上游移动。 当底层执行工作被自动化接管,工程师应当向问题定义、方案设计、业务落地等更难被替代的环节迁移。
第三,保持学习的连续性。 技术迭代的速度前所未有,唯一可靠的应对策略就是持续学习。今天的前沿技能,可能不久后就成为行业基线要求。
归根结底,AI时代对机器学习工程师而言并非单纯的威胁,而是一次深刻的职业重塑机遇。那些能够快速适应、善于把AI当作能力延伸的人,将在这场变革中获得远超以往的成长空间。而这场Reddit上的公开讨论,正是无数从业者站在转折点前的真实缩影。
核心要点
相关推荐

n8n入门实战:零代码搭建AI Agent与自动化工作流
从零开始学习n8n工作流自动化:配置AI Agent、接入Gemini和OpenAI、掌握API与Webhook、构建音频转录和销售汇总等实战项目。零代码入门教程。

Apple智能家居翻身战:首场发布会能否破局
Apple举办首场智能家居专属发布会,分析Apple Home能否借此破局,挑战Amazon和Google在智能家居市场的主导地位。

用 ToolJet MCP 与 Jev 构建客服工单分拣应用
ToolJet 官方博客演示如何用 ToolJet MCP 与 TypeSafe 决策模型 Jev 构建客服工单分拣应用:Jev 为每条工单返回主题、紧急度、清晰度、升级建议和置信度,人工保留最终决策权,100 条合成工单变成可复核队列。