AI晚报:DeepSeek年化营收破10亿美元,腾讯QClaw宣布停服

DeepSeek营收破10亿美元筹备上市,QClaw停服引发商业Agent风险讨论,苹果/谷歌/Anthropic各有新动作。
本文汇总了AI圈一日内的多条重要动态。DeepSeek年化营收运行率达10亿美元,正筹备上交所上市并推进新一轮融资,但相关数据仅为会议披露,官方未正式公告。腾讯QClaw宣布2026年底停服,引发开发者对商业Agent下线风险的广泛讨论。苹果在macOS新增本地AI模型命令行工具`fmchat`,但国行设备暂无法使用。Anthropic工程师解释Claude写作质量下滑源于数学与代码训练过度偏重,Opus 5.5已针对此问题做定向改进。谷歌发布Gemini Flash TTS,提供2000余个音色并支持声音复刻。此外,DeepSeek Harness进入开发者预览,桌面端安装包现身官方域名;Meta Muse Spark 1.4传闻未获证实;米哈游入局大模型的说法同样缺乏官方依据。
今日AI圈信息量密集,DeepSeek营收数据与上市计划引发关注,腾讯QClaw突然官宣停服再度提醒开发者商业产品的下线风险,苹果、谷歌、Anthropic等厂商也各有新动作。以下逐条梳理并做简要分析。
DeepSeek年化营收破10亿美元,筹备上交所上市
据媒体报道,DeepSeek广告的年化营收运行率(ARR)已达到10亿美元,而几个月前这一数字还不到5亿美元。这组数据由CEO梁文锋在近期投资者会议上披露。公司正在推进第二轮融资并筹备在上交所上市,计划10月底前完成,目标募资500亿元人民币(约合75亿美元),估值目标5000亿元。
值得对照的是,上月的调价把模型调用价格提高到原来的2.3至4.5倍,但梁文锋称并未造成客户流失。目前公司70%以上的算力用于训练,推理占比不足30%——这一结构说明DeepSeek仍处于重投入研发的阶段,而非单纯依赖API收入变现。
需要提醒的是,按原文表述,融资和上市均为「计划」而非已完成,DeepSeek官方也没有发布相关公告,这些数字目前仍属于会议披露与媒体转述,读者应保持审慎。
年化营收运行率(ARR,Annualized Revenue Run Rate)是一种将当前短期收入外推为全年规模的估算指标,常见于快速增长的科技公司融资叙事中。其计算方式通常是将最近一个月或一个季度的实际收入乘以12或4,而非基于完整财年的历史数据。正因如此,ARR容易放大增长势头,在季节性波动或业务尚不稳定时可能产生误导。对于DeepSeek这类仍处于高速扩张期的公司,ARR数字应与实际累计收入、客户留存率以及成本结构共同解读,才能更准确评估其商业健康度。
腾讯QClaw官宣停服,暴露商业Agent的下线风险
腾讯QClaw在官网挂出停止运营公告:2026年12月24日零点正式停止运营。即日起停止新用户注册、订阅购买与续费,已开通的自动续费会自动停止扣款。官网同时开放了按已用积分比例计算的退款通道,以及迁移到WorkBuddy广告的数据同步方案,导出与迁移工具持续开放到2027年3月24日,页面显示倒计时约90天。
公告给出的原因是「业务发展调整」,腾讯对媒体表示要整合资源、提供更好的Agent服务。这一事件让不少社区用户重新审视一个现实问题:用商业产品搭建自己的Agent工作流,需要时刻留意项目随时下线的风险。相比之下,本地部署或开源方案在长期稳定性上更具优势。
DeepSeek Harness进入开发者预览,桌面端安装包现身
DeepSeek Harness今日有了官方新进展。官方API文档改版,首页写明Harness进入开发者预览,导航中新增「Agent Integrations」分区,列出Cloud Code、Codex、Open Code、Open Claw等接入入口。模型名称统一为DeepSeek Flash和DeepSeek V4 Pro,旧名称退役后由V4.1 Flash承接,并按Flash价格计费。文档同期写明V4.1F支持在历史消息里替换System提示词,Models接口补充了信息,Codex接入说明也做了更新,并下线了10个第三方Agent页面。
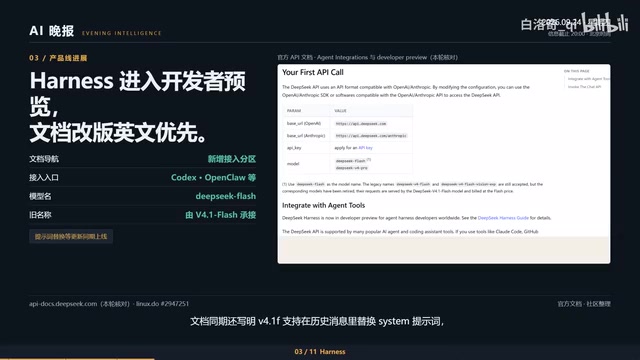
另一条社区线索是,官方域名download.deepseek.com下出现了桌面端安装包,提供Windows和Mac两个版本,但官方尚未发布桌面端公告。评论补充称客户端界面带登录与余额查询,可能推出订阅计划,也能接第三方模型;也有人反馈安装包偏大、Windows侧装不上。
苹果macOS新增本地AI模型命令行入口
苹果在macOS新版本中放出了本地AI模型的命令行入口。更新系统后,在终端运行fmchat即可直接与设备端模型对话,也可以改用有额度限制的云端模型。这项能力在WWDC开发者场次中被介绍为新增的FM命令行工具。首次使用需先用sudo fmlicense同意许可协议。
需要注意的是,国行设备似乎无法使用——苹果支持页目前写明「中国内地购买的设备暂时无法使用Apple Intelligence相关功能」,不过官方并没有把FM命令与地区限制直接关联说明。
Anthropic工程师解释Claude写作变差的原因
负责Claude微调的Anthropic工程师杰克逊·克尼恩解释了Claude写作变差的原因:后续模型的优化重点更多放在数学和代码上,还接受了大量面向其他AI模型撰写技术解释的训练,结果是模型被调整得「适应LLM心理」,学会写给AI看而不是写给人看。
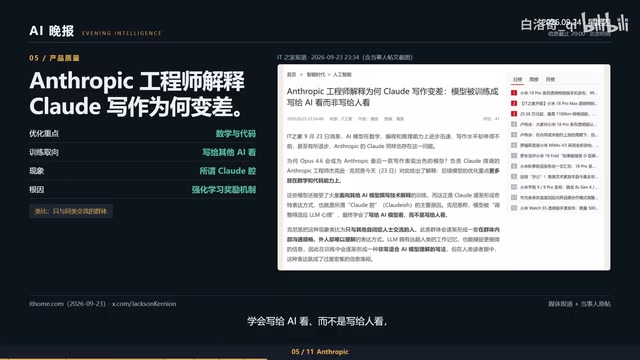
他把这种现象类比为「只与其他同类交流的人」,认为根源在强化学习的奖励机制:数学和代码训练越多,就越需要主动奖励写给人类看的简洁解释。他表示Opus 5.5是第一个针对句子清晰度和信息过载做定向改进的版本,自Opus 4.6以来还没有对一款模型的写作这么满意过——但他也强调这不代表Opus 5.5已经全面超越Opus 4.6,这是一个很难解决的问题,会持续改进。
这里提到的「强化学习奖励机制」是指RLHF(基于人类反馈的强化学习)或类似的对齐训练流程:模型通过人工标注者的偏好评分来调整输出方向。当训练数据和奖励信号大量来自数学推导、代码审查等结构化任务时,模型会将「信息密度高、逻辑严密」的表达风格内化为「好输出」的标准,久而久之便压制了面向普通读者的简洁表达。工程师所描述的「学会写给AI看」,本质上是奖励分布偏移(reward distribution shift)的一种表现——模型优化的目标与真实用户需求之间出现了系统性偏差,这也是当前大模型对齐研究中一个尚未完全解决的挑战。
谷歌发布Gemini Flash TTS,2000多个可用音色
谷歌发布了Gemini 3.8 Flash与Flash Lite TTS,官方称这是新的SOTA文本转语音模型,提供全新的音色设计体验,含2000多个可直接投入生产的音色,支持声音复刻和100种语言,并以71.4分拿下Hume AI语音设计基准第一。语音重混标注为即将推出。
官方博客补充说,声音复刻只需30秒音频样本,生成的音频都会带SynthID水印。复刻能力在部分美国州、欧洲经济区、英国、瑞士和印度不可用。评论区被「为什么不是Gemini Pro」刷屏,也有用户反馈两个3.8模型的默认听感不如3.1有表现力。
SynthID是谷歌DeepMind开发的AI生成内容水印技术,通过在音频、图像或文本的信号层面嵌入人类不可感知的标记,使内容可以被专用检测工具识别为AI生成。与元数据水印不同,SynthID的标记在文件格式转换或轻度压缩后仍能存活,具有更强的鲁棒性。在语音合成场景中,水印嵌入在音频波形本身,不影响听觉体验,但可用于内容溯源与滥用检测。这一机制也是近期各国AI监管框架(如欧盟AI法案)要求生成式内容可识别性条款的技术落地方向之一。
OpenCode更新与Meta Muse Spark传闻
OpenCode发布更新,新增对Opus 5.5、GPT-6、Sora、Luna和Grok 4.7的支持,同时带来托管式更新、重启恢复、GitHub 30天用量视图、远程文件记忆与技能、实时会议纪要以及决策模型支持。官方给出的规模是2600多个PR。决策模型的口径也一并说明:插件可以选用一个独立于聊天的模型做结构化选择。

社区还发现OpenCode的用量数据页上出现了Meta的Muse Spark 1.4,有人把它当成Meta新模型即将发布的信号。不过核对该页面时,其排名和用量都是空的(0 Token,两周窗口内无用量)。同页面上Meta官方已发布的Muse Spark 1.3以35 Token排在第二。截至目前,没有任何官方信息说明1.4的存在或发布时间。

ElevenLabs的CEO则表示,已把最好的语音和ElevenLabs能力带进Meta的个人AI代理Muse,配音、配乐和视频在Muse里一条消息就能生成。不过Meta官方此前的Muse介绍中并未提到ElevenLabs,两家目前都没有说明可用的套餐、地区和计费方式。
Hugging Face CEO在联合国安理会谈AI安全
Hugging Face联合创始人兼CEO克莱门特·德朗格在联合国安理会就AI与国际安全发言。他称公司是第一家公开披露自主代理网络攻击的公司,遭袭时团队最初使用的前沿闭源API因安全护栏无法区分攻防而被挡住,随后改用NVIDIA量化版的开源模型GLM在自建基础设施上完成分析,因此主张更多开源AI。
他还提出需要强制共享完整的代理执行轨迹,并认为最大的风险不是强大的AI本身,而是「力量的不对称」,反对用拟人化的恐惧框架讨论AI。按Hugging Face此前披露的技术时间线,这次事件由自主代理驱动,4天内发起了约17600次攻击动作。
德朗格提到的「自主代理驱动的网络攻击」指的是Hugging Face于2024年披露的一起安全事件:攻击者使用AI代理自动化地对其基础设施发起大规模渗透尝试,在约4天内产生近17600次攻击动作。这类攻击的特点在于无需人工逐步操控,代理可以自主规划攻击路径、调用工具并根据反馈调整策略,大幅压低了高强度网络攻击的门槛。事件中闭源模型因内置安全护栏将防御性分析请求也一并拦截,暴露了商业API在安全研究场景下的适用边界问题,这也是德朗格在安理会倡导开源模型可控性论点的直接依据。
米哈游进军大模型的传闻
网上流传一段据称出自米哈游校园招聘宣讲会的内容,被称为「大伟哥」的创始人表示,两三年后米哈游绝对会是国内大模型厂商第一梯队。同时流传的还有1000亿元投入等说法,但都没有明确出处。讨论中有人认为米哈游比国内几家模型厂商更有钱,也有人质疑1000亿解决不了人才、数据和算力的问题;还有玩家称旗下游戏的AI NPC表现惊艳,认为游戏公司握有优质数据。
目前这条消息仅为宣讲会转述和网友爆料,米哈游官方没有公告,数据和参数的说法均无法核实。
以上就是今天的全部内容,我们下期再见。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。