AI晚报:OpenCode额度升至80美元,GLM-5.3灰测,Step 5开源倒计时
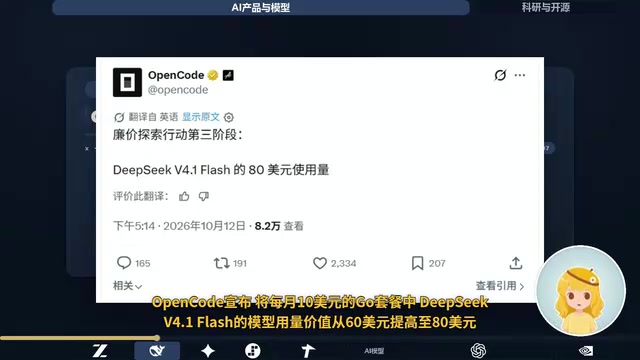
OpenCode加码套餐额度、GLM-5.3高速版灰测、Step 5 Preview开源在即,大模型竞争向具体场景深扎。
本期信息集中在三条主线:工具层用额度换留存,OpenCode把10美元Go套餐中DeepSeek V4.1 Flash的用量价值从60美元提到80美元;模型层用速度抢场景,GLM-5.3 High Speed向部分订阅用户灰测,实测约每秒493个token,为Flash峰值两倍以上;开源层用垂直定位换采用率,Step 5 Preview宣布即将开源,明确面向真实场景的智能体任务。此外,HackingFace将OpenAI形式化数据整理成含369个任务、405道数学题的开源强化学习环境,NVIDIA开源Gator可把照片转为仿真三维资产。整体看,各方向逻辑一致,都在往更具体的使用场景里扎。
AI产品迭代的节奏没有放缓。从额度加码到模型灰测,再到开源倒计时,几条消息拼在一起,能看出当下大模型竞争的几个切面:推理速度、套餐性价比、以及智能体基础模型的开放程度。
OpenCode把Go套餐额度抬到80美元
OpenCode宣布,每月10美元的Go套餐中,DeepSeek广告 V4.1 Flash的模型用量价值从60美元提高至80美元。套餐价格不变,可用额度直接增加三分之一。
这个动作值得拆开看。订阅制AI编程工具的核心卖点之一就是"额度感"——用户需要清楚自己花的钱换来了多少可调用的模型资源。把额度从60美元提到80美元,等于在价格锚点不动的情况下强化了性价比信号。对高频使用DeepSeek V4.1 Flash的开发者来说,这可能是续费或转化订阅的直接理由。
结合近期生成式AI网站流量数据来看,ChatGPT份额一年内从71.8%降至56.4%,但近几个月企稳回升;Gemini升至25.0%稳居第二;Cloud升至9.6%,超过DeepSeek位列第三。竞争格局在松动,工具层通过额度调整争夺用户的动作会更频繁。
GLM-5.3 High Speed开启灰测
智谱方面对部分订阅用户灰度开放了GLM-5.3 High Speed。用户可在Zcode中随机获得体验资格。
据用户实测,生成速度约为每秒493个token,是GLM-5.3 Flash峰值的两倍以上。这个数字如果稳定,对需要低延迟交互的场景——比如代码补全、实时对话、智能体循环调用——会有明显体感差异。
灰测采用"随机获得资格"的方式,说明资源仍在控制范围内。高速版本的定位通常不是替代主模型,而是在特定延迟敏感任务上做补充。后续能否转为正式开放,取决于灰测期间的负载和反馈。
什么是「High Speed」与「Flash」的分层:在大模型产品线里,同一代模型通常会按「能力上限」和「响应速度」拆成不同档位。Flash 类版本往往通过减少推理步数、压缩思维链长度或使用更小的激活参数,来换取更低的单次延迟;而 High Speed 版本则进一步把优化重点放在吞吐与首 token 时间上,常见手段包括推测解码(speculative decoding)、KV Cache 复用以及为高并发请求做批处理调度。
需要区分的是「生成速度」和「模型智能」:每秒 token 数(tokens/s)衡量的是解码阶段的吞吐,它并不直接等于模型在复杂推理任务上的表现。一个高速版本可能在代码补全、格式化输出、短对话等任务上体验极佳,但在需要长链推理的数学或规划任务上未必优于主模型。这也是为什么高速版本通常被定位为「特定延迟敏感任务的补充」,而非全面替代主模型。
Step 5 Preview进入开源倒计时
Step 5 Preview宣布即将开源,定位是面向真实场景中智能体任务的基础模型,官方已开启倒计时。
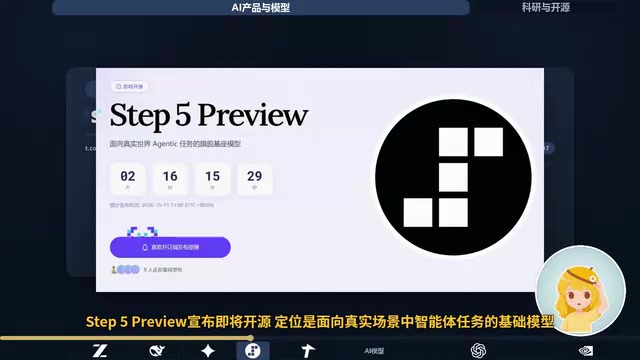
"面向真实场景的智能体任务"这个定位值得关注。过去不少基础模型的开源偏向通用能力展示,而明确指向agent任务,意味着训练数据和评测可能更贴近工具调用、多步规划、环境交互这类需求。如果开源后配套的推理框架和评测集也一并放出,对做智能体应用的团队会是比较实在的补充。
智能体基础模型的训练取向:面向 agent 任务的基础模型,与面向通用对话的模型在训练目标上存在明显差异。前者更强调工具调用(function calling)、多步规划、错误恢复和环境反馈的利用能力,训练数据里往往包含大量带状态的交互轨迹,而不是单轮问答。
这类模型在开源时,真正决定可用性的往往不只是权重本身,还包括配套的推理框架、工具调用协议和评测集。如果只有权重而没有可复现的评测基准,团队很难判断模型在自己的场景里是否真的比通用模型更强。因此「开源是否附带评测集与推理框架」,是判断这类发布含金量的关键指标,也是后续值得持续跟踪的点。
科研与开源:从数学证明到三维重建
两条科研开源消息同样值得记一笔。
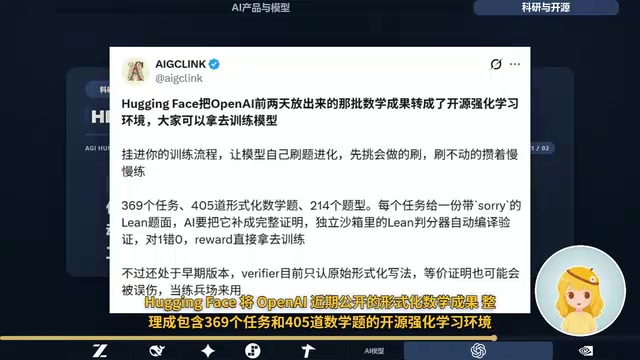
HackingFace把形式化数据变成强化学习环境。 该项目将OpenAI近期公开的形式化数据显示整理成包含369个任务和405道数学题的开源强化学习环境,配有Linux自动判分器,可验证模型给出的证明。研究者可直接用于训练,减少人工评判成本。
NVIDIA开源Gator。 它能把随手拍摄的照片转成用于仿真的三维资产,能自行检查并修复重建结果。团队还演示了人形机器人在重建场景中运行的效果。这类工具的价值在于降低三维内容制作和机器人仿真训练的门槛,把"拍几张照片"和"可用仿真环境"之间的距离缩短。
形式化数据与自动判分:形式化数学(如 Lean、Coq 等证明助手使用的语言)要求每一步推理都严格可检验,因此天然适合做强化学习的奖励信号来源。把形式化数据整理成强化学习环境,核心价值在于「自动判分器」——模型给出的证明可以被机器验证真伪,无需人工逐条评判,这大幅降低了训练与评测的成本。
照片转三维资产的意义:从随手拍摄的照片重建可用于仿真的三维资产,难点在于几何一致性和物理合理性。能自行检查并修复重建结果的工具,意味着它可以减少人工修模的环节。对机器人仿真训练而言,这能显著缩短从「现实场景拍照」到「可用仿真环境」的路径,降低数据采集与场景搭建的门槛。
几个零散但有意思的动态
NASA在Artemis-I任务中采用照片定位模型Astrolog,为宇航员拍摄的3687张月球照片定位。模型通过匹配月面底图切片寻找拍摄位置,方法源自此前定位地球照片的项目。

腾讯TRTC团队推出免费工具Nukate,开发者添加一个异步加载的脚本标签,就能把网页联系页面变成实时聊天入口。访客消息可直达站长的Telegram,回复也能实时返回网页。工具支持接入自定义AI模型,目前仍处于早期开发阶段。
另有消息称,谷歌曾计划更新Gemini 3.X版Flashlight,但9月初出现三个模型检查点后未见新的内部发布,后续可能搁置更新,也可能转向4版,目前尚无定论。
整理下来,这一天的信息集中在三件事上:工具层用额度换留存,模型层用速度抢场景,开源层用垂直定位换采用率。方向不同,逻辑一致——都在往"更具体的使用场景"里扎。
相关推荐
B站最全Agent应用开发路线图:五步从零到工程级
B站748集Agent应用开发教程提炼:五阶段路线从数学、深度学习、Transformer到LLM工程三板斧与Agent实战,解析工程档学习路径、RAG与微调优先级,以及只刷内容不做实验的常见误区。

B站748集AI Agent零基础教程:六周学习路线拆解
B站748集AI Agent零基础教程,六周学习路线从核心逻辑、ReAct范式到RAG融合与项目落地,本文拆解其课程框架与适用人群,帮你判断是否值得投入学习。
Agent智能体入门路线:别被新概念唬住,三步搭建企业级智能体
Agent智能体怎么入门?B站教程提出三步路线:搭知识地图砍掉一半学习量、用真实项目驱动、算投产比选快路。核心公式Agent=大模型+记忆+工具,初学者应跳过底层算法推导,聚焦提示词、RAG和LangChain实战。