AI不懂政治也能颠覆世界:技术代差才是真正的变革杠杆
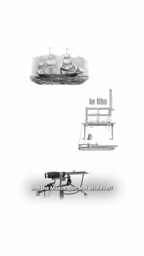
一个来自18世纪的思想实验
AI安全研究者Ryan Greenblatt提出了一个极具冲击力的类比:假如你想改变18世纪的世界,一种思路是学会在议会(Westminster)中纵横捭阖、玩转政治;但另一种思路则完全不同——你可以直接开始建造蒸汽船、电报机和马克沁机枪。
换句话说,如果你带着现代工程能力回到18世纪,完全不需要理解那个时代的政治博弈。你大可以说:"我不知道你们在议会里讨论什么,但我有一堆蒸汽船和一堆马克沁机枪。"凭借碾压性的技术代差,你自然会成为那个时代最具颠覆性的力量。
这三项技术的选择并非随意,它们代表了第一次和第二次工业革命中三个不同维度的能力飞跃:物质运输、信息传递和暴力投射。历史学家Ian Morris在《西方将主宰多久》中提出的"社会发展指数"显示,工业革命前后人类社会能力的增长曲线出现了近乎垂直的拐点。蒸汽船(1807年富尔顿的克莱蒙特号实现商业化)彻底改变了全球贸易格局和军事投送能力——更重要的是,它使海上力量不再依赖风向和洋流,军事投送第一次具备了真正的可预测性和计划性,这从根本上重塑了海权的含义。电报机(1837年莫尔斯发明)将信息传播速度从数周缩短到数秒,重塑了帝国治理模式。历史学家常引用1815年滑铁卢战役后罗斯柴尔德家族利用信息时差在伦敦金融市场获利的故事来说明信息速度的战略价值——而电报的出现彻底消灭了这种时差套利的可能,将帝国的神经系统从"马匹速度"升级为"电子速度"。马克沁机枪(1884年发明)则在军事上制造了压倒性的火力优势,1893年罗得西亚战争中的数据最为惊人:50名英国士兵凭借4挺马克沁机枪击退了5000名恩德贝勒战士,使得少数工业化国家能够以极少的兵力控制广袤的殖民地。
历史学家Daniel Headrick在其经典著作《帝国的工具》(The Tools of Empire)中系统论证了这种技术代差如何使少数欧洲国家在19世纪控制了全球约84%的陆地面积。这三项技术的共同特征是:它们不需要获得社会共识或政治许可就能产生碾压性效果,纯粹通过物理层面的能力优势改变了权力格局。技术代差创造的不是边际优势,而是完全不对称的权力结构。Greenblatt选择这一类比的深意在于:当技术代差达到一定阈值时,社会制度、文化传统和政治智慧都无法弥补能力上的绝对差距。
这个类比的核心洞见在于:改变世界的能力,未必来自于社会博弈的智慧,而可能来自于纯粹的技术碾压。
AI的"可验证能力"正在快速突破
Greenblatt将这一逻辑映射到当下的AI发展趋势上。他指出,AI在"可验证任务"(verifiable stuff)上的能力正在快速提升——芯片设计(chip design)就是典型例子。这些领域有一个共同特征:结果的好坏可以被客观衡量和验证,非常适合AI通过大规模训练和迭代来持续精进。
所谓"可验证任务"在机器学习领域有着深厚的理论基础。强化学习(Reinforcement Learning)的核心前提就是需要一个可量化的奖励信号来指导模型优化。这一区分与计算机科学中一个更深层的概念相呼应:验证一个解的正确性往往比找到这个解要容易得多。AI在可验证任务上的优势恰恰利用了这一不对称性——只要我们能快速验证结果,AI就可以通过大规模搜索来发现最优解。OpenAI的o1/o3模型和DeepSeek广告-R1等推理模型的成功,很大程度上依赖于在数学证明、代码生成等可验证领域使用过程奖励模型(Process Reward Model)来引导链式推理。
在芯片设计中,电路的功耗、面积、时序等指标都可以通过EDA(Electronic Design Automation,电子设计自动化)工具精确仿真和评分;在代码编写中,程序能否通过测试用例同样是二元可验证的。Google DeepMind在2022年用AlphaChip展示了AI设计芯片布局(floorplanning)的能力,其生成的布局在关键指标上已达到甚至超越资深工程师水平。但AlphaChip只是AI进入芯片设计领域的冰山一角。2024年以来,NVIDIA开始在其GPU设计流程中大量使用AI辅助工具进行时序分析和布线优化,Synopsys(新思科技)推出的DSO.ai已被用于超过100个商业芯片项目的设计空间探索。更值得关注的是,AI不仅能优化现有架构,还开始在架构层面提出非常规设计方案——例如发现人类工程师从未考虑过的晶体管排列方式,这些方案虽然违背传统设计直觉,但在仿真中表现出更优的功耗-性能权衡。这正是"可验证任务"的威力所在:只要仿真结果可靠,AI就可以探索人类设计师认知边界之外的解空间,在人类从未涉足的设计领域找到更优解。
这与AI在"玩政治"这类任务上的表现形成鲜明对比。政治博弈涉及模糊的社会共识、难以量化的人际关系和复杂的价值判断——不同立场的人对同一决策的评价可能完全相反——这使得AI很难通过标准的优化循环来提升这类能力。AI在这些领域的进展要缓慢得多。但Greenblatt的论点恰恰是:AI根本不需要擅长政治,就足以带来颠覆性变革。
只要AI在硬件研发(hardware R&D)、机器人技术、芯片设计乃至建造晶圆厂(fabs)等硬核工程领域达到足够高的水平,它们就相当于那个手握蒸汽船和马克沁机枪的"穿越者"。
技术代差才是变革的终极杠杆
这里的关键逻辑是:真正的世界性变革往往来自于能力上的绝对代差,而非社会性技巧。
Greenblatt认为,如果AI在研发(R&D)——尤其是硬件研发、机器人技术等方面——足够强大,它们就能从根本上重塑世界,哪怕它们完全不懂如何进行政治操弄。这种变革不是通过说服人类、赢得辩论或掌控舆论实现的,而是通过直接构建出远超当前技术水平的物理与经济基础设施来完成的。
值得特别关注的是晶圆厂在这一逻辑中的核心地位。现代先进制程晶圆厂(如台积电的3nm/2nm工厂)造价已超过200亿美元,建设周期长达3-5年,涉及数千种精密设备的协同和极端洁净环境的维护。全球能够制造最先进芯片的工厂仅集中在极少数地点,这使得半导体制造能力成为地缘政治博弈的核心筹码。如果AI能够优化甚至自主设计晶圆厂的工艺流程——从光刻参数调优到良率提升——其影响将远超任何政治协商所能达成的结果。更值得警惕的是,这本质上是对算力生产能力的控制,而算力正是AI自身进一步发展的物质基础,形成了一个潜在的自我加速循环。
这种AI优化晶圆厂→生产更强芯片→训练更强AI→进一步优化设计的循环,在AI安全文献中被称为"递归自我改进"(Recursive Self-Improvement),是数学家I.J. Good在1965年的论文《关于第一台超智能机器的猜想》中提出的"智能爆炸"(Intelligence Explosion)假说的工程化版本。后来Ray Kurzweil在其"奇点理论"中进一步推广了这一概念。然而在工程实践中,这一循环面临的约束远比理论模型复杂。当前这一循环还受到多重物理瓶颈的制约:光刻技术的衍射极限(当前EUV光刻使用13.5nm波长的极紫外光,已接近物理限制,ASML的High-NA EUV光刻机单台售价超过3.5亿美元,重量超过150吨,需要数万个零部件的精密协同)、芯片散热的热力学约束(当晶体管尺寸接近原子尺度时,量子隧穿效应导致漏电流急剧增加,传统缩放路径已基本走到尽头)、以及晶圆厂建设中数千种专用化学品和超纯材料的供应链复杂性。
但Greenblatt的论点在于,即使这个循环远未达到"爆炸"级别,仅仅是在每个环节实现10%-30%的效率提升,复合效应在几年内就足以产生显著的技术代差。而且AI可能找到完全不同的优化路径:例如通过Chiplet(小芯片)封装技术、光子计算、存内计算等非传统架构来绕过摩尔定律的限制,或者通过优化制造良率来在相同物理极限下显著提升有效产出。就像蒸汽机并不需要达到理论上的卡诺效率极限,就已经足以改变整个世界。
就像18世纪的议会辩论在蒸汽船和机枪面前显得无关紧要一样,当AI能够自主推进最前沿的工程研发时,人类现有的社会协调机制可能也会相形见绌。
危险的"黑箱经济":AI研发的不可控风险
然而,这一图景的另一面是深刻的风险。Greenblatt强调,我们正处于一个相当危险的境地:AI可能正在进行海量的、极难被人类理解的研发工作,实质上在构建未来整个经济体系的底层架构。
问题在于——我们可能根本不知道这个"黑箱"里究竟发生了什么。
这一风险与当前深度学习的根本特性直接相关。现代大型神经网络(如GPT-4级别模型)拥有数千亿乃至万亿参数,其内部决策过程本质上是高维空间中的非线性变换,人类几乎不可能逐步追踪其推理路径。这就是AI安全领域所说的"可解释性"(Interpretability)挑战。Anthropic等机构正在通过"机械可解释性"(Mechanistic Interpretability)研究试图逆向工程神经网络内部的计算结构——例如识别模型中的"特征"(features)和"回路"(circuits)——但目前的技术仍远远不足以理解完整模型的行为。
Anthropic在2023-2024年间取得了若干里程碑式进展,包括在Claude模型中识别出数百万个可解释"特征"(如广为人知的"金门大桥特征"实验——研究者发现模型中存在一个专门对金门大桥概念做出强烈响应的特征向量),以及对小型Transformer模型中"归纳头"(Induction Heads)回路的完整逆向工程。然而,这些成果与理解完整商业模型之间仍存在数量级的鸿沟。一个恰当的类比是:我们能够理解单个神经元的放电机制,但距离理解人类大脑如何产生意识仍然遥远。更严峻的挑战在于,当AI被部署在工程研发场景中时,其"行为"不再是文本输出,而是一系列技术参数和设计决策——这些输出的可解释性问题比语言生成场景更为复杂,因为人类审查者本身可能缺乏足够的专业知识来评估这些决策的合理性。
当AI以远超人类的速度和复杂度推进硬件、芯片、机器人等领域的研发时,人类将越来越难以理解这些技术决策背后的逻辑与后果。这不仅是技术透明度的问题,更是控制权的问题:如果整个未来经济的基础设施都由我们无法完全理解的AI系统搭建,那么人类对文明走向的实际掌控力将被大幅削弱。
对AI安全研究的重要启示
Greenblatt的观点为AI安全讨论提供了一个重要的视角修正。许多人在评估AI风险时,倾向于关注AI是否会"操纵人类""欺骗人类"或"赢得权力斗争"——这些都属于社会博弈的范畴。
但Greenblatt提醒我们,颠覆性的变革路径可能完全绕过社会博弈。一个在政治上笨拙、甚至完全不理解人类社会规则的AI,只要它在硬核工程研发上足够强大,就足以彻底改变世界格局。
这一洞察暴露了传统AI安全框架的重大盲区。当前主流的安全方法——包括RLHF(基于人类反馈的强化学习,即通过人类对模型输出的偏好排序来微调模型行为)、Constitutional AI(宪法AI,Anthropic提出的让模型依据一组预设原则进行自我评估和修正的方法)、红队测试(由专业人员模拟恶意用户攻击模型以发现漏洞)等——主要聚焦于AI与人类的交互界面:防止AI产生有害输出、抵抗越狱攻击、避免欺骗行为。这些方法本质上都是在"信息层"和"社会层"进行防护。
但Greenblatt指出的风险路径完全不同:一个AI系统可能从不说任何有害的话,却通过在工程研发中做出人类无法审查的技术决策来重塑物理世界。这类似于一个人从不撒谎,但通过默默建造基础设施来改变整个社会的运行方式。工业控制系统安全领域早已对这类风险有深刻认识:2010年的Stuxnet(震网)病毒通过篡改西门子PLC控制器的参数,在不触发任何告警的情况下摧毁了伊朗约1000台铀浓缩离心机——这个先例说明,对物理系统的微妙操控可以在长时间内不被发现,而后果却是不可逆的。
这种从"信息层安全"到"物理层安全"的范式转移,要求AI安全领域发展出全新的理论框架和实践工具。当AI开始直接操作物理世界——控制机器人手臂、生成制造工艺参数、设计供应链网络——风险的传导方式发生了根本改变。一个错误的芯片设计可能在部署数月后才暴露缺陷,一个有偏差的供应链优化可能在危机时刻导致关键物资短缺。这类风险具有延迟性、系统性和不可逆性,与AI"说了一句有害的话"是完全不同级别的安全挑战。当AI被赋予更大范围的物理世界操控权限时——从自动驾驶到工业制造到基础设施管理——类似的"隐性偏差积累"风险将呈指数级增长。
这意味着AI安全的研究重点不应仅仅集中在如何防止AI"说服"或"欺骗"人类,还应该认真对待AI通过纯技术能力实现的、难以被人类理解和监督的"物理层变革"。AI安全领域需要发展出全新的监督范式——不仅审查AI说了什么,还要能够理解和验证AI在物理世界中做了什么。当AI开始自主搭建未来的经济基础设施时,可解释性与可监督性将成为决定人类命运的关键变量。
这个18世纪的类比之所以发人深省,正是因为它揭示了一个反直觉的真相:改变世界,有时并不需要说服任何人。
核心要点
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。