AI写代码哪家强?程序员给编程语言排了个榜

按AI写代码的靠谱程度给编程语言分级,训练数据与编译器反馈决定成败。
文章介绍了一位YouTube博主按“AI写这门语言的靠谱程度”给主流编程语言做的分级排行:S级为Java、Elixir、Go、Rust,A级为TypeScript、Python,B级为JavaScript,C级为PHP,D级为C++。分级依据不是语言本身优劣,而是两个变量——训练数据是否充足,以及语言是否有强约束、能否通过编译器给出清晰反馈帮AI自我纠错。TypeScript因AI滥用any自毁类型防线而止步A级,Python缺编译期检查同样止步A级;Elixir靠“只有一种写法”和不可变数据进S级,Go和Rust靠快速或高质量的编译器报错进S级。C++虽素材丰富,但写法发散、未定义行为能穿过编译器,Agent拿不到反馈而垫底;PHP则受困于训练语料质量参差。
大模型写代码早已不是新鲜事,但一个有意思的问题是:不同编程语言,AI写起来水平差距有多大? 一位YouTube博主按"AI写这门语言的靠谱程度"给主流编程语言做了个分级排行。评价维度不是语言本身好不好用,而是AI生成代码时能否一次写对、出错后能否自己发现并修复。这个视角对日常用AI辅助编程的人相当实用。
排行总览:谁被AI写得最好
先把结论摆出来。S级(AI写得最靠谱):Java、Elixir、Go、Rust;A级:TypeScript、Python;B级:JavaScript;C级:PHP;D级(最不靠谱):C++。
这套分级的底层逻辑其实就两条:训练数据多不多,以及语言有没有强约束能帮AI自我纠错。两个条件占一个就能拿到不错的分数,两个都占就是S级。
A级:训练数据充足,但缺一道保险
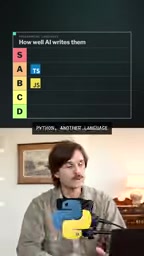
TypeScript被放在A级。理由很直接:AI在TypeScript上的训练非常充分,加上类型检查器能拦住不少问题。没给S级的原因有点黑色幽默——AI特别爱用any类型,等于自己把类型系统这道防线拆了。
Python同样受益于海量训练数据,模型通常一次就能写对。但博主指出,Python几乎没有编译期检查,AI编造的"不存在的类型"和各类bug要等到运行时才会暴露,缺少一道提前拦截的关口,所以止步A级。
JavaScript的处境则被一句话概括:"它就是更差版本的TypeScript",因而落到B级。
S级:要么没得选,要么有编译器当教练
Elixir是个反直觉的案例。按理说它开源代码量不大,AI训练素材有限,表现该很差。但博主认为它反而该进S级:这门语言几乎每件事只有一种做法,而且数据不可变,AI根本没有"写歪"的空间。
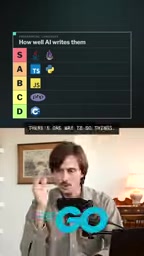
Go走的是另一条路——语言小、编译快、规范统一,AI一旦写错,编译器立刻报错,Agent可以据此自行修正。博主承认AI偶尔会写错goroutine,但这不足以把它踢出S级。
Rust则被视为AI反馈循环最理想的语言:编译器给出的错误信息质量极高,Agent能顺着提示把问题改对。唯一被吐槽的是编译速度慢,但博主认为这不影响它留在S级。
Java的评语最短也最霸道:"S级,无需解释。"
Agent 式的自我纠错循环,指的是 AI 不只是“一口气写完代码就交差”,而是被放进一个“生成 → 运行/编译 → 读报错 → 改代码”的闭环里反复迭代,直到通过检查。这个循环的效率高度依赖反馈信号的质量:编译器或类型检查器给出的错误越具体(比如 Rust 会直接指出哪个变量在第几行违反了借用规则、该怎么改),模型就越容易定位问题;反之,如果错误只表现为运行时崩溃、甚至像 C++ 未定义行为那样“静默地算错”,模型就拿不到可操作的线索。这也解释了为什么同一句“AI 会写代码”,在不同语言里体验天差地别——差别往往不在模型本身,而在语言能不能把“你错了”这件事清楚地告诉它。
Elixir 的不可变数据与“单一写法” 值得展开一点。Elixir 运行在 Erlang 虚拟机上,数据默认不可变,变量只能被重新绑定而不能原地修改,因此不存在“多个地方共享并悄悄改动同一份状态”这类在 Java、C++ 里常见的 bug 来源。加上函数式风格和社区约定俗成的写法,同一件事通常只有一种主流实现方式,AI 生成的代码即便风格生疏,也很难写出“逻辑上歪掉”的结构。这与 Go 的哲学类似——Go 用 gofmt 统一格式、语言特性极少、社区拒绝过度抽象,本质上都是在缩小“正确答案”的空间,让模型更容易命中。
D级与C级:C++和PHP的困境
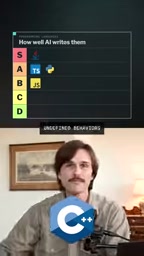
C++被扔进D级,理由值得细看。这门语言有四十年积累的代码可供训练,素材不可谓不丰富,问题出在别处:同一件事有几十种写法,未定义行为和内存bug能直接穿过编译器。
更关键的是后半句——这些错误既然已经通过了编译,AI Agent就拿不到任何报错反馈,也就失去了修复问题的抓手。没有反馈,再强的模型也只能干瞪眼。这恰恰解释了为什么Rust和Go靠编译器就能拿高分,而C++反而垫底。
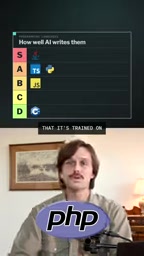
PHP被评为C级。博主提到AI很擅长发现PHP语言层面的漏洞,但训练语料里充斥着WordPress插件和初学者写的代码,素材质量拖了后腿,导致整体表现不如其他语言。
未定义行为(Undefined Behavior,UB) 是 C++ 里一个关键概念:标准在某些情况下(如越界访问数组、有符号整数溢出、解引用空指针、使用未初始化变量)并不规定程序应该做什么,编译器可以任意处理。可怕之处在于它往往“看起来正常”——编译能通过、程序可能跑出结果,但结果不可预测,换编译器、换优化等级行为就可能变。对 AI Agent 来说这是最坏的情况:没有报错可读,也就无法判断自己写错了,甚至会把一个错误的实现当成正确结果继续往下写。相比之下,Rust 用借用检查器在编译期拦截这类问题,Go 用运行时 panic 暴露越界,都至少给了 Agent 一个明确的失败信号。
这份排行对日常写代码的启示
把这份排行放到实际工作中,至少能读出三层意思。
第一,编译器不只是给人用的,也是给AI用的。错误信息越清晰、编译越快,Agent自我纠错的循环就越短。选技术栈时如果打算重度依赖AI辅助,这一点值得纳入考量。
第二,语言的"约束性"正在变成生产力。Go、Elixir这类只允许一种正确写法的语言,恰好压缩了AI自由发挥的空间,出错率自然更低。反过来,写法自由度极高的语言,人类用着灵活,AI用着却容易翻车。
第三,训练数据量大不等于表现好。C++和PHP的素材都不少,但一个败在写法太发散、错误无法反馈,一个败在素材质量不高。数据之外,语言本身的可验证性才是决定AI输出质量的关键变量。
需要说明的是,这是一位开发者的个人分级,带有主观判断,比如Java"无需解释"的S级就没有展开论证。但它提供了一个有价值的观察角度:与其笼统讨论"AI会不会取代程序员",不如具体到某门语言上问一句——AI在这门语言里,能不能自己发现自己错了。
这个问题的答案,可能比模型参数更能预测你明天的编码体验。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。