AI写代码太啰嗦?Ponytail插件让输出精简54%

Ponytail用六阶代码阶梯强迫AI先找现成方案,实测代码行数平均减少54%。
开源插件Ponytail针对AI编程助手"写太多"的痛点,以"很懒的资深工程师"为人设,通过六阶代码阶梯强制AI在动手前逐级检查:是否真有必要写、项目里有无现成、语言库能否胜任、浏览器原生功能是否够用、已装依赖有无可用、能否一行写完。前六阶都不满足才写最少可运行代码。UP主在开源项目中实测十二个任务,代码行数平均减少54%,日期选择器任务减少94%。插件同时划定校验、错误处理、安全与无障碍等不可省略的红线。与单纯加提示词相比,Ponytail的固定顺序带来更高稳定性,二十次安全测试全部守住。它适合常收到冗余代码的开发者,不适合本地小模型和推理模型。
AI编程助手最让人头疼的问题,往往不是它写不出代码,而是它写得太多了。一个简单的日期选择器,它能给你装库、包组件、写样式,折腾出几十行代码,而你真正需要的可能只是一个原生的输入框。
B站UP主尔利介绍的开源插件 Ponytail,就是冲着这个痛点来的。作者是迪特里希·格布特,插件的人设是一个"很懒的资深工程师"——只管代码,不管说话的语气。
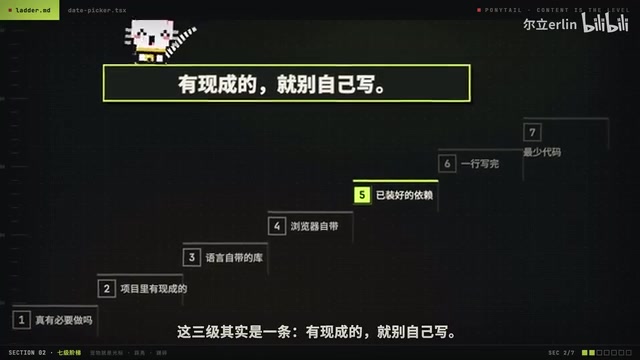
Ponytail的核心机制:代码阶梯
Ponytail 的工作方式可以理解为一个"签读阶梯",一共六阶。每次 AI 准备写代码之前,它会从第一阶开始逐级往上试:
- 第一阶:这东西真有必要写吗?很可能只是猜以后用得上;
- 第二阶:项目里有没有现成的?
- 第三阶:语言自带的库能做吗?
- 第四阶:浏览器自带的功能够不够?
- 第五阶:已经装好的依赖里有没有能用的?
- 第六阶:能不能一行写完?
前三阶其实指向同一个原则:有现成的就别自己写。哪一阶够用就停在哪一阶,前六阶都不行了才动手写,而且只写能跑的最少代码。
这种减法带来的效果很直接。以日期选择器为例,通常的做法是先装一个库、再自己套一层组件;Ponytail 则直接用浏览器自带的日期输入框。弹窗场景同理,用浏览器原生的对话框八行就够了,而组件库方案要三十行还多一个依赖。
渐进式降级(Progressive Degradation) 是 Ponytail 代码阶梯背后的核心设计思想:系统按预设的优先级序列逐级尝试方案,一旦某一级满足需求就立即停止,而不是一次性给出最优解。它与性能优化中的"渐进增强"方向相反——后者从最简方案出发不断加码,前者从最省方案出发按需升级。这种策略在 AI 编程场景中尤其有效,因为大模型天然倾向于生成"完整"而非"够用"的答案。把决策顺序固化为阶梯,等于把模型从"自由创作"约束为"逐项检查",从而大幅压缩了过度工程的空间。
实测数据:代码行数平均减少54%
UP主在一个开源项目里让 AI 完成了十二个功能任务,并和不使用 Ponytail 的情况做了对比。结果是:十二个任务的代码行数平均少了 54%,其中省得最多的是日期选择器,代码量减少了 94%。
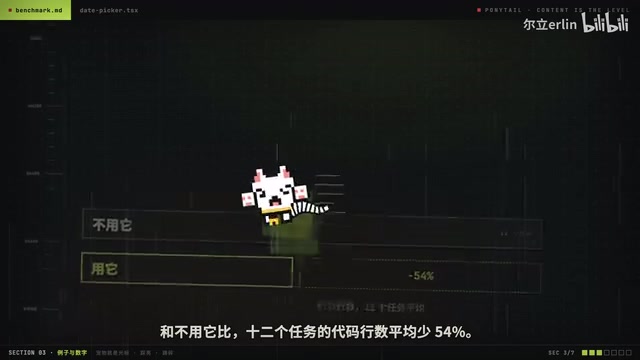
当然也有任务几乎没省下什么。这说明 Ponytail 不是万能的压缩器,它的收益取决于任务本身是否存在"过度工程"的空间。
哪些东西绝对不能省
Ponytail 的"懒"是有边界的。UP主在视频中明确划出了几条红线:
- 用户填写的内容进入系统前该做的校验,还得校验;
- 错误处理不能删,出了错不能把用户数据弄丢;
- 安全和无障碍不能跳过,比如让视障用户也能正常使用;
- 读代码、读懂问题这一步不能省;
- 有分支有循环的代码,要留一个能跑的检查,代码一改坏马上能发现。
换句话说,Ponytail 砍的是冗余的实现和多余的依赖,而不是工程质量的底线。
提示词也能让它少写,但不够稳定
有人可能会问:直接在提示词里加一句"少写点,不行吗?"。UP主验证过,这一招确实有效,但问题在于每次怎么做全看模型临场发挥,没有固定顺序。
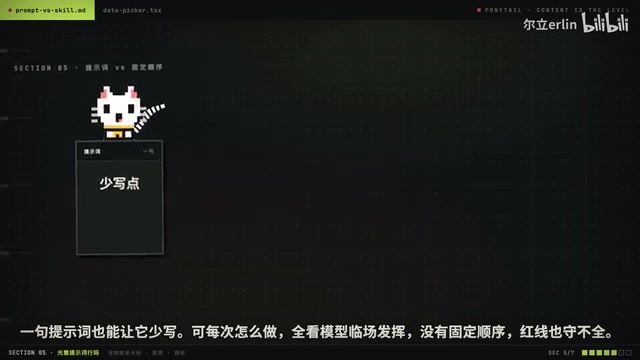
稳定性上的差距可以通过安全测试看出来:一共跑了二十次,只加一句提示词的那组漏了一次,而 Ponytail 二十次全部守住。原因是 Ponytail 每次回答都从第一阶重新往上试,顺序和红线是写死的,模型只负责判断"这一阶够不够用"。
结构化约束 vs. 自然语言约束 是理解这一节的关键。提示词属于自然语言约束,模型每次执行时都要重新"理解"一遍"少写点"的含义,理解结果受上下文、温度参数、模型版本等因素影响,因此行为不可复现。而 Ponytail 把约束编码成固定的检查顺序和硬性红线,相当于把"软建议"变成"硬流程",模型只保留判断权而不再拥有流程决定权。这在工程上对应的是"把规范写成代码"而非"把规范写进文档"——前者可测试、可审计、可回归,后者依赖执行者的自觉。二十次测试中一次漏网正是软约束的典型表现:概率性失效。
适合谁,不适合谁
适合经常收到一大段用不上的代码、想先看看最少怎么写的开发者。插件为 Claude 做过优化,配合 Claude Code 这类工具使用效果最好。
不适合的情况也很明确:
- 本地跑的小模型先别装。作者拿 Llama 3.2 试过,代码没稳定变少,反而多写了一成多;
- 爱琢磨的推理模型也一样,光琢磨就要花时间和钱,可能反而更贵;
- 本来就没几行的改动,也省不出多少东西。
推理模型(Reasoning Model) 指在回答前会进行显式多步思考的模型,如 OpenAI 的 o 系列、DeepSeek广告-R1 等。这类模型在接到"这一阶够不够用"的判断任务时,会展开大量内部推理链,而 Ponytail 的阶梯本身要求快速逐级跳转,二者节奏不匹配:推理开销换来的深度思考在"够用就停"的场景中并不能转化为更少的代码,反而可能因为反复权衡而输出更多内容、消耗更多 token。本地小模型(如 Llama 3.2)则受限于指令遵循能力,难以稳定执行六阶检查和红线规则,实测中代码量不降反升即源于此。
安装与使用要点
以 Claude Code 为例,安装分两步,每次只发一条命令,不能合成一条。这里有个小坑:Ponytail 的自动生效依赖电脑里的 Node.js,找不到它自动生效会悄悄失效,需要手动敲斜杠命令补上。
装完敲斜杠命令可以查看当前处在哪一档。没改过设置时是完整档;Lite 档会照常通过,但会多提醒一次;Ultra 档最激进,能删就删,还会反过来提醒;Off 则是关闭自动。仓库地址和安装命令都在视频简介里,项目采用 MIT 协议,免费使用。
Ponytail 的价值不在于让 AI 变聪明,而在于给 AI 套上一层"先问有没有、再问能不能少"的纪律。对于厌倦了在冗余代码里挑挑拣拣的开发者来说,这层纪律本身就值得一试。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。