AI写论文的数字陷阱:溯源审计比造假检测更关键

AI代理论文数值错误多源于错误归因而非造假,需溯源优先审计。
一项对540份AI研究代理论文评判的再分析发现,这些论文中的数值错误主要不是蓄意造假,而是“张冠李戴”——引用了自己实验记录中错误实验、错误指标或错误运行批次的值。约五分之四的无支撑声明对应的是代理自己文件中存在的数值,只是来源错误。研究者引入确定性“声明到证据”检查器,以超90%精确率认证声明,但覆盖不全;LLM验证器召回更高但错误接受率约为确定性检查器的三倍,二者应结合使用。不同代理的可溯源性差异显著,简单通过/不通过评判掩盖了这一差异。研究者呼吁采用“溯源优先”的审计方法,要求每个数值声明链接到具体实验记录、指标定义和运行批次。
AI研究代理(AI research agents)已经能独立撰写完整的学术论文,但一项新的分析揭示了一个被忽视的问题:这些论文中的数字错误,大多并非蓄意造假,而是“张冠李戴”——引用了自己实验记录中错误实验、错误指标或错误运行批次的值。
重新审视540份AI论文评判:失败集中在“对齐”而非“造假”
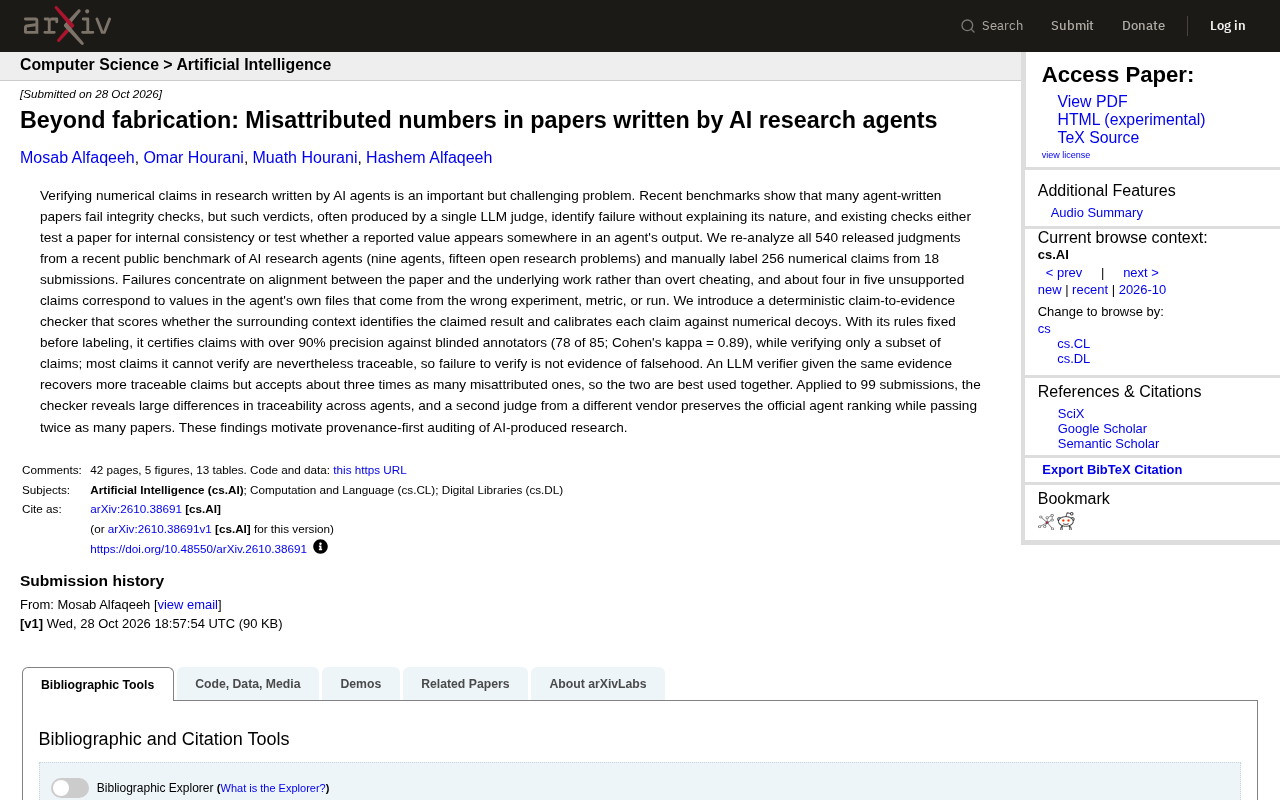
近期一个公开的AI研究代理基准测试涵盖了九种代理和十五个开放研究问题,并发布了全部540份评判结果。研究者对这些结果进行了再分析,并手动标注了18份提交中的256个数值声明。
关键发现是:失败主要集中在论文与底层工作之间的“对齐”环节,而非公然的作弊行为。约五分之四的无支撑声明,实际上对应的是代理自己文件中存在的数值,只不过这些数值来自错误的实验、错误的指标或错误的运行批次。换句话说,AI并没有凭空捏造数字,而是“记错了出处”。
这一结论挑战了此前基准测试的简单二分法。许多完整性检查要么只测试论文的内部一致性,要么只检查某个报告值是否在代理的输出中出现过。单一LLM评委给出的“不合格”判决,往往只说明了失败,却没有解释失败的性质。
确定性检查器:用“数值诱饵”校准声明与证据的匹配
针对这一问题,研究者引入了一种确定性的“声明到证据”检查器(claim-to-evidence checker)。它的核心思路是:对每个数值声明,评估其周围上下文是否足以唯一识别所声称的结果,并用“数值诱饵”(numerical decoys)来校准该声明——即检查代理是否可能混淆了相似但错误的数值。
该检查器的规则在标注之前就已固定,避免了事后调整。在与盲审标注者的对比中,它以超过90%的精确率认证声明(85个中78个正确;Cohen's kappa = 0.89),但只能验证一部分声明。说个细节,大多数它无法验证的声明仍然是可溯源的,因此“无法验证”并不等同于“虚假”。
这一设计哲学体现了“溯源优先”(provenance-first)的审计思路:与其试图判断一个数字是否“真实”,不如判断它是否能被追溯到正确的来源。
Cohen's kappa 是衡量两名标注者(或一个系统与人类标注者)之间一致性程度的统计量,它考虑了随机一致的可能性。取值通常在0到1之间,0表示一致性等同于随机,1表示完全一致。通常认为0.61-0.80为“高度一致”,0.81以上为“几乎完全一致”。文中kappa=0.89表明确定性检查器与盲审标注者的判断高度吻合,远非偶然。这一指标在需要人工标注的评估研究中被广泛使用,因为它比简单的准确率更能反映真实的一致性水平。
数值诱饵(numerical decoys) 是一种校准检查器敏感性的技术:在待验证的声明上下文附近,故意放入与目标数值相似但来源错误的数值(例如来自不同实验、不同指标或不同运行批次的值),然后观察检查器是否会被这些“诱饵”误导。如果检查器能正确拒绝诱饵并匹配到唯一正确的来源,说明它确实在评估上下文与证据的对应关系,而非仅仅做字符串匹配。这种方法借鉴了软件测试中的“变异测试”思想——通过注入已知错误来评估检测器的鲁棒性。
LLM验证器与确定性检查器:互补而非替代
研究者还对比了让LLM验证器在相同证据下工作的表现。LLM验证器能找回更多可溯源的声明,但它接受的错误归因声明数量大约是确定性检查器的三倍。这意味着LLM更“宽容”,但也更容易被表面相似性迷惑。
两种方法各有短板:确定性检查器精确但覆盖不全,LLM验证器覆盖更广但精确度较低。研究者建议将二者结合使用——用确定性检查器做高置信度的认证,用LLM验证器扩大召回范围,再对LLM接受的声明进行人工或规则复核。
精确率(precision)与召回率(recall) 是评估分类系统性能的两个核心指标。精确率指系统认证为“正确”的声明中真正正确的比例,反映“不冤枉”的能力;召回率指所有真正正确的声明中被系统成功认证的比例,反映“不遗漏”的能力。两者通常存在权衡:提高精确率往往牺牲召回率。文中确定性检查器精确率超过90%但覆盖不全(召回低),LLM验证器召回更高但错误接受多(精确率低),正是这一权衡的典型体现。结合二者可追求更好的F1分数(精确率与召回率的调和平均)。
应用结果:不同代理的可溯源性差异显著
将检查器应用于99份提交后,研究者发现不同AI代理在可溯源性上存在巨大差异。有些代理的数值声明几乎都能追溯到正确来源,而另一些则频繁出现归因错误。这种差异在简单的“通过/不通过”评判中完全被掩盖了。
此外,当换用另一家厂商的LLM评委时,官方的代理排名得以保持,但通过的论文数量翻倍。这说明单一评委的严格程度会显著影响通过率,却不一定会改变相对排名。对于依赖基准测试来评估AI研究能力的社区而言,这是一个重要的方法论提醒。
基准测试中的“通过率”与“排名” 是两个不同层面的评估输出。通过率受评委严格程度影响很大:换用更宽松的LLM评委时,通过论文数量可能翻倍,但只要评委对所有代理的相对宽严一致,代理之间的排名顺序仍可保持。这种现象在评估研究中称为“评委效应”(judge effect)。它提醒研究者,绝对通过率不宜跨基准直接比较,而排名在评委更换时更具鲁棒性。然而,排名保持不代表评估有效——如果评委系统性忽略某类错误(如错误归因),排名可能掩盖代理在可溯源性上的实质差异。
对AI科研评估的启示
这项工作的核心贡献不在于指责AI代理“造假”,而在于指出当前评估框架的盲区。如果完整性检查只关注“数字是否出现在输出中”,就会遗漏“数字是否来自正确的实验”这一更深层的问题。
研究者由此呼吁对AI产出的研究进行“溯源优先”的审计:要求每个数值声明都能链接到具体的实验记录、指标定义和运行批次,而不是仅仅检查文本内部的表面一致性。对于正在快速采用AI研究代理的学术界和工业界来说,这或许比单纯提高“造假检测”的灵敏度更为紧迫。
毕竟,一个引用错误实验数据的论文,即使每个数字都真实存在,其结论也可能完全不可靠。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。