AI写作人类贡献度可测量吗?似然度评分机制遭质疑
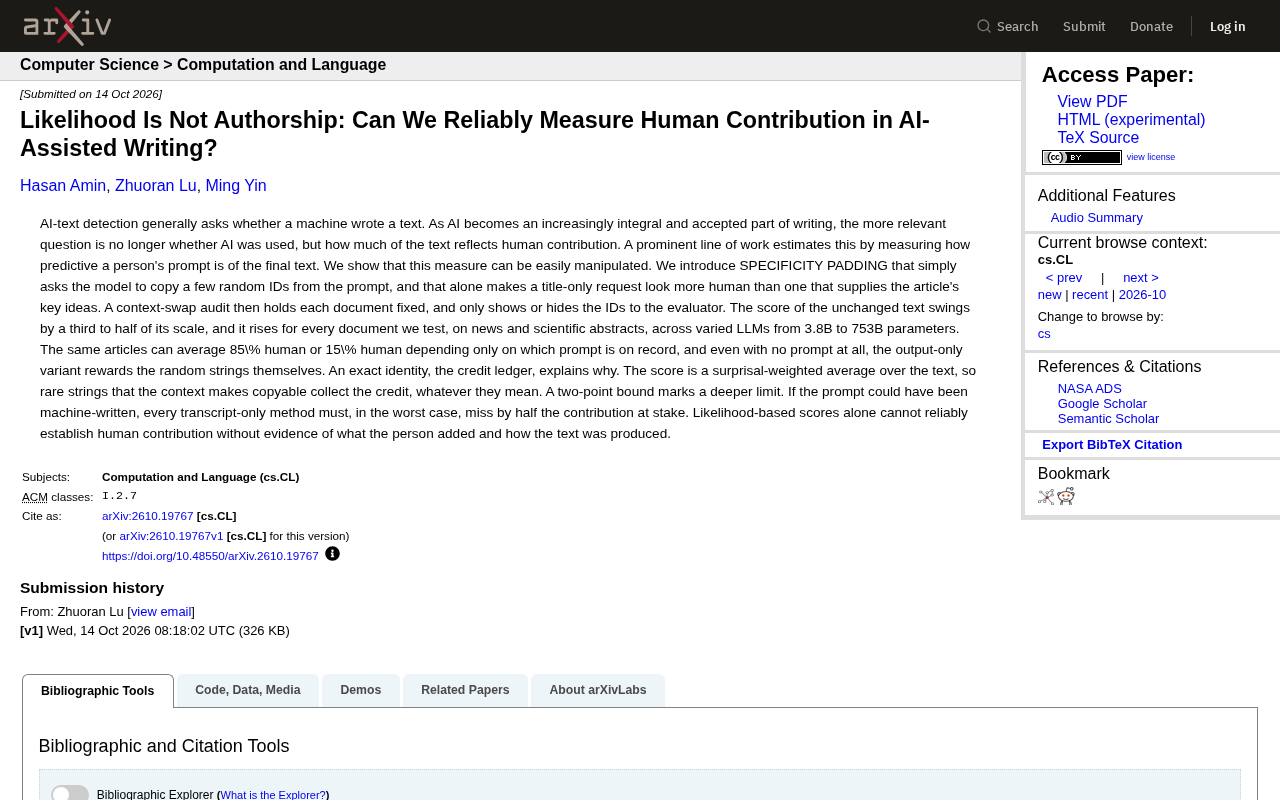
AI文本人类贡献评分可被随机字符串轻易操纵,似然度不等于作者身份。
围绕AI文本检测,学界常用“提示词对最终文本的预测能力”来估算人类贡献比例,但最新研究证明这一逻辑存在根本缺陷。研究者提出“特异性填充”手段:只需让模型复制几个随机ID字符串,就能显著改变人类贡献度评分,甚至让仅提供标题的请求比提供核心观点的请求“更像人类写的”。通过“情境互换审计”,同一篇未修改文本的评分可在85%到15%之间波动。其根源在于评分机制是对文本“惊异度加权平均”,系统奖励的是统计稀有性而非认知贡献。研究进一步提出“两点边界”定理:若提示词可能由机器生成,纯记录方法的最坏误差至少为贡献量的一半。结论是,仅靠似然度评分无法可靠确认人类贡献,必须引入生产过程证据。
当AI写作成为常态,真正该追问的是什么?
围绕AI文本检测的核心问题,长期以来都是"这篇文章是否由机器生成"。但随着AI深度嵌入日常写作流程,这种二元判断正在失去意义。一个更切实际的问题浮出水面:在一篇文本中,人类到底贡献了多少?
据最新一项研究指出,当前学界的部分主流方法试图通过衡量"用户提示词对最终文本的预测能力"来估算人类贡献比例。听起来合理——提示词越精确地指向产出结果,似乎就说明人的输入越关键。但这项研究用实验证明,这个逻辑存在根本性缺陷。
一个简单操作就能让AI文本"更像人写的"
研究团队提出了一种名为 SPECIFICITY PADDING(特异性填充)的操纵手段。操作极其简单:只需让模型从提示词中复制几个随机ID字符串,就能显著改变人类贡献度的评分。
效果有多夸张?一个仅提供标题的请求,经过这种处理,在评分上竟然比一个提供了文章核心观点的请求"更像人类写的"。这意味着评分系统衡量的并非人类思想投入的深度,而是文本中某些可被"复制"的字符串特征。
情境互换审计:同一篇文章,评分能差一半
为了验证这一发现不是偶然,研究者设计了 context-swap audit(情境互换审计)。方法很直接:保持文档内容完全不变,只对评估者显示或隐藏提示词中的随机ID字符串。
结果令人震惊——同一篇未经任何修改的文本,其人类贡献评分在量表上波动了三分之一到一半。在所有测试文档中,评分都出现了上升。测试样本覆盖新闻报道和科学摘要,调用的模型参数量从 38亿 到 7530亿 不等。
更直观的数据是:同一批文章在只更换提示词记录的情况下,平均人类贡献评分可以是 85% 也可以是 15%。即便完全不提供提示词,仅凭输出文本的变体评分方式,也会奖励那些随机字符串本身。
信用账本:为什么评分机制天然偏向"稀有字符串"?
研究给出了一个精确的解释模型,称为 credit ledger(信用账本)。
核心机制在于:这类评分本质上是对文本的惊异度加权平均(surprisal-weighted average)。也就是说,那些因为上下文环境而变得可复制的稀有字符串,会自动收集到更高的信用分,无论它们实际含义如何、是否承载了人的思想。
这就解释了为什么复制随机ID比提供核心观点"更有效"——前者在统计上更稀有,因此被系统赋予了更高权重。评分系统奖励的是统计特征,而非认知贡献。
一个更深层的理论边界
研究还提出了一个两点边界(two-point bound),揭示了更根本的限制:
如果提示词本身可能是机器生成的,那么所有仅依赖文字记录的方法,在最坏情况下,其误差至少是所涉贡献的一半。
这个结论指向一个关键判断——仅凭似然度评分,无法可靠地确认人类贡献。要真正衡量人在AI辅助写作中的投入,必须同时掌握两样东西:人具体添加了什么内容,以及文本是如何被生产出来的。
没有这些生产过程证据,任何基于提示词-输出预测关系的评分,都可能在测量统计假象而非人类智慧。
似然度(likelihood) 在机器学习中指模型对观测数据赋予的概率,通常用于衡量一段文本在某个模型下“像不像”训练分布中的样本。在AI文本检测或人类贡献评估中,常用做法是将“提示词条件下生成该文本的似然度”作为代理指标:似然度越低,越被认为“人写的”。然而,似然度本质上是一个统计量,它只反映概率分布下的相对稀有性,并不能区分“人类深思熟虑后写出的独特表达”与“机器随机复制的无意义字符串”。因此,当论文指出“似然度不等于作者身份”时,它强调的正是统计相关性与因果/认知归因之间的鸿沟。要建立真正的作者身份判断,需要引入过程性证据,而非仅依赖最终文本的似然度分数。
对AI写作工具与评估体系的启示
这项研究的影响范围不止于学术讨论。对于正在构建AI写作辅助产品的团队、以及试图用自动化手段评估内容原创性的平台而言,以下问题值得重新审视:
- 基于提示词预测力的评分指标,能否作为人类贡献度的代理变量?
- 当评分可以被几个随机字符串轻易操纵时,这类指标在产品中的可信度还剩多少?
- 评估人类贡献是否需要引入过程性证据(如编辑历史、版本迭代记录),而非仅依赖最终文本与提示词的静态对照?
该研究没有给出替代方案,但它清晰划出了一条边界:似然度不等于作者身份。在AI与人类协作写作日益普遍的背景下,如何更诚实地衡量人的贡献,仍是一个远未解决的开放问题。
背景补充
惊异度(surprisal) 是信息论中的基础概念,指一个词或字符串在给定上下文中出现的“意外程度”,常用其负对数概率来衡量:概率越低,惊异度越高。在自然语言处理中,语言模型会为每个token输出条件概率,因此可以逐词计算整段文本的惊异度分布。当某段文字被提示词高度约束时,模型对该文字的预测概率会上升,惊异度随之下降;反之,随机ID这类几乎无上下文线索的字符串,其生成概率极低,惊异度高。所谓“惊异度加权平均”,就是把这些逐词的惊异度作为权重,对文本各部分的“贡献”进行加权求和。由于稀有字符串权重极大,它们会不成比例地拉高整篇文本的评分,即使这些字符串并不携带任何人类思想。这一机制正是“信用账本”能够被几个随机ID轻易操纵的数学根源。
相关推荐

Product Hunt 推出可视化发布编辑器,告别繁琐填写
Product Hunt 推出可视化发布编辑器,支持点击原位编辑名称、标语、画廊和 maker 信息,自动保存草稿,并用检查清单引导创作者完成发布。本文解析其编辑逻辑与对发布体验的影响。

泽连斯基亲述:俄军2000万人压境,我们如何守住基辅
泽连斯基访谈回顾俄乌战争初期:俄军200,000兵力直扑基辅,乌军主力却在东部。他讲述动员如何将军队从200,000扩张到800,000,以及基辅州、切尔尼戈夫州如何被收复。

Ovren Live Preview:用自然语言实时预览产品改动
Ovren Live Preview 是一款用自然语言描述改动、在真实页面上实时预览的 AI 开发工具。了解其核心功能、工作流、市场定位与潜在挑战。