AI协作新范式:用Git版本化人类与AI的决策记录
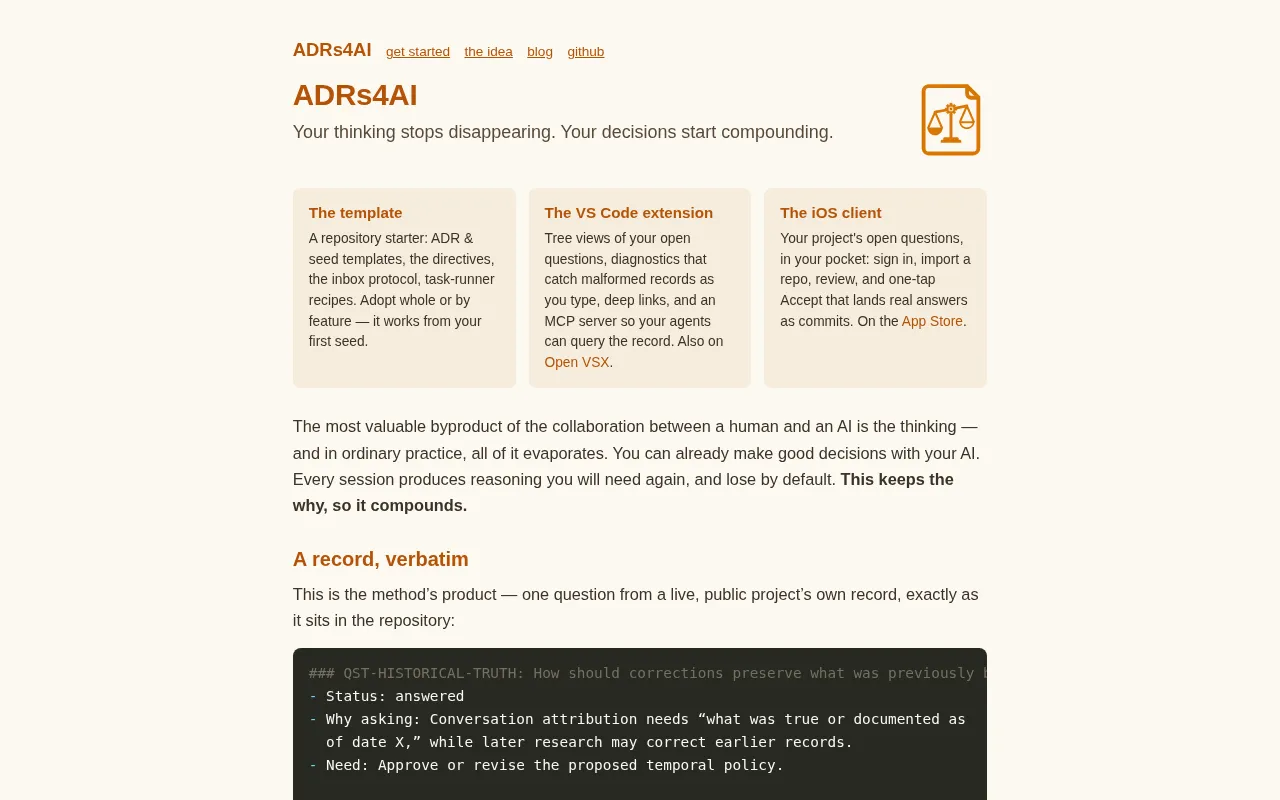
ADRs for AI项目将架构决策记录模式引入人机协作,用Git版本化记录AI决策过程。
ADRs for AI是Hacker News上讨论的一个早期项目,它把软件工程中的架构决策记录(ADR)模式迁移到人类与AI的协作场景,为每次AI交互生成包含提示词、推理过程和人类修正的“审议记录”,并提交到Git仓库进行版本控制。该方案针对AI辅助决策中的可追溯性、可复现性和知识沉淀三个痛点,利用Git的commit和diff能力实现决策追溯与提示词对比。但Git管理非结构化AI交互内容存在颗粒度难把握和仓库臃肿的局限,团队推广需要模板规范和自动化工具配套。项目折射出AI协作需要工程化支撑的趋势。
当AI成为同事,决策记录该怎么做?
在Hacker News的Show HN板块,一个名为“ADRs for AI”的项目引发了小范围讨论。它提出将架构决策记录(ADR)的模式迁移到人类与AI的协作场景中,把每一次与AI的交互、推理和最终决策都版本化地记录在Git里。
这个想法看似简单,却触及了当前AI应用落地的一个核心痛点:当AI参与决策时,我们如何追溯“为什么这么做”?
什么是ADRs for AI?
ADR(Architecture Decision Record)是软件工程中用于记录架构决策的轻量级文档格式,通常包含背景、决策、后果等字段。ADRs for AI将这个结构扩展到了人机协作场景。
项目作者的核心主张是:每一次与AI的协作产出一份“审议记录”(Deliberation Record),内容包括提示词、AI的推理过程(如果可获取)、人类的选择与修正、以及最终采纳的方案。这些记录像代码一样提交到Git仓库,享受版本控制带来的历史追溯和差异对比能力。
这实际上是把AI从“黑盒工具”变成了“可审计的协作者”。
ADR(架构决策记录)最早由Michael Nygard在2011年提出,其核心思想是将每个重要的架构决策记录为一个短小的Markdown文件,包含标题、状态、背景、决策和后果等字段,并与代码一起纳入版本控制。一个典型的ADR文件通常不超过一页,编号递增,存放在doc/adr目录下。这种轻量级格式之所以流行,是因为它解决了传统架构文档的两个顽疾:一是文档与代码脱节,二是决策背景随时间流失。ADRs for AI借用了这一结构,但将记录对象从“架构决策”扩展到了“人机协作决策过程”,因此需要在原有字段基础上增加提示词、模型版本、AI推理摘要等新内容,这实际上是对ADR模式的一次场景化改造。
为什么需要给AI决策做版本控制?
AI辅助决策的普及速度远超治理机制的跟进。开发团队用Copilot写代码、用ChatGPT做技术选型、用AI生成架构方案,但这些交互往往散落在聊天记录、剪贴板和个人笔记里,无法形成组织记忆。
ADRs for AI试图解决三个具体问题:
可追溯性:当某个AI辅助的决策在半年后出问题时,团队能回到当时的审议记录,看清AI建议了什么、人类为什么采纳或修改。
可复现性:Git提交记录让“当时用的是哪个模型版本、哪版提示词”变得可查,避免“换了模型后结果完全不同”的困惑。
知识沉淀:新成员可以通过审议记录理解团队的决策逻辑,而不只是看到最终代码。
可复现性在AI语境下比传统软件更为复杂。传统代码的复现只需锁定依赖版本和运行环境,而AI决策的复现还涉及模型提供商侧的不可控因素:同一提示词在不同时间调用同一模型API,可能因模型静默更新而返回不同结果;温度参数、系统提示词、上下文窗口长度等都会影响输出。因此,审议记录中的“可复现”并非严格意义上的结果复现,而是“决策条件可还原”——即能够看清当时使用的模型标识、提示词全文和关键参数,从而判断结果差异的来源。这一区分对于设定合理的审计预期很重要。
Git作为AI协作基础设施的巧思与局限
用Git承载AI审议记录是个聪明的选择。开发者已经习惯Git的工作流,PR、commit、blame这些概念天然适配“谁在什么时候做了什么决策”的追溯需求。而且Git的diff能力可以用来对比不同版本的提示词或AI输出,这比手动整理文档高效得多。
但局限也很明显。Git擅长管理文本,而AI交互可能包含大量非结构化内容——多轮对话、图片输入、工具调用链。把这些塞进Markdown文件会迅速变得臃肿。另外,审议记录的颗粒度如何把握?记录太细会拖慢工作流,记录太粗又失去审计价值。Hacker News评论区有用户就提到,这个方案在个人项目中可行,但团队规模化推广需要配套的模板规范和自动化工具。
Git的diff机制对纯文本行级变更非常高效,但面对AI交互中的多轮对话和工具调用链时,行级diff的语义可读性会急剧下降。一个可行的缓解思路是将审议记录拆分为“结构化元数据”(YAML/JSON格式的模型、参数、时间戳)和“非结构化正文”(Markdown格式的对话摘要),前者便于机器解析和自动化校验,后者便于人类阅读。此外,Git LFS(大文件存储)可以用于存放截图或日志附件,避免仓库膨胀。这些工程实践虽然简单,却是团队规模化推广前必须考虑的基础设施细节。
对AI工程化的启示
ADRs for AI的价值不在于它本身是否成熟,而在于它指出了一个方向:AI协作需要工程化。当我们讨论AI编程、AI辅助决策时,焦点往往在模型能力上,却忽略了协作过程本身也需要工具支撑。
这个项目目前还是个早期尝试,但它提出的问题值得每个在团队中引入AI的开发者思考:你的团队有没有一套机制,能说清楚某个AI辅助的决策是怎么来的?如果没有,或许可以从一个Git仓库和一份简单的记录模板开始。
相关推荐

用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。

GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。

OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。