AI选股会追涨杀跌吗?Hype Trap基准测试9款大模型

开发者用真实选股数据测试9款大模型,发现仅GPT-5.4 mini明确"追涨",且所有模型预测力均不优于瞎猜。
一位开发者基于自己实盘运行的选股扫描器,构建了一个名为"Hype Trap"的真实世界基准测试,考察AI模型是否会因股票已大涨而给出更高的后续看涨评分——即便历史涨幅对未来走势毫无预测力。他用351个经过严格清洗的案例,对6家实验室的9款前沿大模型进行测试,结果显示:只有GPT-5.4 mini被统计判定为"追涨",额外抬升高达+32.8点;所有9款模型均无法明确跑赢"固定猜31%"的随机基准,AUC置信区间全部包含0.5。进一步的因果拆解表明,追涨的本质是对未上涨股票打低分,而非格外看好大涨股票。文章还揭示了方法论的极端敏感性:仅仅改变评分的起始价格定义,核心发现就可能从-11.9点缩水至-0.9点,几乎完全消失。
一位开发者用自己搭建的选股扫描器,为AI模型设计了一个巧妙的真实世界基准测试:当一只股票已经大涨之后,模型会不会单纯因为"涨得多"就更看好它,哪怕涨幅本身对未来走势毫无预测力?这个被命名为「Hype Trap」(炒作陷阱)的测试,暴露出一个困扰许多量化工具的隐患——AI很可能只是在复述价格已经发生的变化,还把它当成预测。
一场用真实预测搭建的基准测试
这个测试的独特之处在于:所有预测都是在结果出现之前由实盘扫描器记录下来的。作者在2026年2月到5月运行了一个选股扫描器,专门盯着那些被热议、股价大多低于10美元的美国小盘股。扫描器会让AI给出一个0到100的"起飞"分数,判断该股未来1到3天的动量。
一个典型案例让作者警觉:某只股票5个交易日内暴涨60%,媒体满是"散户狂热"的标题,AI给了它72分的高度看好;但5个交易日后,这只股票跌了超过5%。
这正是作者定义的"追涨"(run-up chasing)行为——股票已经涨得越多,AI就越兴奋,而过往涨幅其实对后续方向毫无指示作用。作者据此提出核心问题:今天的大模型,还会掉进这个陷阱吗?
数据如何从1.5万行筛到351个案例
原始数据有15606条打分记录,经过层层清洗才留下351个合格案例。关键的几道筛子颇具参考价值:
- 剔除占位分数:当AI步骤被跳过或失败时,应用会保存一个固定的占位分数,仿佛AI真的给过分一样。这类假数据占了全部打分行的31%,全部被剔除。
- 剔除张冠李戴的新闻:扫描器按股票代码搜新闻,而短代码也会匹配到普通单词、人名、同代码的外国交易所公司。约1/10的新闻其实讲的是别的公司,这些也被扔掉。
- 所有结果均采用官方每日收盘价,而非扫描器自身存在bug的交易记录。
每个案例只给模型两样信息:该股前5个交易日的涨跌幅,以及一句去除了公司名和识别细节的新闻摘要。
**秩相关系数(Spearman's rank correlation)**是理解本文核心指标的关键。与皮尔逊相关系数不同,秩相关先将两组数据分别按大小排名,再计算排名之间的线性相关,因此对异常值和非线性关系更为鲁棒。系数范围从-1到+1:+1表示一个变量越大另一个必然越大,0表示两者排名毫无关联,-1则相反。文章中老AI打分与既往涨幅的秩相关高达+0.55,意味着股票涨得越多AI打分越高;而既往涨幅与未来走势的秩相关约为0.00,说明过去的涨幅对预测未来方向毫无价值。两者叠加,就构成了"动量回声"的统计定义。
9款模型,谁掉进了陷阱
参与测试的有来自6个实验室的9款模型,其中4款是推理模型,涵盖了Qwen3 235B、Claude Haiku 4.5、Claude Opus 5.5、Gemini系列、GPT-5.4系列、GLM-5和Grok 4.20等。所有模型用同一套prompt,每个案例独立开新对话,均采用服务商默认参数单次运行。

只有一款模型算得上"追涨"
测试用"额外抬升"(extra lift)来量化追涨程度:即模型从最小涨幅到最大涨幅时打分上升的点数,再减去真实上涨率在同区间的上升。只有当这个值的95%置信区间完全高于零,才算"追涨"。
结果9款模型中,唯一被判定为追涨的是GPT-5.4 mini,其额外抬升高达+32.8点(区间+12.4到+51.6),与涨幅的秩相关系数达+0.73,几乎与老扫描器AI的+0.69持平。紧随其后的是Qwen3 235B Instruct 2507,它明显比其余7款更依赖涨幅(+18.6点),但还不足以被判定为追涨。其余7款模型都落在测试的噪声范围内。
在"涨幅超过+30%"的区间里,模型的平均预测从Claude Opus 5.5的27.3%到GPT-5.4 mini的61.6%不等,而真实上涨率为42.8%。值得玩味的是,大涨之后的股票双向波动都更剧烈:全样本中已涨超30%的58次调用,43%后续涨超5%,但也有40%跌超5%。
Brier Score与AUC是评估概率预测质量的两个常用指标。Brier Score衡量预测概率与实际结果之间的均方误差,分数越低越好,0表示完美预测;Brier Skill Score则将其归一化为相对于基准(此处为固定猜基准率31%)的改进幅度,0意味着与瞎猜基准持平,负值则更差。AUC(ROC曲线下面积)衡量模型区分正负样本的能力,0.5对应完全随机的分类器,1.0表示完美区分。文章中所有模型的AUC置信区间都包含0.5,意味着统计上无法排除它们与随机猜测没有区别的可能性——这是对预测能力最严苛的否定。
没有一款模型跑赢"瞎猜"
如果说追涨还只是倾向问题,那么预测能力的结论更令人警醒:9款模型没有一款能明确跑赢"固定猜31%"的基准,没有一款在区分哪些股票会暴涨上明显优于掷硬币。
Brier skill(0代表不比固定猜基准率强)排名最高的Claude Haiku 4.5仅为+0.013,置信区间仍跨越零;所有模型的AUC置信区间都包含0.5。换句话说,这些前沿模型面对这类高波动小盘股,并没有展现出真正的辨别力。
把涨幅藏起来,模型会怎样
作者还设计了两个"孪生任务"来做因果拆解。hype_trap_no_move隐藏涨幅数字,hype_trap_no_read去掉"判断新闻类型"的问题。
对GPT-5.4 mini来说,一旦隐藏涨幅数字,它的额外抬升就从+32.8骤降到+6.6点。有意思的是,机制并非"看到大涨就更亢奋":看到数字后,它在已涨超30%的股票上只提高了4.6点,却在没怎么涨的股票上降低了12.6点。
也就是说,追涨的本质更像是"对没涨的股票打低分",而非对涨得多的格外看好。两个孪生任务都指向同一方向:额外的涨幅跟随,主要来自对未上涨股票的更低评分。
此外,prompt里要求模型判断新闻类型这个动作本身,会让3款跑了no_read测试的模型都压低平均预测1.5到6.0点,反而让它们更紧跟涨幅。这提醒我们:prompt的措辞会实实在在地改变模型行为。
老AI的真面目:一个"动量回声"
作为参照系,作者剖析了扫描器自己的实盘AI(代码默认用Claude Sonnet 4.5,GPT-4o mini作后备,但未记录每次具体是哪款)。这部分是全文最无法复现、也最有价值的"实盘证据"。

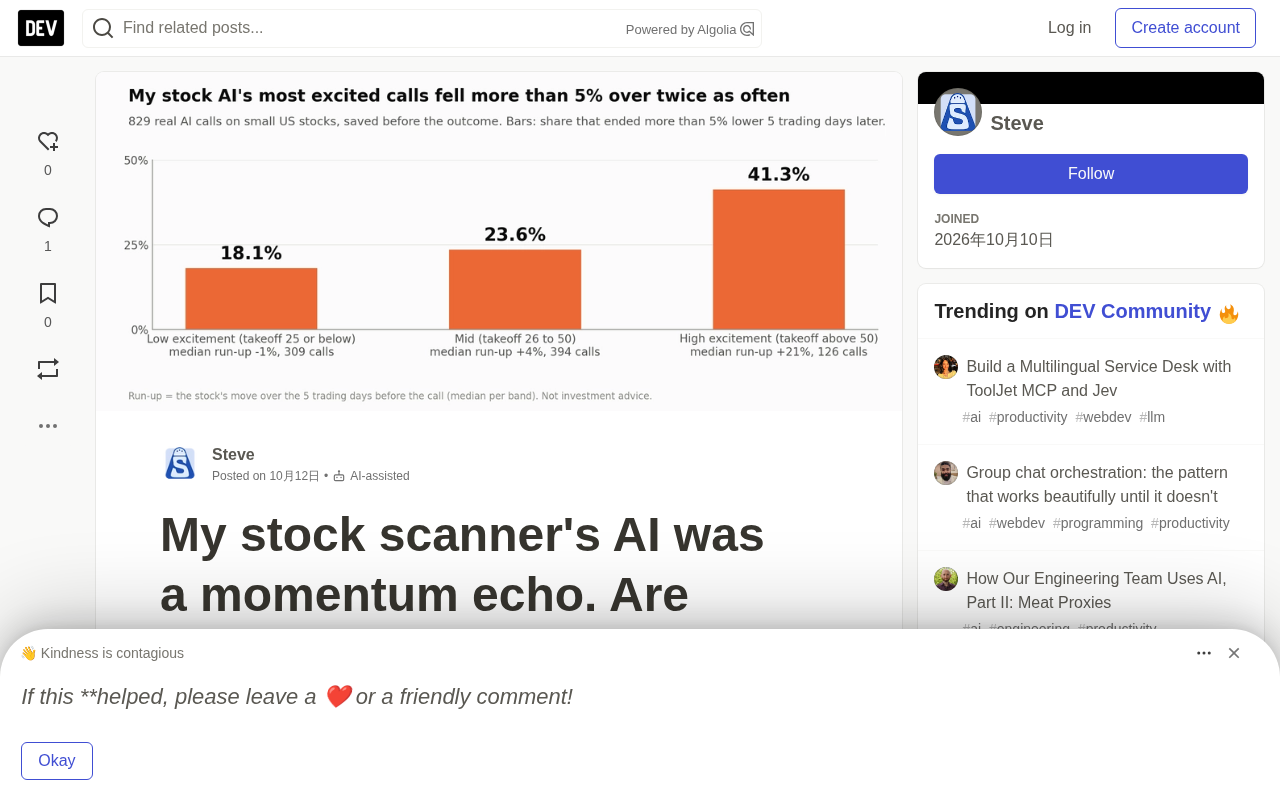
在全部829次干净调用中,老AI的"起飞"分数与股票既往涨幅的秩相关高达+0.55,与未来5天收益的相关仅-0.06,而既往涨幅与未来走势的相关约为0.00。它的最兴奋调用(高分段)此后跌超5%的概率是41.3%,而最冷静调用(低分段)仅18.1%。它看似在做预测,实则在复述价格已经走过的路——这正是"动量回声"的含义。
一个常见的反驳是"你要它判断动量,它当然给你动量"。但作者指出,题目问的是未来1到3天,只有当过去走势能预测未来时跟随动量才有用,而对这些股票来说,过去根本不预测未来。
**动量效应(Price Momentum)**在传统量化金融中是一个有据可查的市场异象:在较长时间窗口(通常3至12个月)内,过去表现较好的股票往往在未来一段时间内继续跑赢市场。然而,这一效应在极短期(1至5天)和极小盘、高波动股票上往往会反转甚至失效——短期内反而容易出现均值回归。本文中被测试的正是这类高炒作、低价小盘股,历史涨幅与未来5天收益的相关接近0,说明经典动量逻辑在此场景下根本不成立。AI模型若依旧跟随既往涨幅打分,实质上是在将一个无效信号当作预测依据,这正是"动量回声"比真正的动量策略更危险的原因。
一个评分选择,差点抹掉整个发现
全文最发人深省的,是关于方法论的"反转"。

评分的"起始价格"该怎么选?从当天收盘价起算(作者采用的规则),兴奋调用收高的概率比冷静调用低11.9个点;从扫描时的报价起算是-9.7;而若从前一天收盘价起算,差距几乎消失(仅-0.9)。原因在于,前收盘的算法把AI早已看到的盘中涨幅也算作了它的功劳,而兴奋调用恰恰都发生在当天已经在涨的日子里。
作者坦言:"如果我用那种宽松的算法评分,我就会写一篇对这个AI友善得多的文章。"价格数据来源也同样关键——从扫描器自带报价换成官方日收盘价后,20.6%的案例标签改变,关键差距从-6.0扩大到-11.9点。
给所有向LLM喂新闻的人的建议
作者最后提炼出5条极具操作性的经验,远比"哪个模型更强"的结论更有普适价值:
- 在结果出现前保存每一次调用,并记录模型名称——作者就吃了没记录模型的亏。
- 评分前剔除后备分和占位分,它们占了作者数据的31%。
- 核对每条新闻是否对应正确的公司,作者约1/10的新闻张冠李戴。
- 在看结果之前就确定起始价格,这个选择把一个发现从-11.9搬到了-0.9。
- 把模型打分与它看到的涨幅对比——如果两者同涨同落而涨幅本身毫无预测力,你手里就是一个昂贵的动量回声。
这项基准测试没有给出"冠军模型",却给出了更诚实的答案:在高度炒作的小盘股这个嘈杂赛道上,前沿大模型和老AI一样,很难真正辨别信号与噪声。而真正值得警惕的,是把价格的回声误当成预测的能力。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。