AI验证系统降本困局:如何少读证据又不漏掉关键信息
AI验证流水线的真实成本瓶颈在于"必须读多少证据",而非检索本身,提前截断会系统性地牺牲关键少数派证据。
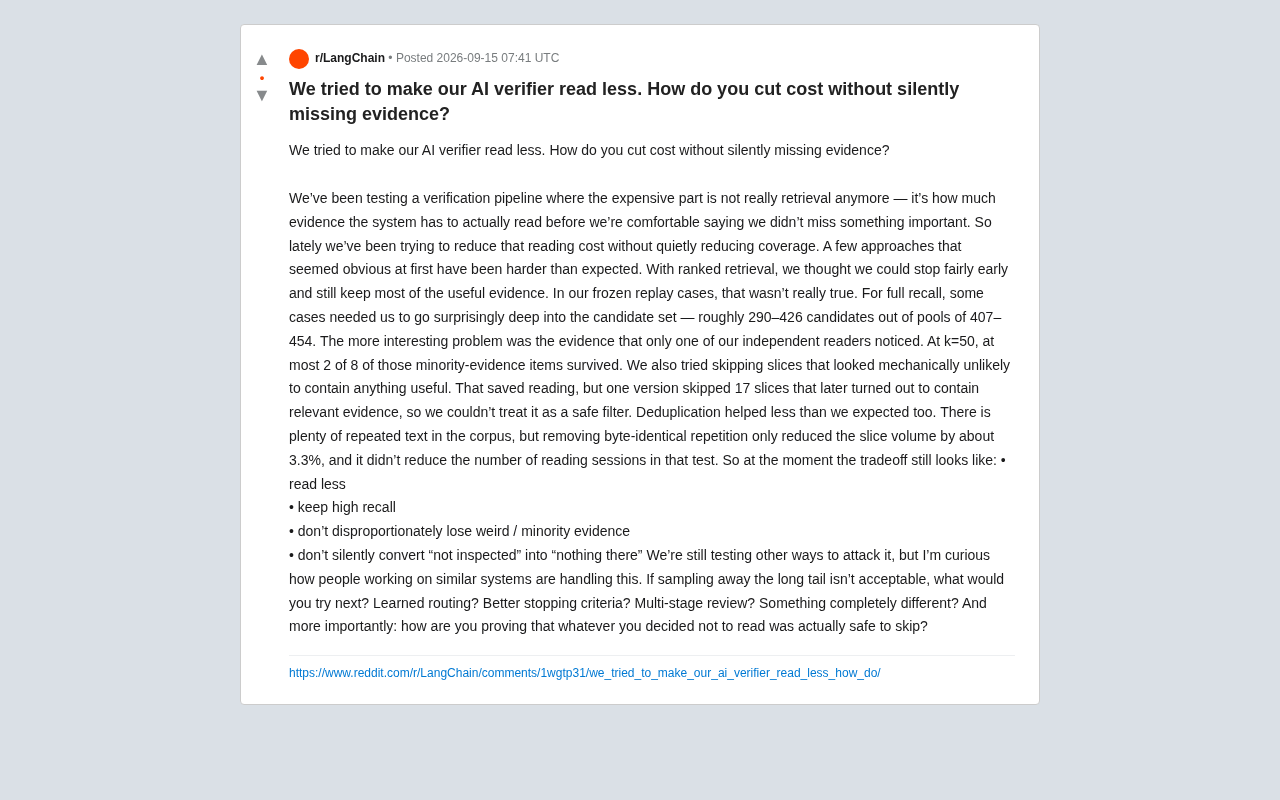
一个工程团队在构建AI事实核查流水线时发现,系统成本的主要来源已从检索转移至"阅读证据"环节,而所有降低阅读量的尝试都面临一个共同的深层矛盾。排名检索并不能保证提前停止的安全性——实测中部分案例需要读取454个候选中的426个才能实现完整召回。激进截断策略最先牺牲的是"少数派证据",即只被单个阅读器捕捉到的边缘但可能关键的信息;跳过低概率切片和去重两种机械优化的实际收益也远低于预期,去重仅减少3.3%的切片体积且完全未减少阅读会话数。团队将核心困境归结为一个无法回避的证明责任:如何严格证明"决定不读的部分确实可以安全跳过",而不是悄然将"未检查"等同于"无内容"。
在构建AI验证(verification)流水线时,一个反直觉的成本瓶颈正在浮现:真正昂贵的环节已经不再是检索(retrieval),而是系统在确信"没有遗漏重要信息"之前,必须实际阅读多少证据。一位工程师在Reddit上分享了他们团队尝试削减这部分"阅读成本"的实践,暴露出几个看似简单实则棘手的问题。
这个话题触及了RAG(检索增强生成)与自动化事实核查系统的核心矛盾:读得越少越省钱,但覆盖率一旦悄然下降,系统就可能把"没检查过"错误地转化为"这里什么都没有"。
提前停止:排序检索的假象
团队最初的假设很直接——既然采用了排序检索(ranked retrieval),高价值证据应该集中在前列,那么在读到一定深度后就可以停止,仍能保留大部分有用证据。
但在"冻结重放"(frozen replay)的测试场景中,这个假设并不成立。为了实现完整召回(full recall),部分案例需要深入到候选集相当靠后的位置——大约要读取407至454个候选中的290到426个。换句话说,为了不漏掉证据,系统几乎要读完整个候选池,提前停止节省的成本远低于预期。
这一发现直接挑战了"好的排序模型能让你早停"的普遍信念。当证据分布并不服从理想的长尾集中规律时,排序质量本身并不能保证覆盖率。
排序检索(ranked retrieval)通常依赖BM25、双塔模型或交叉编码器(cross-encoder)等机制,将与查询最相关的文档或切片排在前列。其背后的隐含假设来自信息检索领域的"精度-召回曲线"直觉:相关文档应集中分布在排名靠前的位置,读取前k个即可覆盖绝大多数有价值信息。然而,这一假设成立的前提是相关性分布呈现明显的头部集中特征。在事实核查场景中,证据往往分散于语料库的不同来源和格式中,某条关键反驳证据可能因措辞偏差而被排序模型低估,导致它沉降到候选列表的深处。"冻结重放"测试之所以能揭露这一问题,是因为它固定了检索结果集合,消除了随机性,让研究者可以精确统计"至少要读到第几位"才能不遗漏证据——这种离线评估方法本质上是在测量排序模型的证据覆盖上界。
少数派证据:最容易被牺牲的部分
更棘手的问题出现在"少数派证据"(minority evidence)上——那些只有一个独立阅读器(reader)注意到的信息。
在k=50的设置下,这类少数派证据项中最多只有8个里的2个能够"幸存"下来。这意味着,任何激进的截断策略都会不成比例地损失那些"奇怪的"、边缘的、但可能至关重要的证据。
这正是自动化验证系统最危险的失效模式:主流证据往往冗余出现、容易命中,而真正决定结论正确性的,可能恰恰是那条唯一被单个reader捕捉到的线索。当系统为了降本而对长尾进行采样丢弃时,它牺牲的往往就是这部分难以复现的关键信息。
在多reader并行架构中,系统通常会将候选文档集分配给多个独立的阅读器(reader)进行并行处理,最终汇总各reader的发现。"少数派证据"指的是只被单个reader标记为相关、而其他reader均未注意到的信息。这种现象在集成学习(ensemble)框架中被称为"低共识信号",它的存在本身就说明该证据处于语义边界地带——它与查询的关联方式非典型,难以被标准相关性模型稳定捕捉。k=50的设置意味着每个候选切片平均被50个reader中的某个处理,少数派证据在统计上的"幸存"依赖于至少一个reader的覆盖。当截断策略压缩读取总量时,这类低频命中的边缘证据首先从系统视野中消失,而它们往往恰好对应着被核查陈述中最脆弱、最容易出错的部分。
跳过切片与去重:收益有限的优化
团队还尝试了两种更"机械"的优化手段,结果都不理想。
跳过低概率切片:他们试图跳过那些从机械特征上看不太可能包含有用信息的切片(slices)。这确实节省了阅读量,但其中一个版本跳过的17个切片,事后被证明包含相关证据。既然存在漏检风险,这就无法被当作一个"安全过滤器"来使用。
去重(Deduplication):语料库中确实存在大量重复文本,直觉上去重应该能显著减少工作量。但实际测试中,移除字节级完全相同的重复内容只减少了约3.3%的切片体积,而且完全没有减少阅读会话(reading sessions)的数量。冗余文本的存在并不等于可以安全跳过的阅读负担。
核心权衡:四个无法同时满足的目标
综合这些实验,团队将困境归纳为一组需要同时满足、却相互冲突的约束:
- 读得更少(降低成本)
- 保持高召回率(不漏证据)
- 不成比例地丢失奇怪的/少数派证据
- 不悄然把"未检查"转化为"什么都没有"
最后一条是整个问题的灵魂。任何降本方案都容易在指标上看起来不错,因为被跳过的内容默认被当成了"空"。而真正的挑战不在于决定跳过什么,而在于——如何证明你决定不读的那部分,确实可以安全跳过。
这四条约束之间的张力在形式上类似于数据库领域的CAP定理——在分布式系统中,一致性、可用性和分区容错性无法同时保证。在高召回验证系统中,"低成本"与"完整覆盖"之间存在结构性冲突,而"不悄然把未检查转化为无内容"这一条尤为隐蔽:大多数评估指标(如准确率、F1)无法区分"系统检查后认定无相关证据"和"系统根本没有检查"这两种情况,导致降本优化在指标层面看起来无损,实则已经引入了系统性盲区。这种"沉默的覆盖率下降"在法律文档核查、医疗证据审查等高风险场景中尤为危险,因为漏检的代价往往是不对称的——错过一条关键反驳证据的代价,远大于多读几十条冗余文档的成本。
可能的方向与开放性问题
发帖者列出了几条仍在探索的路径,并向社区征求意见:
- 学习式路由(Learned routing):训练模型动态决定哪些内容值得深入阅读。
- 更好的停止准则(Stopping criteria):不再依赖固定的k值,而是基于证据充分性的动态判断。
- 多阶段审查(Multi-stage review):先粗筛再精读,用分层结构控制成本。
但无论采用哪种方案,最关键的验证问题始终悬而未决:怎样才能拿出证据,证明被跳过的内容是安全的?如果对长尾进行采样丢弃是不可接受的,下一步该怎么走?
这是一个对所有构建检索验证、合规审查、法律文档核查等高召回要求系统的团队都极具现实意义的难题。它提醒我们:在AI系统的降本优化中,"看起来省了钱"和"真的没漏东西"之间,隔着一道需要严格证明的鸿沟。
相关推荐
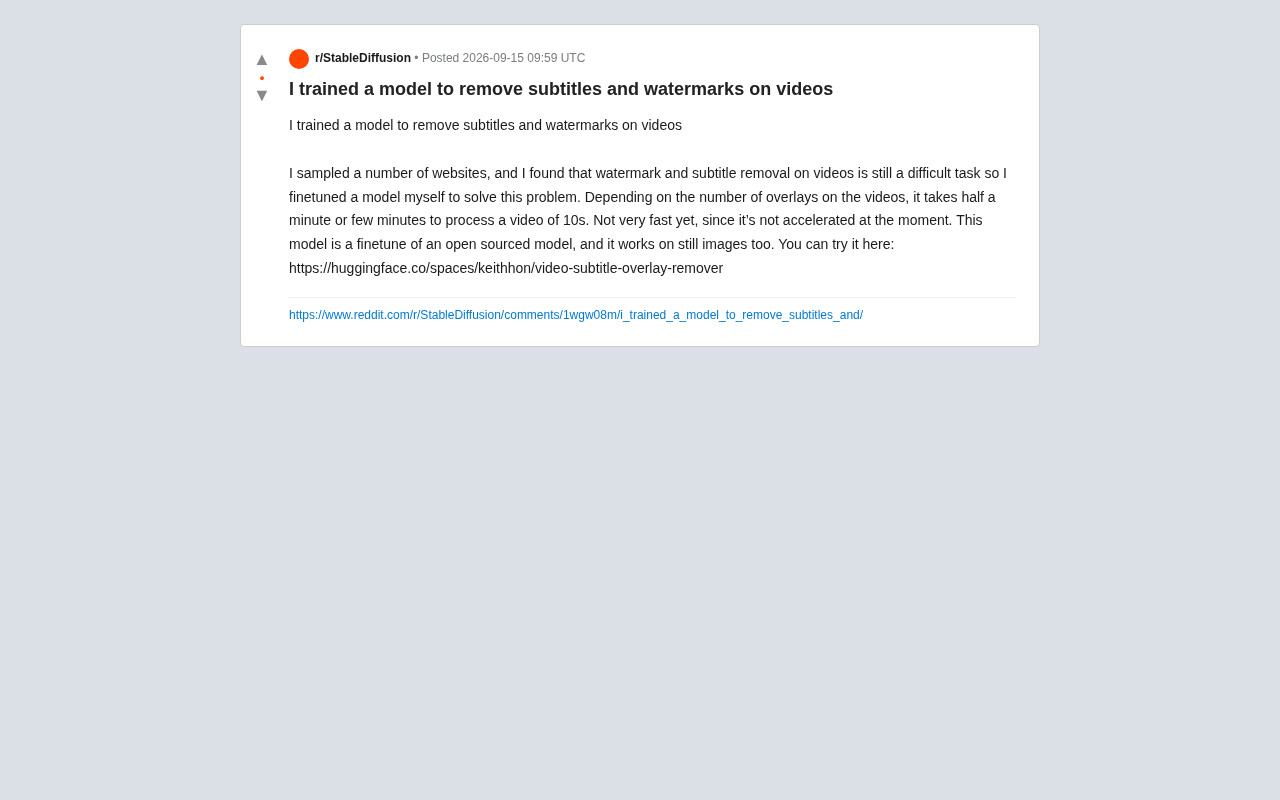
开发者微调AI模型实现视频字幕与水印去除
一位开发者微调开源模型,实现视频字幕与水印去除功能,支持图片处理,已部署在Hugging Face上开放试用。本文解析其实现思路、性能表现与应用争议。
Salesforce联手英伟达推Koa模型:企业AI的开源突围
Salesforce与英伟达联合推出基于开放权重模型Nemotron的推理模型Koa,专注销售、营销和客服场景。本文分析这一垂直化AI策略为何值得通用大模型实验室警惕,以及它对行业格局的启示。
H3加速竞技场新增三款模型:社区众测AI性能
H3加速竞技场新增VDN-H3、TaoMate H3、LightX2V 1.2三款模型,通过社区投票对比新旧模型加速表现。本文解析众测评测机制及其参考价值。