AI引用实测:这些SEO老套路对AI Agent完全失效
B2B从业者数周实测揭示:meta描述优化无效、人工制造Reddit引用适得其反,解释性内容结构才是AI引用的关键杠杆。
一位B2B领域的AI可见性优化从业者在Reddit分享了持续数周的实验结果,核心发现与传统SEO直觉多处相悖。实验表明,精心优化的meta描述对AI引用几乎毫无效果,因为AI检索依赖的是页面正文的语义内容而非摘要片段;试图通过自动化服务在Reddit"制造"品牌引用的尝试,迅速被社区识别为垃圾信息并遭到惩罚;而将"十大工具清单"改写为"如何评估工具、关注哪些标准"的解释性结构后,AI引用频率显著提升。这些发现共同指向一个更根本的视角转变:AI SEO应被理解为"查询→检索→来源选择→答案生成→引用"的多环节链条,而非传统排名优化的简单延伸。来源权威性与内容语义质量在链条中各自的权重,仍是该领域有待实证的核心问题。
当传统SEO撞上AI检索:一场为期数周的实验
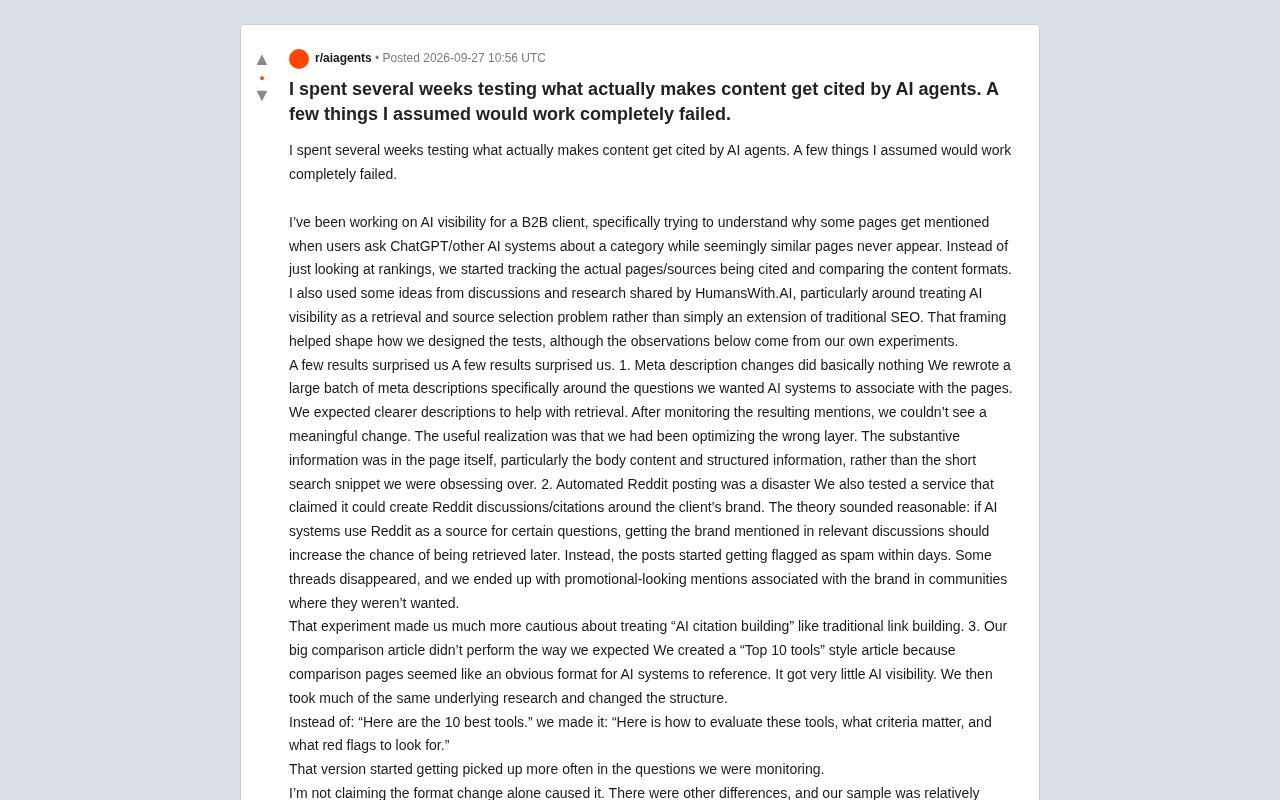
一位从事B2B客户AI可见性优化的从业者,在Reddit上分享了他们持续数周的实测结果。核心问题很直接:当用户向ChatGPT等AI系统询问某个品类时,为什么有些页面会被引用,而看似相似的页面却从不出现?
与传统只盯着排名的做法不同,这个团队转而追踪AI实际引用的页面和来源,并对比这些内容的格式差异。他们借鉴了 HumansWith.AI 讨论中的一个关键框架——把AI可见性当作检索与来源选择问题来处理,而不是简单地把它看作传统SEO的延伸。这个视角深刻影响了整套测试的设计思路。
实验结果中有几项,与他们最初的假设完全相反。
三个被证伪的假设
Meta描述优化:几乎毫无作用
团队最初的直觉是:如果把meta description改写得更贴合用户想问的问题,AI系统检索时应该更容易关联到这些页面。他们为此批量重写了大量meta描述,围绕目标问题精心设计。
然而监测引用变化后,结果令人失望——看不出任何有意义的提升。
真正有价值的领悟在于:他们一直在优化错误的层级。实质性的信息其实存在于页面正文和结构化内容当中,而非那段他们反复打磨的搜索摘要。对AI检索而言,短短的snippet远没有页面本体的内容重要。这一点对习惯了传统SEO的从业者来说,是个不小的认知修正。
自动化Reddit引用:一场灾难
第二个实验更具警示意义。团队测试了一项声称能围绕客户品牌"制造"Reddit讨论和引用的服务。理论听起来合理:既然AI系统在回答某些问题时会引用Reddit内容,那么让品牌出现在相关讨论中,理应提升日后被检索的概率。
现实是残酷的。这些帖子在几天内就被标记为垃圾信息,部分讨论串直接消失,最终留下的是一堆看起来像广告、且出现在并不欢迎它们的社区里的品牌提及。
这次失败让团队对"AI引用建设"这个概念变得极为谨慎——它绝不能像传统的外链建设那样操作。人为制造的痕迹在社区生态里会被迅速识别并惩罚,反而损害品牌形象。
对比清单文章:表现不及预期
第三个发现或许最具启发性。团队制作了一篇"十大工具"式的对比文章,因为对比页面看起来是AI系统天然愿意引用的格式。但它的AI可见性极低。
随后,他们用大致相同的底层研究,只改变了结构——从"这是十款最佳工具"改为"如何评估这些工具、哪些标准重要、要警惕哪些危险信号"。
改版后的这篇内容,开始在他们监测的问题中被更频繁地引用。作者坦诚这不是严谨的对照实验:格式之外还有其他差异,样本量也不大。但差距足够明显,以至于团队现在开始更有意识地测试内容结构。这暗示了一个方向:AI系统可能更青睐解释判断逻辑的内容,而非单纯罗列结论的清单。
重新理解"AI SEO":从排名到检索链条
这些实验把作者引向了一个更根本的问题:我们是不是从一开始就想错了"AI SEO"这件事?
在传统搜索里,围绕排名因子做优化是可以理解的。但面对AI系统,作者认为更有用的思考框架是这样一条链条:
查询(query)→ 检索(retrieval)→ 来源选择(source selection)→ 答案生成(answer generation)→ 引用(citation)
这个框架的价值在于,它把"如何让页面排名靠前"这个单点问题,拆解成了多个环节。而作者当前正在试图厘清:这条链条中,究竟哪些部分是发布者真正能够掌控的?
Meta描述的失败、Reddit操纵的翻车、内容结构的意外见效,恰好对应着这条链条上不同环节的不同权重。它们共同指向一个结论:影响AI引用的杠杆,与传统SEO并不重合。
这条检索链条背后,是当前主流AI问答系统普遍采用的**RAG(检索增强生成)**架构。RAG的基本工作方式是:当用户提出问题时,系统首先通过向量检索从外部知识库中召回若干相关文档片段,再将这些片段作为上下文喂给大语言模型生成回答,并标注来源。这意味着一个页面能否被引用,至少涉及两道独立的门槛:第一,内容是否被纳入系统的检索索引,以及在向量空间中与目标查询的语义相似度是否足够高(对应"检索"环节);第二,被召回后是否被模型判断为高质量、可信赖的来源(对应"来源选择"环节)。传统SEO主要影响搜索引擎的爬取与排名,而RAG管道的每个环节都有独立的评分逻辑,这正是为什么meta description优化在AI引用场景下几乎失效——它能影响传统搜索的点击率呈现,却几乎不参与语义向量的计算过程。
悬而未决的核心问题
作者在帖子结尾抛出了一个值得整个行业思考的问题,特别是面向那些构建AI Agent或从事检索系统工作的人:
在实际系统中,来源权威性/声誉与被检索内容的语义质量、结构,各自占多大权重?
他特别希望听到的,是那些用自己的数据集做过实测的人的经验,而不是SEO理论层面的空谈。这个提问本身,反映出当前"AI可见性优化"领域的一个真实困境:大量建议停留在推测和类比传统SEO的阶段,真正基于检索系统内部机制的实证却相当稀缺。
对于正在关注这一领域的内容创作者和营销人员,这次实验至少提供了几条务实的启示:把精力从摘要转向正文实质内容、放弃投机取巧的人为引用制造、以及用解释性结构而非纯清单来组织内容。至于来源权威与内容质量孰轻孰重,答案恐怕还需要更多来自一线的数据来验证。
"来源权威性"在AI引用中的作用机制,目前存在两种可能的路径:一是训练数据层面的隐式权重——如果某个域名在预训练语料中大量出现且被高频引用,模型可能在参数层面就对其赋予更高的可信度;二是检索系统层面的显式过滤——部分RAG系统会在召回阶段引入类似PageRank或域名白名单的信号,直接影响哪些内容有资格进入候选池。这两种路径对优化策略的含义截然不同:前者意味着权威性是长期品牌积累的结果,短期难以干预;后者则意味着可能存在某些结构化信号(如Schema标记、作者信息、HTTPS、引用数量)能够被检索层识别。目前公开披露检索系统内部机制的AI产品极少,这也是作者在帖子结尾特别向AI Agent和检索系统从业者求证的原因。
相关推荐

xAI的Agent优势:把X实时数据变成模型工具
解析xAI为Grok打造的Agent能力:将X实时数据与Web作为模型工具,支持服务端工具调用、OpenAI兼容API和Beta多Agent架构。深入剖析其作为实时工具层的优势与作为完整Agent操作系统的不足。

Agent Gateway 接入 Cloud Trace:AI智能体请求的端到端追踪
Google Cloud 的 Agent Gateway 现已集成 Cloud Trace(预览阶段),可将一次 AI 智能体请求的智能体、网关、工具与 MCP 服务器全部调用收拢到同一条端到端追踪链路,基于 OpenTelemetry 标准实现,帮助开发者精准定位性能瓶颈。
OpenAI遭遇黑客入侵 Altman面临法律风险累积
OpenAI在内部调查中发现系统遭黑客入侵,CEO奥特曼同时面临法律风险累积。本文梳理AI公司数据安全隐患、企业治理争议与合规挑战,分析事件背后的行业启示。