AI与科学公地的圈地运动
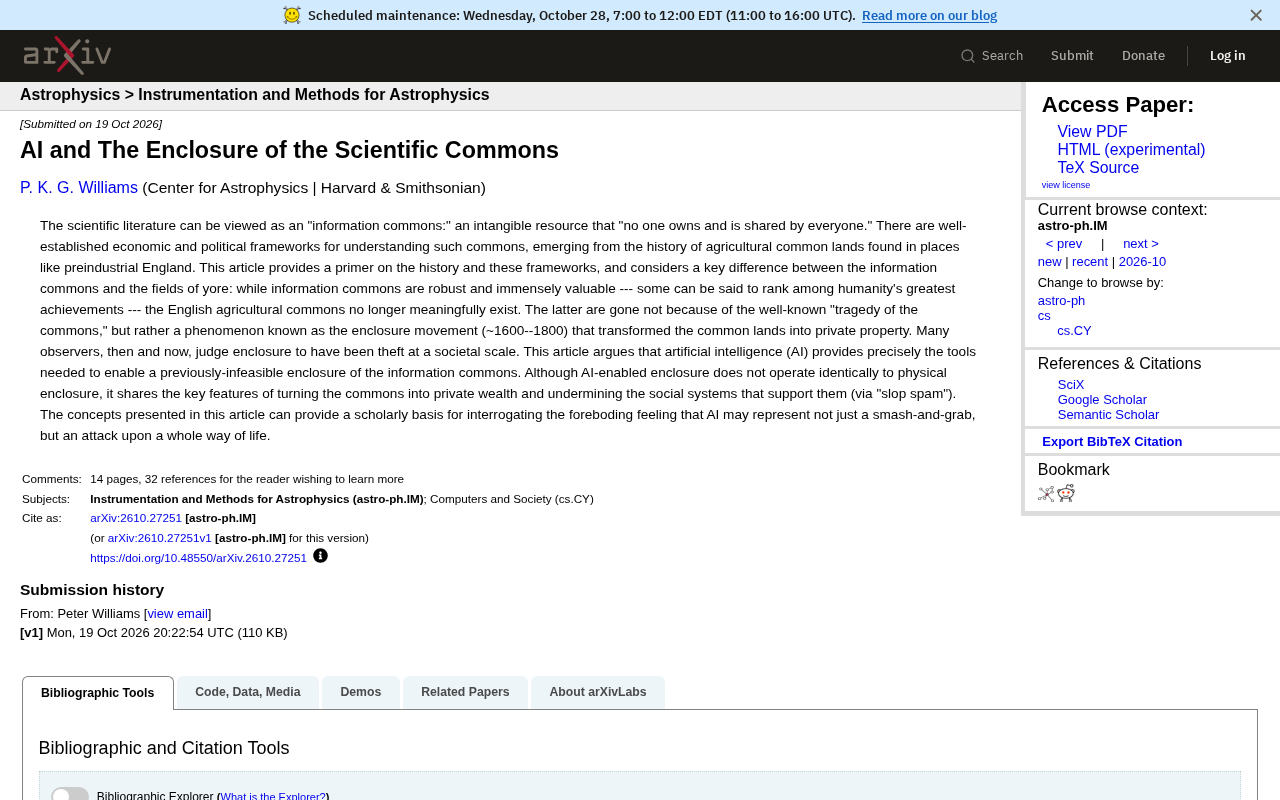
AI正以数据私有化、模型不透明和评价偏移三重方式圈占科学公地,侵蚀科学的公共属性。
文章借「圈地运动」的历史隐喻,分析AI对科学公地的侵蚀。科学公地指共享的知识、数据、方法和工具,其核心是开放获取与可复用性,依赖同行评审、开源许可等制度维护。AI的介入在三个层面改变边界:数据层,公共资助产生的论文和代码被纳入私有模型,输入与输出不对称;模型层,黑箱特性挑战科学过程的可审计性与可复现性;评价层,AI加速产出可能稀释长期积累机制。文章指出技术社区对此结构性议题注意力稀缺,并提出数据溯源许可、模型审计和公共算力等可能的制度出路。
引言
当我们在讨论AI for Science时,往往聚焦于模型能力、算力规模或论文数量。但Hacker News上的一篇讨论提醒我们注意一个更底层的问题:AI正在改变科学知识的公共属性。原文标题「AI and the Enclosure of the Scientific Commons」直接指向一个历史隐喻——圈地运动。
这篇文章在Hacker News上获得9个点数,讨论热度不高,但它提出的问题值得深挖:科学知识长期被视为人类共同遗产,而AI的介入正在重新划定边界。
什么是科学公地
「科学公地」(Scientific Commons)指的是科学研究中共享的知识、数据、方法和工具的总和。从公开的论文到基因数据库,从开源软件到同行评审机制,这套公共基础设施支撑了现代科学的自我纠错与累积进步。
公地的核心特征是开放获取与可复用性。牛顿说站在巨人的肩膀上,这个隐喻的前提是巨人的肩膀对所有人开放。当AI公司用公开论文训练模型、再将模型能力作为商业产品出售时,公地的输入与输出之间出现了不对称。
公地(Commons) 的概念可追溯到经济学中对公共资源的研究,尤其是加勒特·哈丁1968年提出的「公地悲剧」——个体理性使用会导致公共资源枯竭。但埃莉诺·奥斯特罗姆后来证明,社区可以通过自治理制度避免这一结局,并因此获得2009年诺贝尔经济学奖。在科学语境中,公地并非无主之地,而是由一套制度安排维护的共享资源体系:论文的同行评审、数据的开放标准、代码的开源许可证,都是防止公地被过度攫取的治理机制。理解这一点很关键——圈地并非简单的「占用」,而是治理规则的改写。
圈地运动的三个维度
数据层的私有化
科学论文、预印本、代码仓库是AI训练数据的重要来源。这些内容多数由公共资金资助产生,却以各种方式被纳入私有模型。原始讨论没有展开具体案例,但这一张力在学术界已有广泛共鸣:公共投入的数据,产出的是谁的资产?
训练数据的版权与许可问题是这一张力的法律落点。科学论文的版权状态差异很大:开放获取(Open Access)论文通常采用知识共享(CC)许可,但具体条款对商业使用的限制各不相同;传统订阅制论文的版权多归出版商所有,AI公司大规模抓取这类内容已引发多起诉讼,如《纽约时报》诉OpenAI案。预印本平台如arXiv虽可公开访问,但其使用条款对批量抓取和商业训练有明确限制。这意味着「公开可读」与「可合法用于训练」之间存在法律鸿沟,而当前AI公司往往依赖「合理使用」(fair use)抗辩来跨越这一鸿沟。
模型层的不透明
与论文的可复现性要求不同,大型AI模型往往是黑箱。当AI工具越来越多地参与假设生成、实验设计和数据分析时,科学过程的可审计性面临挑战。公共科学依赖透明来验证,而私有模型以竞争为由拒绝披露细节。
可复现性(Reproducibility) 是现代科学的基石之一,指独立研究者依据论文描述能重现实验结果。这一规范在AI辅助科学中面临双重挑战:其一,商业大模型不公开权重、训练数据和架构细节,外部研究者无法复现其行为;其二,即使模型开源,训练数据的不可获取也使完全复现成为不可能。作为回应,学界提出了「模型卡片」(Model Cards)和「数据表」(Datasheets for Datasets)等文档规范,以及「可审计AI」的治理框架,但这些机制目前多为自愿性质,缺乏强制约束力。
评价体系的偏移
AI加速了论文产出,也改变了科研评价的重心。当生成速度取代深度思考成为可量化的指标,科学公地所珍视的长期积累机制可能被稀释。这一点原文着墨不多,但从圈地隐喻中可以合理延伸。
为什么这个议题被低估
Hacker News上仅有1条评论,折射出技术社区对这类结构性问题的注意力稀缺。多数讨论集中在模型性能和应用场景,而对知识生产关系的反思相对边缘。
这种忽视本身值得注意。科学公地的侵蚀不是单一事件,而是渐进的制度漂移:每一次数据授权条款的收紧、每一次模型细节的保密、每一次评价指标的偏移,单独看都合理,累积起来却改变了科学的运行逻辑。
可能的出路
原文没有给出系统方案,但圈地运动的历史提供了参照:公共地并不必然走向私有化,制度设计可以划定边界。
- 数据溯源与许可:明确公共资助数据的AI使用条件
- 模型审计机制:对参与科学决策的模型建立可复现性要求
- 公共算力与开源模型:保留非商业化的科学AI基础设施
这些方向都需要科学界与技术界的共同协商,而非单方面的商业决策。
结语
AI对科学的贡献板上钉钉,但工具的效率提升与知识生态的可持续性是两个层面的问题。把「圈地」作为分析框架,不是为了否定AI,而是提醒我们:公地的价值在于其公共性,一旦这个前提被侵蚀,站上巨人肩膀的机会将不再均等。
原文讨论虽短,但议题的分量远超其传播热度。
相关推荐

FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。

前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。