AI越聊越笨?Claude Code与Cursor的上下文管理解法

长上下文不是容量问题,而是信息过时与冲突,需按任务组织上下文。
文章指出,上下文变长后模型表现下降的根源并非窗口容量不足,而是新旧信息混杂、过时信息被误当作依据,导致「记的东西互相打架」。为此提出四种解法:一是用 Agent 状态栏把过程压缩成状态,让模型直接读取当前进度;二是通过搜索加读取现场验证状态是否过时,实现按需加载;三是采用子 Agent 模式隔离探索过程,只交回结果摘要;四是用 Compact 等命令按任务压缩长历史,判断标准是信息是否影响下一步决策。核心思想是按当前任务组织上下文,帮模型把注意力放在「现在」上。
为什么上下文越长,AI反而越「笨」?
很多人以为只要模型窗口够大,聊得再长也没问题。但实际情况是:上下文越长,模型利用其中信息的表现就可能下降,甚至还没到窗口上限就开始出错。
界面上的上下文占用比例只告诉你「还能装多少」,却无法告诉你「装进去的信息是否还有效」。信息还在,不代表它现在还有用。新旧信息混在一起,模型必须判断该听哪一个——一旦判断错了,过时的信息就会被当成依据。
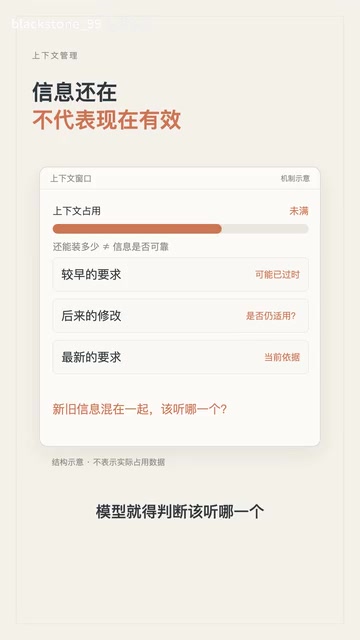
这是长对话 Agent 的核心困境:不是记不住,而是记的东西互相打架。
上下文窗口(Context Window) 指大模型单次推理时能够接收的最大 token 数量,包含系统提示、历史对话、工具返回结果等全部内容。早期模型的窗口通常只有 4K–8K token,如今主流模型已扩展到 128K 甚至百万级。然而窗口大小只代表「能装多少」,并不等于「能用好多少」。业界用 「上下文腐化」(Context Rot) 描述这一现象:随着输入变长,模型对中间位置信息的检索与推理准确率下降,容易忽略关键细节或被相互矛盾的旧信息误导。这与 Transformer 的注意力机制在长序列上的稀释效应有关——注意力权重被大量无关 token 摊薄,真正重要的信息反而得不到足够关注。因此,单纯扩大窗口并不能解决长对话中的可靠性问题,如何组织上下文才是关键。
解法一:让 Agent 有「状态栏」,而不是翻聊天记录
业界常见的做法是:把散落在历史里的信息,整理成模型当前能直接使用的状态。否则模型每走一步都要重新翻历史、重新推断任务到了哪里。
一种实现方式是 Agent 状态栏——把当前状态放进上下文,并随任务推进持续更新。
以 Claude Code 修一个登录问题为例:你让它先列计划,再逐项执行——查原因、改代码、跑测试。做了这一大串操作后,它怎么知道现在到哪一步了?
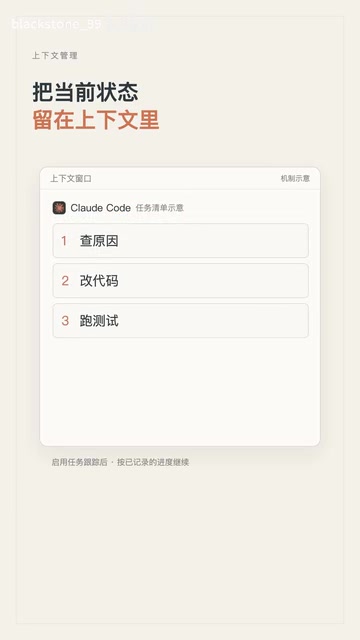
启用任务清单后,进度会被单独记录并随执行更新。模型只要读一下清单,就知道:原因查完了,代码正在改,测试还没跑。下一步做什么,不需要再从整段聊天里重新推断。
这背后的原则是:把「过程」压缩成「状态」,让每一步决策都基于当前快照,而不是全部历史。
解法二:状态可能过时,用「搜索+读取」现场验证
记下来的状态本身也可能不准确。怎么办?需要时就去搜索、读取原始资料,确认实际情况。
Cursor 就是这么做的:先搜代码,再读相关文件,看看实际情况是不是和记录一致。
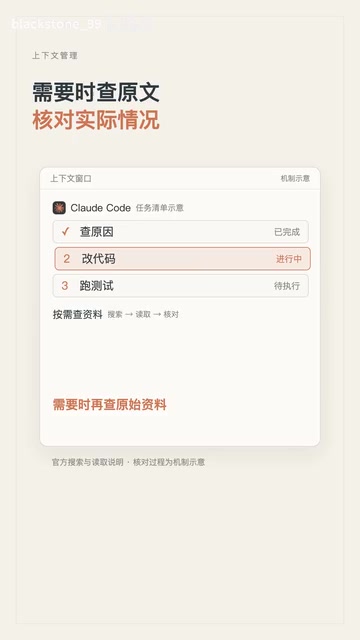
这种做法有两个好处:既能检查记录有没有过时,也不用一开始就把所有资料塞进上下文。按需加载,而不是预先囤积。
按需加载(Lazy Loading / Just-in-Time Retrieval) 是相对「预先囤积」的上下文策略:不在一开始把所有可能相关的资料塞进窗口,而是在模型判断需要时再通过搜索、读取文件、调用工具等方式获取。这一思路借鉴了软件工程中的惰性求值思想。常见实现包括检索增强生成(RAG)中的向量检索、Agent 的工具调用(如 grep、文件读取、网页抓取)等。其优势在于:窗口内始终保持较高的信息密度,减少无关内容对注意力的干扰;同时每次读取的都是最新数据,天然规避了状态过时的问题。代价是增加了交互轮次和延迟,因此需要在「预加载」与「按需拉取」之间做权衡。
解法三:把探索过程隔离出去——子 Agent 模式
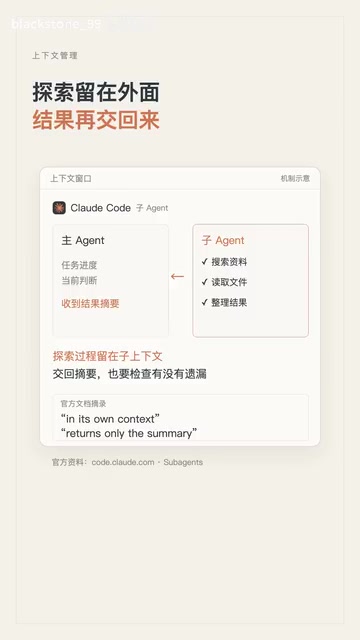
如果一个独立任务仍然要查很多资料,可以把探索过程隔离出去。Claude Code 的子 Agent 就在自己的上下文里工作,完成后只把结果摘要交回来,主 Agent 不用跟着读完整过程。
但交接也要避免遗漏重要信息——摘要的质量决定了隔离是否安全。这也是子 Agent 模式最需要设计的地方:隔离的是过程,不是结论。
子 Agent(Sub-Agent) 是一种多智能体协作架构:主 Agent 将某个子任务委派给独立的 Agent 实例,后者拥有自己的上下文窗口和工具权限,独立完成搜索、读取、推理等过程,最终只把结论或摘要返回给主 Agent。这种模式的核心价值是上下文隔离——子 Agent 探索过程中产生的大量中间结果(试错、无关文件内容、冗长日志)不会污染主 Agent 的上下文,从而保持主上下文的精简与聚焦。与「工具调用」不同,子 Agent 具备自主规划和多步执行能力,更像一个被派出去调研的助手。设计难点在于交接协议:摘要必须保留决策所需的关键信息,否则隔离就会变成信息丢失。
解法四:长历史按任务压缩,关键是判断「是否影响下一步」
已经积累的长历史怎么办?按任务压缩。
Claude Code 的 Compact 命令允许你指定压缩时关注的内容。判断标准很清晰:这条信息会不会影响下一步判断? 会,就需要保留。
不过,提出保留要求也不代表压缩后绝对不会遗漏——压缩始终是有损的,这是这套方法需要接受的现实。
上下文压缩(Context Compaction / Summarization) 指当历史对话超出理想长度时,用模型将旧内容概括成更短的摘要,替换掉原始记录,从而释放窗口空间。压缩可以是有损的:细节、措辞、中间推理步骤都可能被丢弃,只保留结论和关键事实。按任务压缩则进一步强调「相关性」——并非均匀压缩所有历史,而是围绕当前任务目标判断哪些信息必须保留、哪些可以丢弃。判断标准通常是「这条信息是否会影响下一步决策」。压缩的常见风险包括:摘要遗漏关键约束、丢失用户偏好、误删尚未完成的待办事项。因此实践中常配合「状态栏」等显式记录机制,把必须保留的结构化状态与可压缩的对话历史分开管理。
这套方法可以概括为一句话
按当前任务组织上下文:让模型直接看到现在的状态;需要细节时再查;历史太长时按任务压缩。每一步要用什么,就围绕这一步准备信息。
对普通用户来说,这意味着:与其抱怨模型「聊久了变笨」,不如主动帮它维护清晰的任务状态——明确当前目标、及时清理无关信息、在关键节点让它重新确认事实。上下文管理的本质,是帮模型把注意力放在「现在」上。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。