AI账单越涨越高,智能却真的变便宜了:拆解三大计价维度

AI token单价上涨是假象,同等智能的实际成本已悄然下跌20倍,账单增长源于Jevons悖论驱动的用量爆炸。
文章剖析了一个普遍的认知误区:开发者看到顶级模型token报价飙升,便认为奥特曼"AI智能成本十倍降价"的承诺落空。作者指出,token单价是衡量AI成本最糟糕的维度,真正的成本逻辑需要结合"完成任务的token消耗量"与"同等智能水平下的总花费"来判断。通过寻找历史上智能评分相当的模型进行对比,作者发现同等智能的实际成本已下降约20倍,远超承诺目标。Artificial Analysis的长期数据进一步印证了各智能区间成本的断崖式下跌,且每轮降价速度比上一轮更快。账单上涨的真实原因是经典的Jevons悖论——模型变得足够便宜和强大后,用户开始将其用于过去根本不可行的复杂任务,生产力提升与支出增长同步发生,两者始终绑定在一起。
山姆·奥特曼曾承诺AI的智能成本会以每年十倍的速度下降,描绘出"便宜到无法衡量"的智能新前沿。但现实却恰恰相反——一位开发者坦言,去年全年个人使用AI大约花费800到1000美元,而现在任何一天都可能烧掉1000美元以上的token。随着Fable、Astra这类单位token更贵、生成token更多的模型出现,企业的AI账单像是没有尽头地往上涨。那么奥特曼的承诺到底失效了吗?
答案是:十倍变便宜其实真的发生了,只是我们用错了衡量方式。
为什么token价格看起来在暴涨
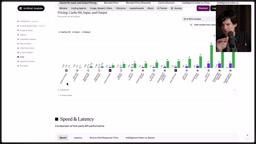
如果只盯着顶级模型的token报价,确实令人心惊。以Artificial Analysis的数据为例,GPT-5 medium的输出价格是每百万token 10美元、输入1.25美元;而到了GPT-6 Astra这一级别,输出价格飙到每百万50美元、输入10美元。这意味着输入输出成本都出现了5到10倍的上涨,和"十倍变便宜"的承诺完全背道而驰。
但token单价恰恰是衡量AI成本最糟糕的方式之一。真正需要考虑的其实是三个维度:每美元能买到多少token、完成一项任务需要消耗多少token,以及在特定智能水平下解决问题要花多少钱。只看第一项,就像只看油价而忽略了车的油耗和能跑多远。
值得一提的是,便宜端同样在飞速进化。像GLM 5.3 Flash这样的模型,输入每百万token仅15美分、输出50美分,很多地方还打五折。它的价格大约只有GPT-5的二三十分之一,却能在大量真实的agentic任务上跑赢GPT-5。顶端模型变得更疯狂,但底端模型也变得异常能打,两端都有实打实的进步。
token消耗量才是账单真相
单价便宜不等于总花费便宜,关键在于一个任务要烧掉多少token。视频中举了一个有趣的例子:Gemini 3.8 Flash的输出价格每百万3.75美元,看起来是GPT-5价格的一半不到、Astra的十分之一。但一旦换成"每个智能基准任务的成本"来衡量,差距立刻收窄——因为3.8 Flash在完成任务时极度"费token",原本超过10倍的价格优势瞬间缩水到3倍以内。
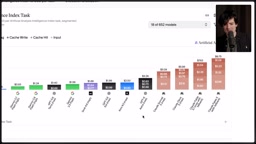
更夸张的是Sonnet 5,由于它疯狂燃烧token,实际总成本甚至比Astra还高。这说明不同任务的计价逻辑完全不同:如果任务是读取80万token再做分类,那输入token才是主要成本,输出几乎可以忽略,这时就该选输入最便宜的模型;而如果是agentic开发工作,缓存等优化手段的作用会被放大得多。
所以成本从来不是单维度的,必须把"单价×任务token消耗"结合起来看,才接近真实支出。
把视角翻转:同等智能的成本在断崖式下跌
真正有说服力的分析,是把问题反过来——不问"一美元能买多少智能",而问"某个固定智能水平,随时间推移要花多少钱"。作者为此做了不少研究,发现由于基准被不断刷爆、几乎所有评测都在过去一年里被迫重做,找到"分数相当的模型"比预想中困难得多。
最终他找到DeepSeek广告 V4 Flash与GPT-5 codecs high在智能指数上大致相当,甚至在Humanities Last Exam、幻觉率测试等多个基准上还更强。而DeepSeek V4 Flash的输入token便宜21倍、输出便宜55倍。即便假设它效率低3倍,净算下来仍有约20倍的提升。换句话说,若目标是"同等智能便宜十倍",现实是直接翻倍完成到了20倍。
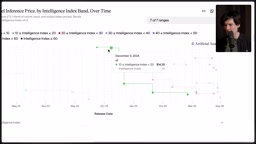
Artificial Analysis的长期追踪更清晰:智能指数低于10分的任务,从2022年11月到2024年7月,成本从每任务60美分跌到2美分。10到20分区间,O1 Preview初期要15美元一个任务,几个月后Grok 3 Mini就以约百分之一的价格拿到更高分数——四个月内价格下跌近99%。而且每一轮降价都比上一轮更快。到了40分、50分这样的高端区间,Opus 4.7起步价3.85美元,随后5.6 Terra以近乎一半价格拿到更高分,GLM 5.3更以不到三分之一的价格超越,GLM 5.3 Flash则以约百分之一的价格逼近同等分数。
文中提到的"智能指数"和"Humanities Last Exam"等评测基准,来自AI研究机构对模型综合能力的量化尝试。Artificial Analysis的智能指数综合了推理、编码、数学、语言理解等多项基准的加权得分,用以横向比较不同模型的整体能力水平。Humanities Last Exam(HLE)则是由学术界设计的极难题库,涵盖哲学、历史、文学等人文学科的专家级问题,即便是顶级模型的正确率也普遍低于20%,因此常被用作区分顶端模型能力的"天花板测试"。正是因为这类高难度基准不断被刷新,旧评测迅速失去区分度,才导致作者在寻找"分数相当的历史对比模型"时遭遇困难——模型进步速度已经快过了评测体系的迭代速度。
Jevons悖论:越便宜,花得越多
既然同等智能真的变便宜了,为什么账单还在涨?第四个被作者刻意留到最后的关键是:用法变了。
过去我们让模型自动补全一个函数,现在我们丢给它一张bug截图,让它端到端地定位、修改、验证、合并到主分支。模型能做的事情多了太多,运行时间更长、任务更大、需要人工介入的次数更少。生成的token暴增,本身就是成功的标志——正因为模型更便宜、更强、更可靠,我们才敢把更重的活交给它。
这正是经典的Jevons悖论:当蒸汽动力变便宜、煤炭更易获取时,人类反而在这些东西上花了更多钱,因为它们终于便宜且好用到能进入过去无法触及的场景。AI账单上涨不是因为模型更贵了,而是因为我们在更多地使用那些强大的模型。
作者还特别点出,GLM 5.3 Flash不只是"同等能力更便宜",它本身就是比GPT-5更好的模型:视觉处理更强、工具调用更好、尤其是在需要连续运行数小时的agentic工作流中表现碾压。GPT-5唯一的优势是无需搜索就掌握更多知识,但只要给两者都配上搜索工具,Flash往往能数量级地反超——因为它更会用工具。配好工具的模型,能全面压过去年最聪明的模型。
Jevons悖论由19世纪英国经济学家威廉·斯坦利·杰文斯提出。他在1865年的著作《煤炭问题》中观察到:蒸汽机效率提升后,煤炭的单位使用成本下降,但英国整体煤炭消耗量却反而大幅增加。原因在于,效率提升降低了使用门槛,使得原本不经济的应用场景变得可行,从而催生了全新的需求,总消耗量的增长完全抵消甚至超过了单位节省。在AI语境中,这一规律体现为:当推理成本下降到足以支撑"让模型自主运行数小时完成复杂任务"时,用户会将AI引入过去根本不考虑的场景,单任务消耗的token量级式上升,最终账单反而更高。这并非资源浪费,而是需求释放的必然结果。
结论:承诺早已兑现,只是账单藏在生产力里
作者坦言自己曾在两年前错判AI"已经触顶",那是他人生中最糟糕的判断之一,教训就是不要低估进步速度。如今的现实是:AI变得比他想象中更强、更快、更便宜,便宜到人们开始毫无顾忌地在上面挥霍。
"智能便宜到无法衡量"或许没有以奥特曼暗示的方式实现,但"便宜十倍"的承诺早已被远远超越。去年我们用AI做的那些任务,今天确实便宜了那么多;区别只在于,我们现在能用它做更大、更难的事。一天烧掉1500美元确实惊人,但这笔钱买到的产出,是GPT-5时代根本无法完成的——LLM的支出,始终与它带来的生产力绑定在一起。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。