AI智能体安全新思路:拦截工具调用的开源方案Aegotrax
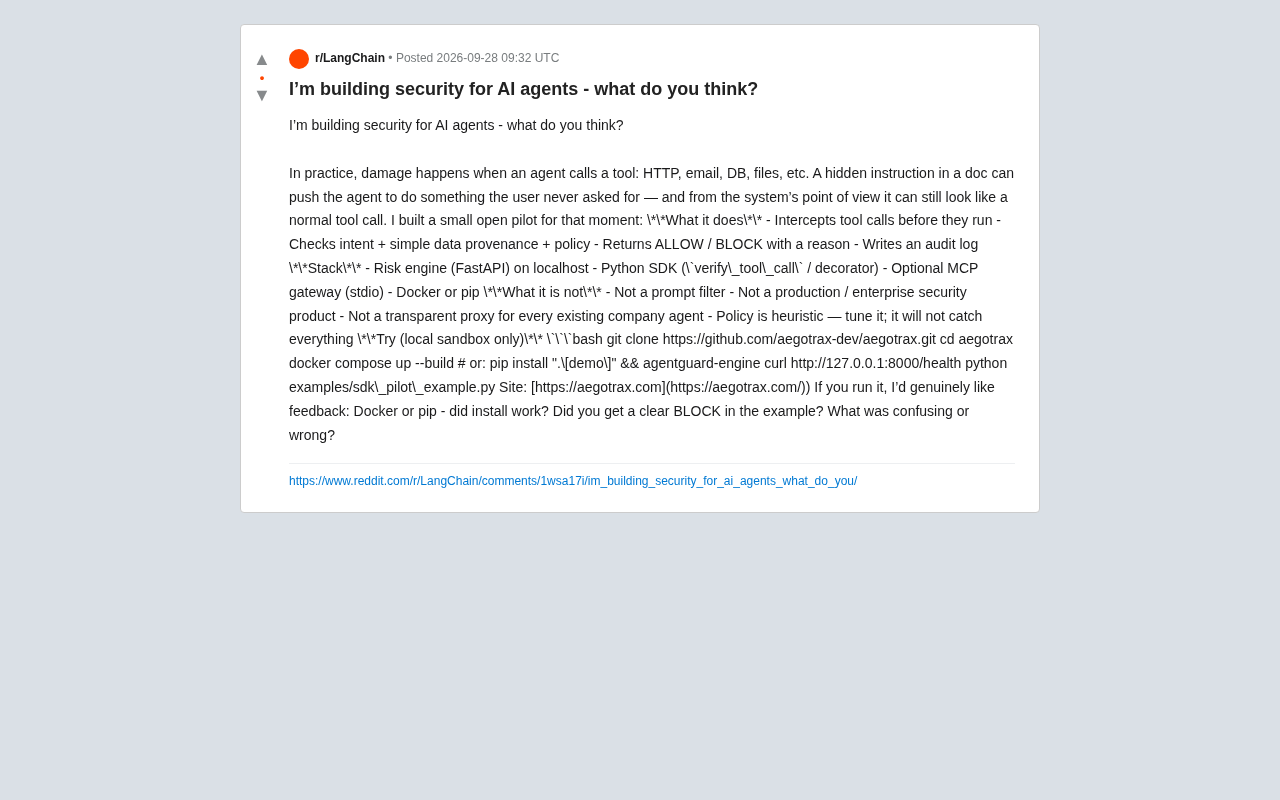
开源项目Aegotrax在AI智能体工具调用执行前加设安全闸门,拦截提示注入等动作层攻击。
随着AI智能体获得调用真实工具的能力,安全风险的核心从"模型说什么"转移到了"模型做什么"。开发者基于这一洞察构建了开源试点项目Aegotrax,其防护逻辑不同于传统的提示词过滤,而是在工具调用即将执行的关口进行拦截,综合检查调用意图、数据来源与策略规则,返回ALLOW/BLOCK决策并写入审计日志。技术实现以FastAPI为核心,提供Python SDK与可选的MCP网关接入,支持Docker和pip本地部署。作者坦诚地界定了项目边界:策略基于启发式规则,无法拦截所有攻击,定位为可本地沙盒试玩的原型而非生产级产品。该项目的出现折射出AI智能体安全领域从语言层向动作层防护演进的新趋势,其"拦截工具调用+审计日志"的参考架构对正在开发智能体应用的开发者具有借鉴价值。
AI智能体真正的风险发生在“工具调用”那一刻
随着AI智能体(AI Agent)能力越来越强,安全问题也逐渐从理论走向现实。一位开发者在Reddit上分享了他正在构建的开源安全项目,直指一个被很多人忽视的攻击面:智能体调用工具的瞬间。
他的观察相当精准——真正的破坏并不发生在模型“思考”时,而是发生在智能体实际执行动作时:发起HTTP请求、发送邮件、操作数据库、读写文件。文档中一条隐藏的指令,可能诱导智能体去做用户从未要求的事情,而从系统层面看,这依然像是一次“正常”的工具调用。
这正是提示注入(prompt injection)类攻击最危险的地方:恶意意图被包装成合法操作,绕过了传统的输入过滤。开发者据此构建了一个小型开源试点项目 Aegotrax,专门针对这一“执行时刻”做防护。
Aegotrax 做了什么
与常见的提示词过滤思路不同,Aegotrax 把防护点放在工具调用即将执行的关口,核心逻辑可以概括为四步:
- 拦截工具调用:在实际执行前先行截获
- 检查意图 + 数据来源 + 策略:结合简单的数据溯源(data provenance)与策略规则做判断
- 返回 ALLOW / BLOCK 决策:并附带明确的理由
- 写入审计日志:保留可追溯的操作记录
这种“先审再放行”的模式,本质上是在智能体与外部世界之间加了一道可编程的安全闸门。相比只在输入层拦截文字,它更贴近实际造成损害的动作层,理论上能捕捉到那些“看起来正常、实则越权”的调用。
技术栈构成
项目的实现相当轻量,适合本地快速上手:
- 风险引擎:基于 FastAPI,运行在 localhost
- Python SDK:提供
verify_tool_call函数与装饰器两种调用方式 - 可选 MCP 网关:通过 stdio 接入
- 部署方式:支持 Docker 或 pip
值得关注的是它对 MCP(Model Context Protocol)网关的支持。随着 MCP 逐渐成为智能体连接工具的标准协议,在这一层做安全拦截,意味着方案有机会覆盖更广泛的智能体生态,而不局限于某一个框架。
MCP(Model Context Protocol)是由 Anthropic 于2024年底提出的开放协议,旨在为AI智能体与外部工具、数据源之间的通信建立统一标准。它的作用类似于"智能体世界的USB接口":工具开发者只需实现一次MCP服务端,任何支持MCP的智能体框架都可以直接接入,无需为每个框架单独适配。MCP通过stdio或HTTP流传输结构化的工具描述、调用请求与响应,使工具能力的发现和调用过程标准化。目前Claude、部分开源框架(如LangChain、AutoGen的实验性分支)已陆续支持MCP。Aegotrax在MCP网关层做安全拦截的设计,意味着只要智能体框架走MCP协议,就可以统一接入其防护逻辑,而无需为每个框架单独集成SDK,这在多框架并存的当前生态中具有较强的实用价值。
作者的坦诚:它不是什么
这个项目最难得的一点,是作者对边界的清晰界定。他明确列出了 Aegotrax 不是什么:
- 不是提示词过滤器
- 不是生产级 / 企业级安全产品
- 不是可透明代理所有现有企业智能体的方案
- 策略是基于启发式(heuristic)的——需要自行调优,且无法拦截所有攻击
这种自我设限在安全领域尤为可贵。AI智能体安全目前仍处于早期探索阶段,任何声称“全面防护”的说法都值得警惕。作者把它定位为一个开放试点、一个可以本地沙盒试玩的原型,而非交钥匙方案,反而更符合当前技术的真实成熟度。
启发式策略的局限也很现实:它依赖规则的覆盖面,对未见过的攻击模式可能力不从心。这也解释了为什么作者强烈希望社区给出反馈——安全规则往往需要在真实场景中不断迭代打磨。
启发式(Heuristic)策略是指基于经验规则而非严格数学证明来做决策的方法。在安全领域,典型的启发式规则形如"若工具调用目标域名不在白名单内则阻断""若单次调用涉及的数据量超过阈值则告警"。这类规则的优点是可解释、可快速部署,缺点是覆盖面受限于规则编写者的经验与想象力——对于从未见过的攻击模式(即"零日"攻击场景)往往无能为力,且容易产生误报(合法操作被拦截)或漏报(恶意操作未被识别)。与之相对的是基于机器学习的异常检测方案,后者理论上能泛化到未知模式,但需要大量标注数据且可解释性较差。当前AI智能体安全领域两种路线都在探索中,Aegotrax选择启发式是务实之举,也意味着其防护效果高度依赖社区持续贡献真实攻击案例来丰富规则库。
如何本地试用
项目提供了完整的本地沙盒体验路径(务必仅在本地沙盒环境运行):
git clone https://github.com/aegotrax-dev/aegotrax.git
cd aegotrax
docker compose up --build
# 或者:pip install ".[demo]" && agentguard-engine
curl http://127.0.0.1:8000/health
python examples/sdk_pilot_example.py
作者希望收集的反馈也很具体:Docker 或 pip 安装是否顺利?示例中是否成功触发了清晰的 BLOCK 决策?哪些地方令人困惑或存在错误?这种以问题为导向的反馈征集,说明项目还在快速迭代期,早期使用者的意见会直接影响后续走向。
一点观察:智能体安全的新战场
Aegotrax 这类项目的出现,反映了业界对AI智能体安全认知的深化。过去的防御重心放在“不让模型说坏话”,而智能体时代的关键风险是“不让模型做坏事”。当模型拥有了调用真实工具、影响真实系统的能力,安全的落脚点必须从语言层下沉到动作层。
把审计、意图检查、数据溯源和策略引擎组合成一道执行前的关卡,是一个合乎逻辑的方向。但正如作者所言,启发式策略并非万能,这更像是一个开始而非终点。对于正在开发智能体应用的开发者来说,这个开源项目至少提供了一个值得研究的参考架构——即便不直接使用,其中“拦截工具调用 + 审计日志”的设计思路也有借鉴价值。
需要提醒的是,该项目自我定位为试点原型,非生产级产品,请勿在关键业务环境中直接依赖。
背景补充
提示注入(Prompt Injection)是指攻击者将恶意指令嵌入模型会读取的外部内容中——例如网页、文档、邮件正文或数据库字段——从而劫持智能体的行为。与传统SQL注入类似,它利用的是"数据"与"指令"边界模糊的问题。对于AI智能体而言,这一威胁尤为严峻:智能体往往被授权读取大量外部数据作为上下文,而模型本身很难区分"需要处理的内容"和"应当执行的命令"。典型攻击场景包括:在PDF简历末尾附上白色字体的隐藏指令,诱导招聘助理智能体泄露其他候选人信息;或在网页中嵌入不可见文字,指示浏览型智能体将用户数据发送至第三方地址。OWASP已将提示注入列为大语言模型应用的首要安全风险(LLM Top 10 第一位)。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。