AI智能体的团队协作困局:单点提效为何反成负ROI?

AI编程智能体节省个体2小时却增加团队3小时对齐成本,孤立对话是结构性缺陷。
文章指出,AI编程智能体在个人使用时能显著提效,但进入团队协作场景后可能产生负ROI:工程师用智能体快速生成代码,却因智能体不了解团队已有架构决策和命名约定,导致团队需要额外时间对齐、审查和纠正冲突。核心矛盾在于当前智能体的对话是孤立的、私密的,无法获取团队共识上下文,形成"缺少上下文—方案冲突—额外纠正—信息仍不共享"的恶性循环。Kylon应用尝试用多人共享智能体环境来解决,让Claude Code和Codex运行在共享环境中,赋予智能体实时团队共识可见性。文章建议评估AI编程工具ROI时纳入团队对齐成本,并指出工具厂商的竞争点将从模型能力转向团队上下文理解,产品定位需从个人助手重新定义为团队协作者。
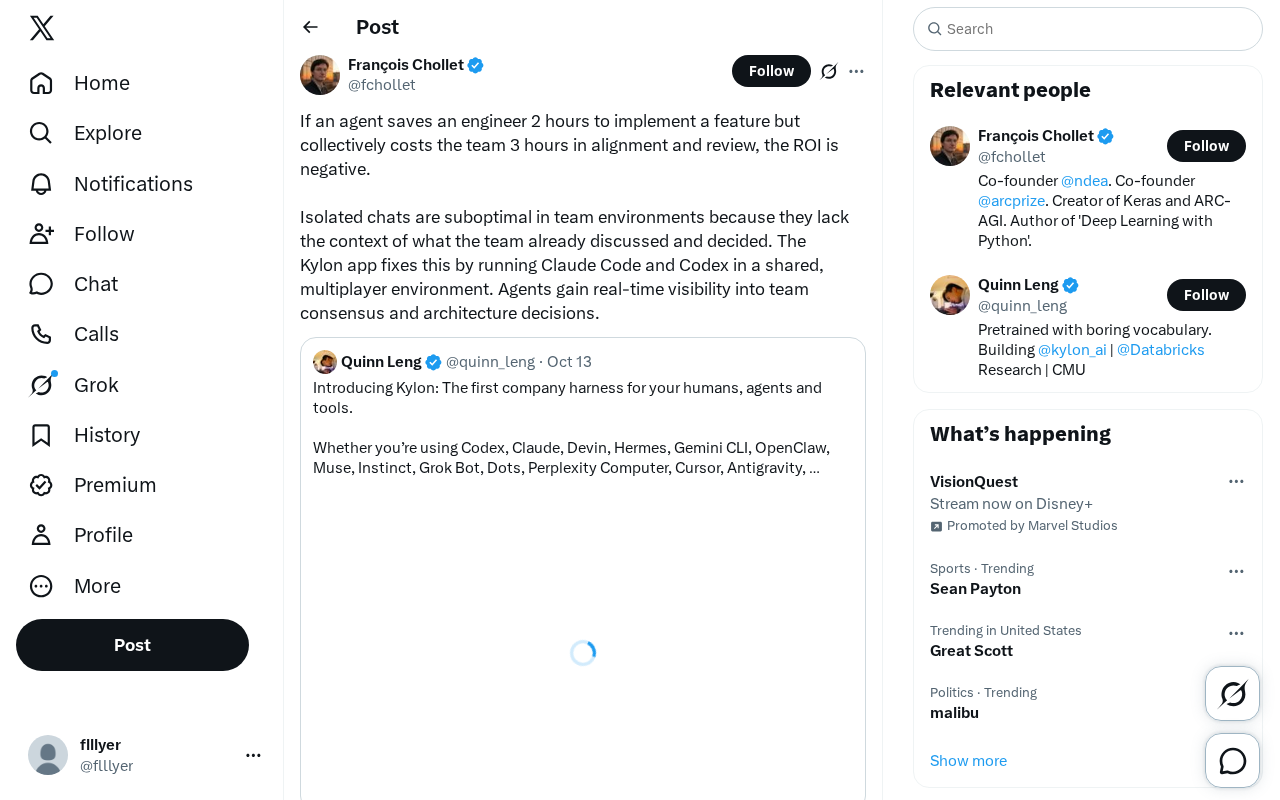
一位工程师用AI智能体节省2小时开发时间,团队却要花3小时进行对齐和审查——这笔账怎么算都是亏的。这个来自Twitter上的观察,戳中了当前AI编程工具落地企业时最尴尬的软肋。
为什么单点提效反而拖累团队?
AI编程智能体(如Claude Code、Codex)在个人使用时表现亮眼,但一旦进入团队协作场景,问题就暴露了。核心矛盾在于:智能体的产出节省了个体执行时间,却可能增加团队的沟通、对齐和审查负担。
具体来说,工程师A用智能体快速生成了一个功能实现,但这段代码的上下文——团队此前讨论过的架构决策、命名约定、已否决的方案——智能体完全不了解。于是A需要向团队解释“为什么这么做”,团队需要重新审查“这是否符合我们之前的共识”,原本可以避免的讨论重新上演。
省下的2小时是个体时间,多出的3小时是团队时间。从ROI角度看,团队时间通常比个体时间更昂贵,因为涉及多人协调成本。
**ROI(投资回报率)**在软件工程语境下通常指收益与投入的比值,但团队场景中的"投入"往往被低估。个体时间与团队时间的成本结构并不对等:一个工程师的2小时可以按小时工资直接计量,而团队3小时涉及多人协调、上下文切换和会议开销,其机会成本通常是个体时间的2至3倍。更关键的是,AI编程智能体的产出是"看似完成的代码",它会触发比人工代码更严格的审查流程——因为审查者需要重建智能体生成时的假设,而人工代码的假设往往隐含在作者的思考过程中。因此,衡量AI工具价值时,必须把"协调成本"作为独立变量纳入模型,而非简单地从个体效率推算团队效率。
孤立的对话为何是次优解?
原文指出了一个关键问题:孤立的对话(Isolated chats)在团队环境中是次优的。每个工程师与AI的对话都是私密的、隔离的,智能体无法获取团队已经讨论和决定的内容。
这导致一个恶性循环:
- 智能体缺少团队共识的上下文
- 生成的方案可能与团队已有决策冲突
- 团队需要额外时间发现冲突并纠正
- 纠正后的信息又无法反馈给智能体,下次继续犯错
这不是模型能力的问题,而是信息架构的问题。智能体再强,如果被隔离在个人对话中,就无法成为真正的团队资产。
**上下文(Context)**在大语言模型驱动的智能体中,指的是模型在生成回复时能够访问的全部信息,包括系统提示、对话历史、工具调用结果以及外部检索内容。当前主流AI编程工具(如Claude Code、Codex CLI)的上下文窗口是"会话级"的——每个会话独立维护,会话之间不共享状态。这意味着团队此前在Slack、GitHub PR评论或架构文档中形成的共识,除非被手动粘贴进当前对话,否则智能体完全不可见。这种设计在个人使用时没有问题,因为个人开发者本身就是所有历史决策的载体;但在团队中,知识分布在多个人和多个渠道里,会话级上下文就成为一种结构性缺陷。解决路径通常有两种:一是将团队知识库通过检索增强生成(RAG)注入每次对话,二是构建跨会话的共享记忆层,让智能体能够读取和写入团队级状态。
Kylon的解题思路:多人共享智能体环境
原文提到的Kylon应用尝试用“多人模式”来解决这个问题——让Claude Code和Codex运行在一个共享的、多人的环境中。
这个思路的核心是:智能体获得对团队共识和架构决策的实时可见性。当一个工程师与智能体交互时,智能体不仅知道当前对话,还知道团队之前的讨论结论、架构约束和已有决策。
这听上去简单,但实现起来涉及几个层面的改变:
- 上下文共享:团队的讨论记录、决策文档成为智能体的输入
- 实时同步:多个工程师与智能体的交互需要协调,避免冲突
- 共识感知:智能体在生成方案前,先检查是否与团队已有决策一致
这种“多人智能体”模式如果成立,理论上可以消除因信息隔离导致的重复对齐成本。
多人共享智能体环境的技术挑战在于并发控制与状态一致性。当多个工程师同时与同一个智能体交互时,需要解决类似分布式系统中的问题:谁可以看到谁的对话?智能体的回复应该基于哪个时间点的团队共识?如果两个工程师同时要求智能体生成相互冲突的方案,系统应如何仲裁?一种可行架构是采用"共享记忆 + 私有会话"的混合模型:团队共识和架构决策写入共享记忆层,每次智能体响应前先读取该层的最新状态;而个人与智能体的中间讨论保留在私有会话中,只有在形成结论后才提交到共享层。这种模式类似于Git的分支与合并工作流,但需要智能体具备判断"何时该同步"的能力。目前这一方向尚无成熟产品,Kylon的尝试更多是概念验证。
团队AI工具的ROI应该怎么算?
这个案例给所有引入AI编程工具的团队提了个醒:评估ROI时不能只看个体效率提升。
一个更合理的评估框架应该包括:
个体收益:工程师节省的执行时间 团队成本:额外的对齐、审查、冲突解决时间 长期收益:智能体是否随着使用积累了团队上下文,减少未来的沟通成本
如果智能体始终孤立运行,长期收益可能为零甚至为负——因为团队不断在纠正智能体的“无知”。只有当智能体接入团队知识体系,成为共识的载体而非噪音源,ROI才可能转正。
对AI编程工具厂商的启示
当前大多数AI编程工具的设计假设仍是“一个开发者对着一个AI”。这个假设在个人项目中成立,但在团队场景中明显不足。
下一阶段的竞争点可能不在于模型能力,而在于:
- 能否理解团队的决策历史
- 能否在多人环境中协调智能体的行为
- 能否把团队共识转化为智能体的约束条件
Kylon的尝试代表了一个方向,但这个问题的彻底解决可能需要AI编程工具从“个人助手”重新定义为“团队协作者”。这不仅是技术问题,更是产品架构和协作模式的重构。
团队上下文理解与单纯的模型能力提升是不同的技术路线。模型能力(如代码生成准确率、推理深度)可以通过扩大参数规模和改进训练数据来提升,但团队上下文理解本质上是一个系统设计问题:它需要产品定义清楚哪些信息属于"团队级"、这些信息如何被采集和更新、智能体在何种时机应该引用这些信息。这类似于从单机软件到协作软件的演进——Excel到Google Sheets的转变不只是功能增加,而是数据模型从"本地文件"变为"共享文档"。AI编程工具若要从个人助手进化为团队协作者,可能需要在底层引入类似"团队工作区"的概念,让智能体、代码库、讨论记录和决策日志处于同一个可寻址的状态空间中,而非让每个开发者各自维护孤立的对话历史。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。