AI智能体故障归因:把根因分析变成一个搜索问题
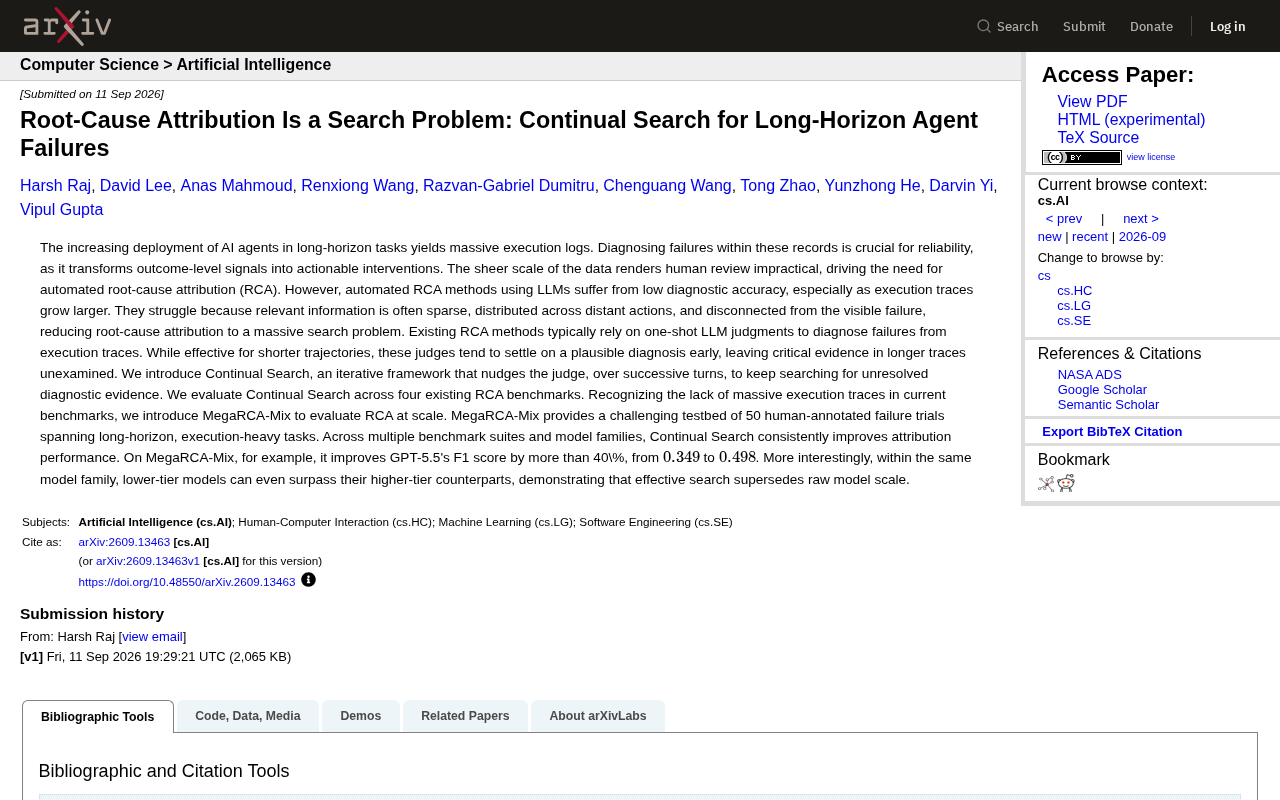
新框架将AI智能体故障诊断重构为搜索问题,多轮迭代使F1分数提升超40%。
arXiv新论文提出,长任务AI智能体的根因归因(RCA)本质上是一个大规模搜索问题。现有基于LLM的一次性诊断方法在长执行轨迹上容易因锚定效应过早收敛,漏掉分散在远处的关键证据。论文提出「Continual Search」框架,通过多轮迭代不断推动模型检查未解决的诊断疑点,将诊断过程从单次判断重构为持续的有导向搜索。在专为长周期任务构建的新基准MegaRCA-Mix上,该方法将GPT-5.5的F1分数从0.349提升至0.498(增幅超40%),且在同一模型家族内,低配版模型经此策略甚至可超越高配版,印证了「有效搜索策略可胜过原始模型规模」这一核心结论,也呼应了业界对推理时计算价值的持续关注。
长任务AI智能体在实际部署中会产生海量的执行日志,一旦任务失败,如何从这些冗长的轨迹里定位到真正的根本原因,成了保障系统可靠性的关键难题。一篇新发布的arXiv论文提出了一个颇具启发性的观点:根因归因(Root-Cause Attribution, RCA)本质上是一个搜索问题,并给出了名为「Continual Search」的迭代式解决方案。
为什么长任务的故障诊断这么难
随着AI智能体被越来越多地部署到长周期(long-horizon)任务中,它们会生成规模庞大的执行记录。诊断这些记录中的失败,能够把「结果层面」的信号(比如任务失败了)转化为「可执行的干预措施」(比如具体是哪一步、哪个决策出了错)。但问题在于,数据规模之大已经让人工逐条审查变得不现实,这直接催生了对自动化RCA的需求。
论文指出,现有基于大语言模型(LLM)的自动化RCA方法存在一个明显短板:诊断准确率偏低,且随着执行轨迹变长而进一步恶化。原因在于,与故障真正相关的信息往往是稀疏的、分散在相距很远的多个动作之间,而且和表面上可见的失败现象缺乏直接关联。换句话说,找到根因就像在一堆干草里找一根针——这本质上是一个大规模的搜索问题。
一次性判断的局限
当前主流的RCA方法大多依赖「一次性」(one-shot)的LLM判断,即让模型看一遍执行轨迹然后直接给出诊断结论。这种做法在较短的轨迹上确实有效,但在长轨迹上会暴露出一个典型的认知偏差:模型倾向于过早锁定一个看似合理的诊断,然后就停下来了,导致长轨迹中许多关键证据根本没有被检查。
这一现象和人类专家的直觉一致——面对海量信息时,人也容易「先入为主」,抓住第一个说得通的解释就不再深挖。对于短轨迹这或许无伤大雅,但当证据分散在成百上千步动作中时,草率收尾就意味着漏掉真正的病灶。
这种「过早收敛」现象在认知科学中有对应的概念,称为锚定效应(Anchoring Bias)——推理者一旦接触到第一个似乎合理的解释,后续判断就会被这个「锚」拉偏,难以客观评估后续出现的反驳证据。对LLM而言,这一问题还与上下文窗口的注意力分配密切相关:在超长输入中,模型对靠前位置或表面显眼的信息天然赋予更高权重,而真正的根因往往深埋在中间某个不起眼的步骤,极易被「稀释」掉。此外,「一次性」生成的结构性缺陷在于,模型没有机会根据新发现的证据来修正早期假设,整个诊断过程缺乏反馈回路,无法像人类专家那样在「提假设→找证据→推翻/确认→再提假设」的循环中逐步收敛到真正的病因。
Continual Search:让模型持续追问
针对这一痛点,论文提出了 Continual Search 框架。它的核心思路是通过多轮迭代不断「推动」(nudge)作为裁判的LLM,让它在一次又一次的对话回合中,持续搜索那些尚未被解决的诊断证据,而不是满足于第一个合理答案。
这种设计把RCA从单次判断,重构为一个持续的、有导向的搜索过程。模型被要求不断反问自己:还有哪些证据没被检查?当前的诊断是否还有未闭合的疑点?这种机制有效对抗了「过早收敛」的问题。
实验结果:搜索能力胜过模型规模
研究团队在四个现有的RCA基准上评估了Continual Search。考虑到当前基准普遍缺乏「大规模执行轨迹」,他们还专门构建了一个新的评测集 MegaRCA-Mix——包含50个由人工标注的失败案例,专门覆盖长周期、执行密集型的任务,作为一个更具挑战性的测试平台。
结果相当亮眼:
- 在多个基准套件和不同模型家族上,Continual Search 都能稳定提升归因性能。
- 在 MegaRCA-Mix 上,它将 GPT-5.5 的 F1 分数从 0.349 提升到 0.498,增幅超过40%。
- 更有意思的是,在同一模型家族内部,低配版模型在采用 Continual Search 后甚至能超越高配版模型。
最后这一点尤其值得深思:它表明有效的搜索策略能够胜过原始的模型规模(raw model scale)。也就是说,与其单纯堆参数、上更强的模型,不如在推理流程上做文章——让模型「搜得更彻底」,可能比「模型本身更聪明」带来更大的收益。
对智能体可靠性的启示
这项研究的价值不止于一个具体方法。它把长任务智能体的故障诊断问题,清晰地重新定义为一个搜索问题,为后续研究提供了新的框架视角。随着AI智能体承担越来越复杂、越来越长的任务链,如何高效、准确地做事后归因,将直接决定这些系统能否被信任并规模化落地。
Continual Search 展示的「过程优化优于规模扩张」的思路,也呼应了近期业界对推理时计算(inference-time compute)的关注——把更多算力和迭代花在推理过程中,往往能以更低的成本换取显著的性能提升。
**推理时计算(Inference-Time Compute)**是近期AI研究的重要方向,其核心思想是:在模型参数固定的前提下,通过在推理阶段投入更多计算资源(如多轮迭代、思维链、自我验证等),来提升输出质量。OpenAI的o系列模型和Google的Gemini Thinking模式都是这一方向的代表性产品。Continual Search本质上也属于这一范畴——它不修改模型权重,而是通过多轮对话协议改变模型的「思考方式」,让同等参数规模的模型产出更深入的诊断结果。这一趋势对AI基础设施的设计有重要含义:优化推理编排逻辑(orchestration logic)与扩大模型规模同样重要,甚至在特定任务上性价比更高。
相关推荐
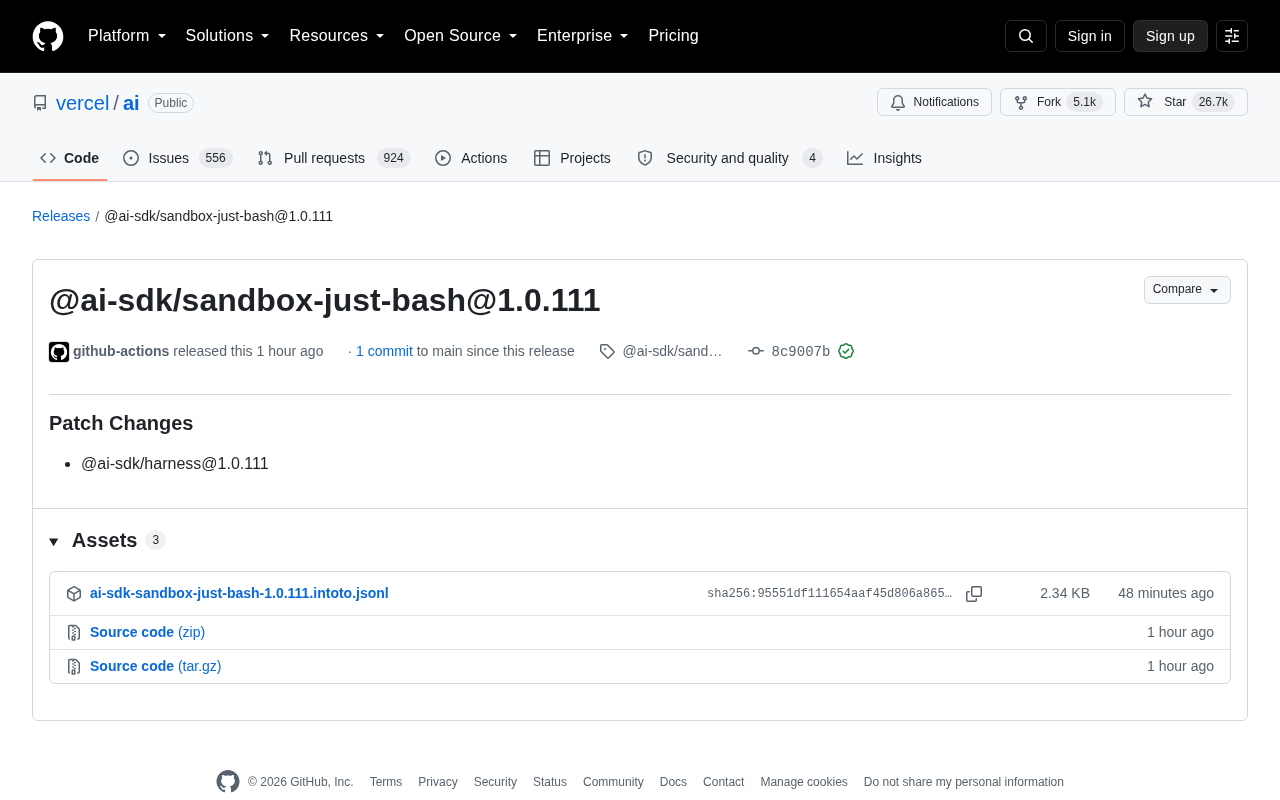
Vercel AI SDK 更新:sandbox-just-bash 组件发布补丁版本
Vercel AI SDK 组件 @ai-sdk/sandbox-just-bash 发布 1.0.111 补丁版本,同步更新 harness 依赖。本文解读此次更新内容及其对开发者的意义。
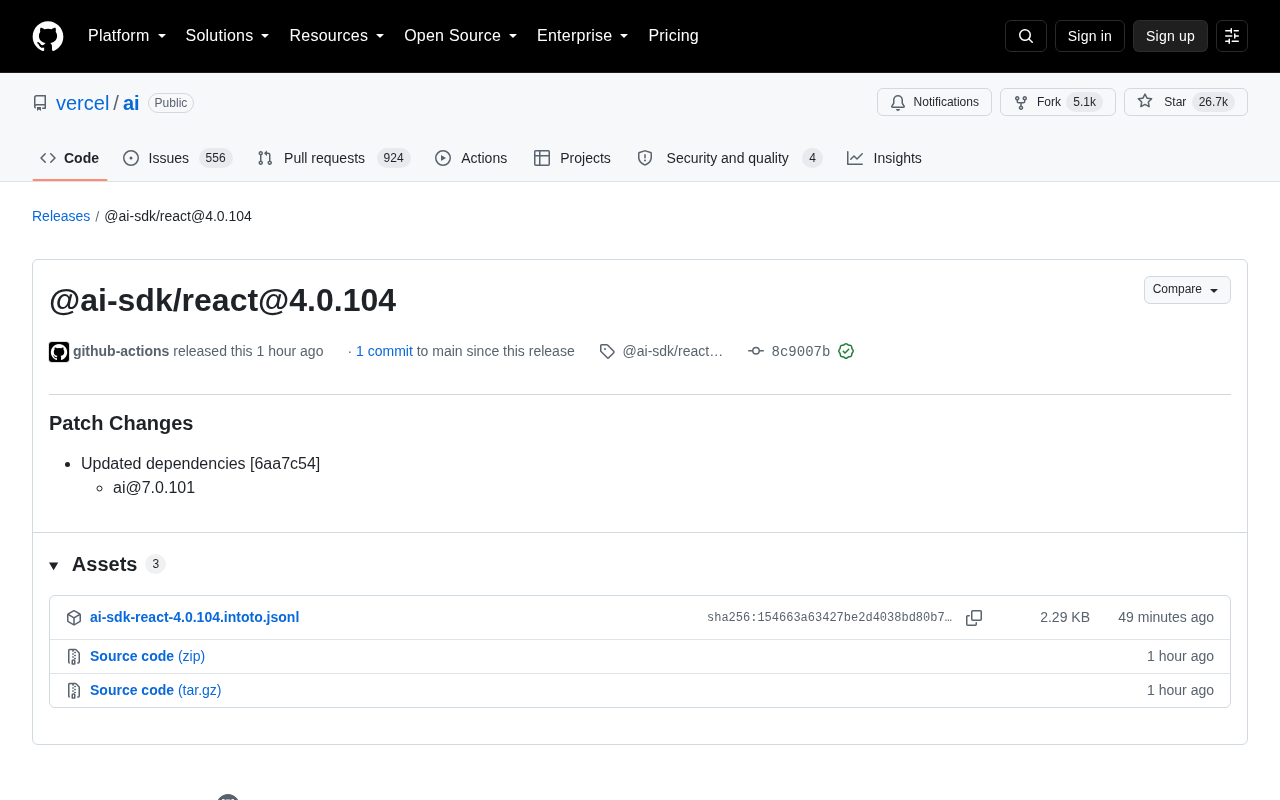
Vercel AI SDK 发布 @ai-sdk/react@4.0.104 补丁更新
Vercel AI SDK 发布 @ai-sdk/react@4.0.104 补丁更新,主要同步升级底层依赖 ai@7.0.101。本文解析该版本更新内容、React 集成能力及开发者升级建议。
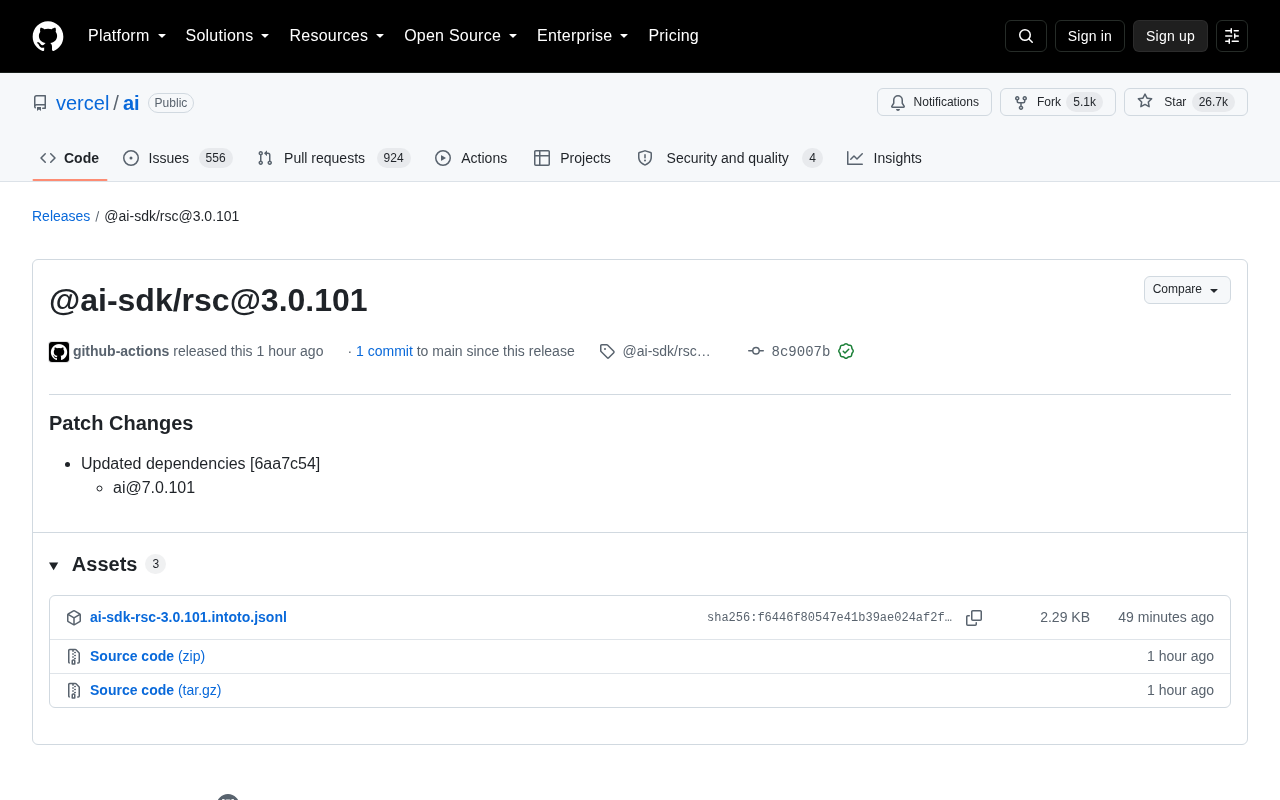
Vercel AI SDK 发布 @ai-sdk/rsc@3.0.101 补丁更新
Vercel AI SDK 发布 @ai-sdk/rsc@3.0.101 补丁更新,同步升级 ai 核心包至 7.0.101。本文解读该版本的更新内容、@ai-sdk/rsc 的作用及对开发者的影响。