AI智能体如何颠覆渗透测试:从挖漏洞到代码审计实战解析
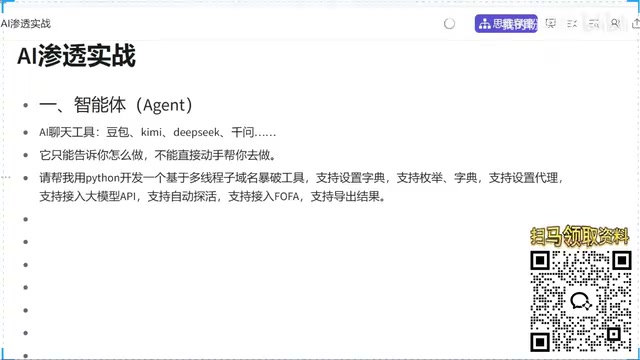
普通AI聊天工具只能出谋划策,真正能挖漏洞的是具备感知、决策、执行六大能力的智能体Agent。
本文从安全从业者的视角,厘清了"AI聊天工具"与"智能体(Agent)"的本质差异。豆包、DeepSeek等聊天工具能生成代码和方案,却无法在用户电脑上直接创建文件、运行命令,导致人工介入的"传话循环"极耗时间。真正的智能体需具备自主感知环境、任务规划、自主决策、直接执行、记忆和工具调用六项核心能力,能将复杂目标拆解并迭代完成。映射到渗透测试场景,智能体的迭代执行能力与"发现—验证—修正"的漏洞挖掘循环高度契合,理论上可大幅压缩重复劳动;但智能体在真实漏洞挖掘中的稳定性、误报控制和复杂目标的决策可靠性,仍需实战持续验证。文章建议安全从业者主动学习驾驭智能体工具,将其作为放大自身能力的杠杆。
AI能帮我们挖漏洞吗?
很多安全从业者对AI挖漏洞仍停留在想象层面:大模型到底能不能真正帮我们找到漏洞?它对网络安全行业、对安全工程师意味着怎样的冲击?这不是一个可以用「能」或「不能」简单回答的问题,关键在于你用的是普通AI聊天工具,还是具备自主行动能力的智能体(Agent)。
据B站安全教学UP主的实战演示,理解这一差异是看懂AI渗透测试价值的前提。豆包、Kimi、DeepSeek广告、通义千问广告等AI聊天工具,从三岁小孩到八十岁老人都在用,能回答问题、生成图片和视频。但在安全实战中,它们有一个突出的短板——只能告诉你怎么做,却不能直接动手帮你做。
聊天工具的瓶颈:知道怎么做≠能做到
举一个安全从业者熟悉的场景:你想用Python开发一个子域名爆破工具。打开豆包开启新对话,提出需求后,它确实会先做规划,再把完整代码输出给你。但它没有帮你完成的部分是——在你的电脑上创建文件、把工具真正运行起来。
接下来的工作全要靠你自己:新建一个.py文件,把代码粘贴进去,运行测试。一旦报错或功能不符预期,你得把报错信息复制回聊天框,等它告诉你怎么改,再把修改后的代码贴回去……这个「人肉传话」的循环非常浪费时间。
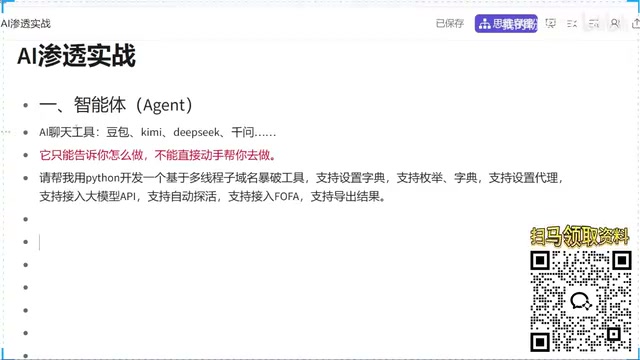
理想的AI应该是:你给出需求,它直接把代码写好、文件建好、运行调试,遇到语法错误或功能问题自己解决。这种模式在渗透测试中的价值尤为突出——漏洞挖掘、代码审计、CTF解题本质上都是「发现问题—尝试方案—验证结果—迭代修正」的高频循环,而这正是人工操作最耗时的环节。
什么样的AI才算「聪明」
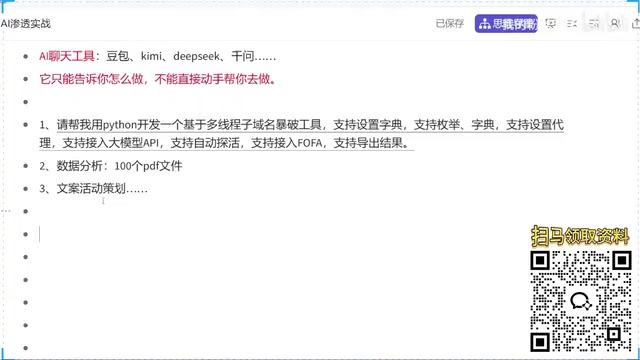
不止是写工具,复杂任务同样需要能动手的AI。比如数据分析场景:给它100个PDF文件,让它提取并总结其中的数据,人工处理极其繁琐;再比如策划一场复杂的大型活动,需要创建大量文件,最终还要输出PPT、Word文档、Excel表格。
真正聪明的AI应该是:你把目标交给它,它直接把成果交付给你。这样的AI,才配称为智能体(Agent)。
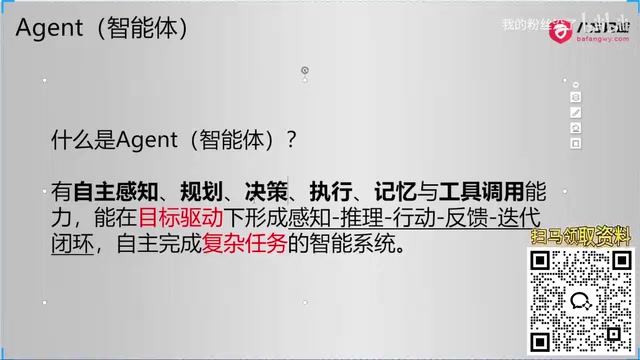
智能体(Agent)这一概念源于人工智能研究中的"自主代理"思想,指能够感知环境、自主规划并持续采取行动以完成目标的系统。与传统的问答式大模型不同,Agent 通常以"思考—行动—观察"为基本循环(即 ReAct 框架),每一步行动的结果会反馈回模型,驱动下一步决策,直到任务完成。在工程实现上,这意味着模型需要与外部工具(如文件系统、终端、浏览器、API)深度集成,并具备跨多步骤维持目标和上下文的能力。目前主流的 Agent 框架包括 LangChain Agent、AutoGPT、Devin 等,安全领域也出现了 PentestGPT、HackingBuddyGPT 等面向渗透测试的专用实现。
智能体的六大核心能力
以开发一个脚本、软件、网站或APP为例,一个合格的智能体必须具备以下六项能力,缺一不可:
1. 自主感知环境
它在你电脑上运行时,能识别当前是一个空文件夹,还是开发到一半的代码工程,或是已完成功能、需要继续优化的项目。它能自主判断任务当前所处的阶段。
2. 任务规划
面对「开发某款软件」这样的目标,它能把任务拆解成前端、后端、数据连接、文件存储等一步步的子任务。
3. 自主决策
遇到无法连网、缺少依赖等问题时,它能自己想办法解决,而不是停下来中断任务。决策能力是区分「聪明」与「不聪明」的分水岭。
4. 直接执行
这是普通聊天工具最缺的能力。智能体能创建文件、连接数据库、运行操作系统命令——而不是只告诉你该敲什么命令。
5. 记忆
在复杂项目中,你会和它进行多轮、长时间的对话。它需要记住你之前说过什么,保持上下文连贯。
6. 工具调用
最基础的包括创建文件、连接数据库,进阶的还能调用git等各类工具来达成目标。
只有同时拥有这六项核心能力的AI,才能被称作智能体。当你给它一个复杂目标,它能通过不断循环迭代,自主把任务完成并交付结果。
对安全行业意味着什么
把这套能力映射到渗透测试,就能理解AI对安全行业的冲击所在。传统渗透测试中,工程师需要手动编写扫描脚本、逐行审计代码、反复调试利用链。而具备执行与决策能力的智能体,可以把「发现—验证—修正」的循环自动化,大幅压缩重复劳动的时间。
不过需要客观看待的是,本文素材更多聚焦于智能体概念的拆解,尚未深入展示漏洞挖掘、代码审计、CTF自动化解题的完整技术细节。智能体能否稳定挖到真实漏洞、如何控制误报、面对复杂目标时决策的可靠性如何,这些仍是实战中需要持续验证的问题。对安全从业者而言,与其担心被取代,不如尽早掌握如何驾驭这类智能体工具,把它变成放大自身能力的杠杆。
渗透测试中的"发现—验证—修正"循环在学术界已有量化研究支撑。2024年麻省理工学院的一项研究显示,基于 GPT-4 的 Agent 能够在无人工提示的情况下,自主利用公开的 CVE 漏洞完成端到端的攻击链,成功率约为87%;但面对未公开的零日漏洞,效果则显著下降。这一结论与"对已知漏洞的自动化利用"与"从零发现新漏洞"之间的巨大鸿沟高度吻合——前者更多是模式匹配与工具编排,后者才是安全研究的核心挑战。对从业者而言,智能体最现实的价值在于压缩信息收集、漏洞复现和报告撰写等标准化环节的工时,而非替代需要创造性判断的高级渗透工作。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。