AI智能体设计芯片:高层抽象HLS工作流实现2.6倍加速

AHRR工作流让AI智能体先用HLS高层抽象构建设计、再用RTL细化优化,实现2.6倍加速。
这篇论文针对LLM智能体芯片设计中普遍存在的"直接操作RTL底层代码"问题,提出了AHRR(Agent-based HLS with RTL Refinement)工作流:先让智能体在高层综合(HLS)抽象上完成设计,再下沉到RTL层面回收底层优化空间。研究系统对比了直接RTL设计、智能体HLS设计、编译后HLS细化、HLS后RTL细化四种路径,在11个多样化任务的基准测试中,AHRR相比直接RTL方案取得了平均2.6倍的几何平均加速。研究以FPGA为验证平台,并指出该设计流程权衡与具体工艺无关,结论可推广至ASIC等场景。核心洞见在于:为AI智能体选择合适的工作抽象层次,本身就是智能体系统工程的关键决策。代码已在GitHub开源。
用AI智能体设计芯片,从RTL转向高层抽象
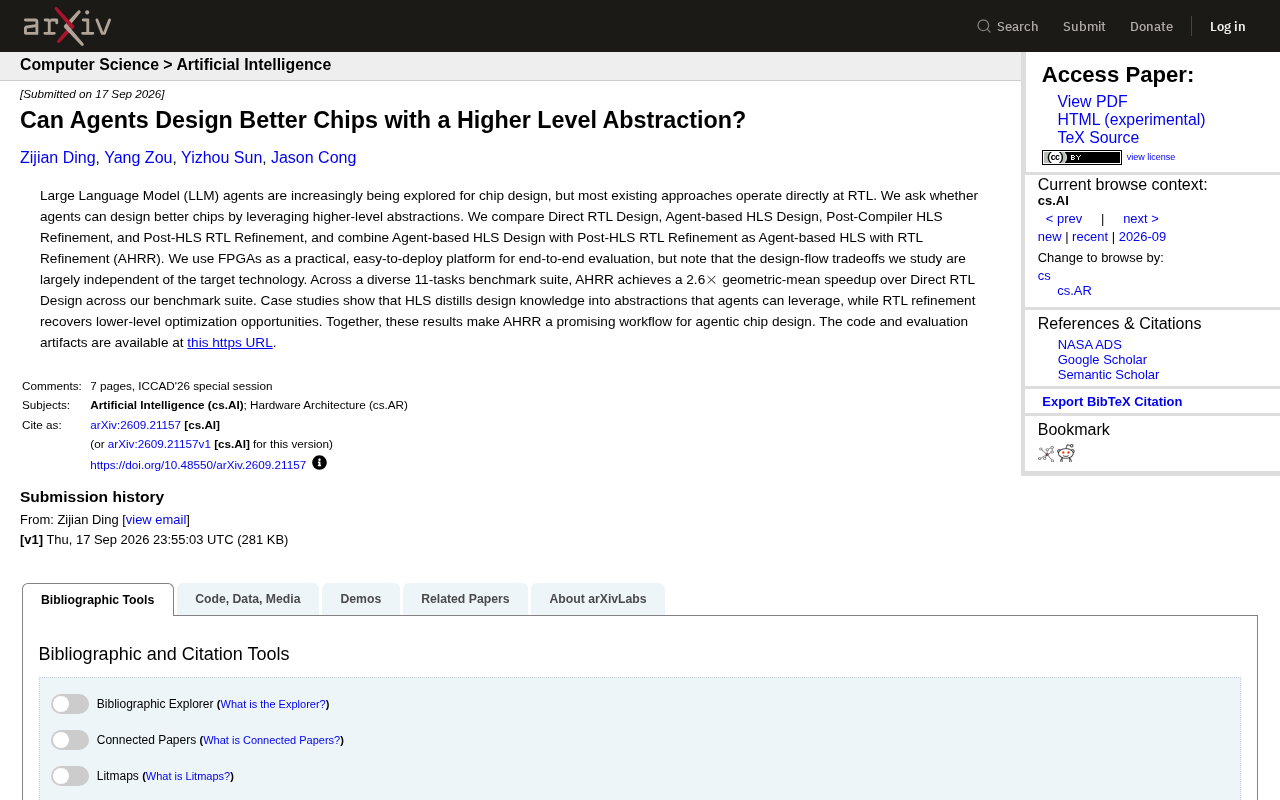
大语言模型(LLM)智能体正被越来越多地引入芯片设计流程,但目前大多数方案都直接工作在寄存器传输级(RTL)这一底层抽象上。一篇最新arXiv论文(arXiv:2609.21157)提出了一个值得深思的问题:如果让智能体在更高层次的抽象上工作,它们能否设计出更好的芯片?
答案是肯定的。研究团队通过引入高层综合(HLS,High-Level Synthesis)作为智能体的工作层,配合RTL级别的细化优化,在多任务基准测试上相比直接RTL设计取得了平均 2.6倍 的几何平均加速。这一结果为“智能体驱动的芯片设计”提供了一条颇具前景的新路径。
四种设计路径的对比实验
为了系统性地评估抽象层级对智能体设计效果的影响,研究团队设计并对比了四种不同的工作流:
直接RTL设计(Direct RTL Design)
这是目前多数LLM芯片设计智能体采用的方式,智能体直接生成和修改RTL代码。它的问题在于抽象层次太低,智能体需要处理大量底层细节,容易在复杂设计中迷失方向。
RTL(寄存器传输级,Register Transfer Level)是硬件设计中描述数字电路的一种抽象层次,设计者需要明确指定寄存器之间的数据流动、时钟边沿触发的逻辑操作以及组合逻辑结构。Verilog和VHDL是最常用的RTL描述语言。RTL设计要求设计者对时序、流水线、资源复用等底层细节有深入理解,一个中等复杂度的模块往往需要数百乃至数千行代码,其中充满了与功能逻辑无直接关系的结构性样板代码。对于LLM智能体而言,这意味着它需要在极高的"噪声"环境下维持对整体设计意图的把握,稍有偏差便会引入难以调试的时序违例或逻辑错误。
基于智能体的HLS设计(Agent-based HLS Design)
让智能体在HLS这一更高抽象层上工作。HLS将设计意图用类C语言等高级方式描述,再由编译器自动生成RTL。研究发现,HLS能够把设计知识“蒸馏”成智能体可以有效利用的抽象结构,降低了智能体的认知负担。
高层综合(HLS,High-Level Synthesis)允许设计者用C、C++或SystemC等高级语言描述硬件的行为逻辑,再由综合工具(如Xilinx Vitis HLS、Intel HLS Compiler)自动推断出对应的RTL实现,包括流水线调度、资源绑定和时序约束。HLS的核心优势在于设计者可以通过pragma指令(如pipeline、unroll、dataflow)在较高抽象层次上指导优化方向,而无需手写每一根寄存器的连线。这种方式大幅缩短了设计周期,同时也使代码更易于被具有软件编程背景的工具或模型理解和生成。对LLM智能体而言,C风格的描述语义更接近其训练语料的分布,使其能更准确地将功能需求映射为合法且高效的硬件描述。
编译后HLS细化与HLS后RTL细化
研究还评估了两种细化策略:一种是在编译器生成结果后对HLS层面进行细化(Post-Compiler HLS Refinement),另一种是在HLS生成RTL之后再对RTL进行细化(Post-HLS RTL Refinement)。后者的价值在于,它能够重新挖掘那些只有在底层才能实现的优化机会。
AHRR:融合高层抽象与底层优化
论文的核心贡献是将“基于智能体的HLS设计”与“HLS后RTL细化”结合,提出了名为 AHRR(Agent-based HLS with RTL Refinement) 的完整工作流。
这个组合的设计理念很清晰:先让智能体在高层抽象上快速构建结构合理、逻辑清晰的设计,再回到RTL层面回收底层优化空间。用研究团队的话说,HLS负责“将设计知识蒸馏为智能体可利用的抽象”,而RTL细化则“恢复了底层的优化机会”。两者结合,既发挥了高层抽象的效率优势,又保留了底层调优的精细度。
在一个包含 11个多样化任务 的基准测试套件上,AHRR相比直接RTL设计实现了2.6倍的几何平均加速。这一数字表明,抽象层次的选择对智能体芯片设计的效果有着实质性影响。
FPGA作为验证平台与结论的普适性
研究团队选择FPGA作为端到端评估平台,原因在于其部署便捷、迭代快速,适合做完整工作流的验证。不过论文特别强调,他们所研究的设计流程权衡(design-flow tradeoffs)在很大程度上与目标工艺无关——也就是说,AHRR的思路不仅适用于FPGA,也有望迁移到ASIC等其他芯片实现路径上。
案例分析进一步印证了这一结论:HLS抽象帮助智能体更好地理解和组织设计,而RTL细化则补足了纯高层方法在性能上的短板。这种“先抽象后细化”的分层策略,可能会成为未来智能体芯片设计的一种通用范式。
FPGA(现场可编程门阵列)是一种可在出厂后通过编程反复配置其内部逻辑结构的集成电路,与一次性流片的ASIC相比,其迭代成本极低,非常适合作为设计方法论研究的验证载体。FPGA的资源单元(查找表LUT、触发器FF、DSP块、片上存储BRAM)与ASIC的标准单元在抽象结构上存在差异,但RTL设计范式和HLS工具链在两类平台上高度一致。这意味着在FPGA上验证的工作流优化策略,其核心逻辑同样适用于面向台积电、三星等工艺节点的ASIC设计流程,只需替换后端综合与布局布线工具即可。这也是论文声称结论具有跨工艺普适性的技术依据。
对智能体芯片设计的启示
这项工作最重要的意义,或许不在于2.6倍这个具体数字,而在于它揭示了一个方向性洞见:让AI智能体在合适的抽象层次上工作,比单纯堆砌算力或让它硬啃底层代码更有效。
对于正在探索AI辅助硬件设计的团队来说,这提供了一个可复现的参考框架。研究团队已经将代码和评估工件开源(GitHub: ZijD/AHRR),感兴趣的开发者可以基于此进一步验证和拓展。
随着LLM智能体能力的不断提升,如何为它们设计合理的“工作抽象”将成为一个关键课题。AHRR的实践表明,抽象层次的工程选择,本身就是智能体系统设计的重要组成部分。
相关推荐

《Braid》的时间旅行机制:游戏设计中的时间魔法
深入解析独立游戏《Braid》的时间旅行机制:全局倒流、时间与空间绑定、影子分身等玩法设计,以及背后的状态记录与回放工程挑战,探讨机制即叙事的游戏设计理念。

Codex零基础入门教程:安装、模型选择与实战全解析
Codex零基础完整教程:涵盖安装方式、模型与推理等级选择、电脑控制与浏览器自动化插件、国际象棋实战项目、Compact/Fork/Plan/Shopping命令、AGENTS.md记忆机制及定时任务,手把手带你上手OpenAI的全能AI编程工具。

OpenSwarm:让智能体接管整台机器的AI优先操作系统
OpenSwarm是一款AI优先的操作系统,让智能体群接管整台机器——应用自生成、浏览器自驱动、多智能体协同作业。本文解析其核心理念、三大能力与现实挑战。