AI智能体是怎么工作的?拆解核心的Agent Loop

所有AI Agent本质上都是同一个「模型决策+代码执行」的四步循环,搞懂它就理解了所有智能体平台。
本文拆解了AI Agent底层通用的「Agent Loop」机制,指出无论是编程助手、客服机器人还是各大厂商的托管平台,驱动它们的都是同一套四步循环:应用发送请求与工具清单→模型返回结构化工具调用→应用代码执行工具→结果写回历史后再次调用模型,直至模型给出纯文本答案为止。文章强调了一个最易被误解的核心:模型只做决策,从不亲自执行任何操作,真正的执行者始终是开发者自己的代码。在工程层面,作者还点出两个实际构建时必须面对的问题:每轮重发完整历史导致长任务成本膨胀,以及缺少轮数与预算上限可能引发死循环,并给出了缓存、压缩等对应手段。
编程助手、浏览器智能体、客服机器人——你听说过的几乎每一个AI Agent,底层都跑在同一个简单的循环之上。Anthropic、OpenAI、AWS 近期都推出了各自的托管式智能体平台,名字各不相同,但引擎其实是同一套。搞懂这个循环,你就理解了它们全部。
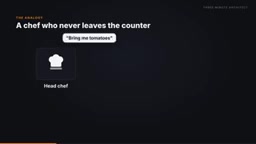
一个比喻:永远不离开料理台的主厨
想象一位主厨,她从不离开自己的操作台。她读过订单后喊一声:「给我拿番茄来!」助手跑去取回。她再看一眼,决定下一步该做什么。她自己从不走进储藏室。
这正是大语言模型与工具协作的方式。模型负责「思考和决策」,但从不亲自执行动作;真正跑腿取货的,是模型之外的代码。理解了这个分工,就抓住了Agent设计的核心。
Agent Loop 的四个组成部分
真正的机制由四个部分构成:你的应用(App)、模型(Model)、你的工具(Tools),以及对话历史(Conversation History)。整个流程在这四者之间循环流转。
第一步:发送请求与工具清单
你的应用把用户的请求发给模型,同时附上一份模型「可以使用」的工具列表。每个工具都有一个名字和一套输入 schema(输入参数的结构定义),告诉模型这个工具能干什么、需要哪些参数。
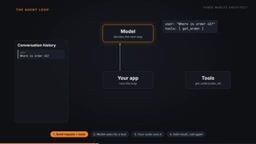
输入 schema 通常以 JSON Schema 格式描述,例如一个 getOrder 工具的 schema 可能声明它需要一个字符串类型的 order_id 参数。模型在训练阶段已经学会读懂这类结构化描述,因此能在推理时自主判断:当前任务是否需要调用某个工具,以及应该传入什么参数。工具清单的设计质量直接影响 Agent 的行为——描述模糊的工具会导致模型误调用或参数填写错误,而过多的工具则会分散模型的注意力,增加选错工具的概率。实践中,工具名称和描述字段(description)是模型做决策的主要依据,写清楚「这个工具在什么场景下使用、不适合什么场景」往往比罗列参数更重要。
第二步:模型返回「工具调用」而非答案
关键之处在于:模型此时并不直接给出答案,而是返回一个「工具调用」(tool call)——一个结构化的请求,比如 getOrder,并把参数填好。在 Claude 的 API 中,这时的停止原因(stop reason)会标记为 tool_use,明确告诉你的应用:模型想调用一个工具。
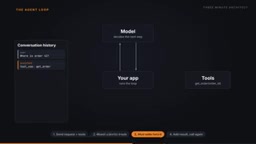
第三步:由你的代码执行工具
收到工具调用后,是你的应用去真正运行这个工具。这是整个机制里最容易被误解的一点:模型永远不会自己执行任何操作,执行的是你的代码。 模型只是「决策者」,调用数据库、访问 API、读写文件这些实际动作,全部发生在你的程序里。
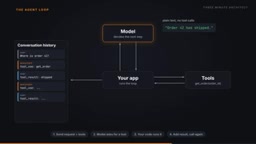
第四步:把结果写回历史并再次调用
工具跑完后,你的应用把结果追加进对话历史,再一次调用模型。于是循环开始了:调用 → 工具 → 结果 → 再调用……如此往复,直到模型以纯文本形式给出回答、不再发起任何工具调用为止。那就是最终答案,Claude 会把它标记为 end_turn。
OpenAI 的 Agents SDK 以同样的方式结束循环,并且在一次运行超过 max turns(最大轮数)限制时会抛出错误。可见不同厂商的平台虽然命名不同,但「循环直至无工具调用」的终止逻辑是一致的。
两个必须留意的工程细节
理解了循环本身,还有两个在实际构建中绕不开的问题。
第一,每一轮都会把完整的历史再发送一次。 这意味着任务越长,上下文越大,调用就越慢、越贵。常见的应对手段是缓存(caching)和压缩(compaction)——前者复用已处理过的上下文,后者则对历史做精简,二者都能有效控制长任务的成本膨胀。
第二,一定要给循环设上限。 设置轮数上限(turn limit)和预算上限(budget),可以防止 Agent 陷入「原地打转」的死循环。一个没有封顶的 Agent,既可能把费用烧穿,也可能永远跑不出结果。
缓存(caching)在主流 API 中通常以「prompt caching」的形式提供:若本次请求的上下文前缀与上一次完全相同,服务端可复用已计算的 KV 缓存,从而降低延迟和 token 费用。Anthropic 和 OpenAI 均支持此特性,但需要开发者在请求中显式标记可缓存的边界。压缩(compaction)则是另一种思路:当对话历史超过一定长度时,用一段更短的摘要替换早期的多轮对话,牺牲部分细节换取上下文窗口的空间。两种方案并不互斥,长任务 Agent 往往需要同时使用:先靠缓存复用稳定的系统提示和工具定义,再靠压缩处理不断增长的历史对话。
一句话总结这套机制
所谓 AI Agent,本质就是「一个处在循环中的模型,加上替它干活的你的代码」。模型负责一轮轮地判断下一步该调用什么工具,而真正的执行、结果回填、循环控制与成本管理,都由应用层承担。无论是编程助手还是客服机器人,无论底层是 Claude 还是 OpenAI,剥开外壳看到的都是同一个 Agent Loop。当你下次评估或自己动手搭建一个智能体时,先问清楚它的工具清单、终止条件和成本控制策略,基本就能看透它的运作方式。
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。