AI智能体挖洞实战:从传统三步法到自动化漏洞挖掘

AI Agent介入漏洞挖掘三步法,大幅降低门槛并将提交效率提升至传统方式的百倍以上。
本文以SRC漏洞挖掘为场景,阐述AI如何改造传统"万能挖洞三步法"。传统流程全程依赖人工推进,经验壁垒高、效率低,新手需三到六个月才能入门。引入AI Agent后,信息收集环节可自动生成结构化资产清单,分析环节可智能过滤误报并聚焦高危漏洞,报告环节可按格式生成初稿。文章特别强调,真正有效的工具是能执行命令、调用工具、连续决策的AI Agent(如Codex、Claude),而非普通问答型AI。AI挖洞的核心价值在于降低学习门槛、提升效率,有人借此一年提交超1.4万个漏洞;但决策与验证责任始终在人,报告提交前必须经人工精审,否则可能被平台拉黑。
传统漏洞挖掘:高门槛与经验壁垒
在SRC漏洞挖掘领域,有一套被广泛使用的"万能挖洞三步法"。第一步是完整访问目标站点,摸清功能结构、底层技术和数据接口,覆盖注册、登录、支付、退款退货等所有业务流程。第二步是抓包分析,了解每个访问过程涉及的路径与参数,定位可能的风险判断点,再通过篡改参数向目标站点提交,验证漏洞是否存在。第三步是验证漏洞并撰写漏洞报告。
这套流程的核心问题在于——三步全部靠人推进,效率和实操经验强相关。经验越丰富,效率越高;经验不足,效率就会明显降低。NMAP、Telnet、NC、Burp Suite等工具跑出来的结果,还需要人工核实。比如工具报出服务器开放了22端口或3306端口,这究竟是真漏洞、误报,还是只是未加强防护,都需要人去判断。
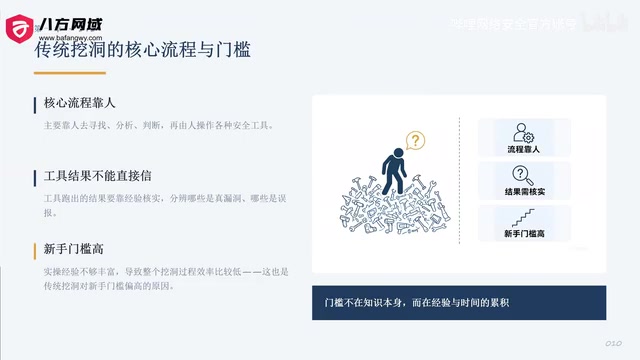
对新手而言,门槛主要不在知识本身,而在于经验积累和时间投入。很多人即使学完了入门课程,依然难以进入有效的挖洞状态。网络安全是综合性学科,工具繁多、学习曲线陡峭,实战经验不足时试错成本极高,往往需要三到六个月才能把基础打扎实。
SRC(Security Response Center,安全响应中心)是企业为接收外部安全研究人员提交漏洞报告而设立的平台,国内主要互联网公司如阿里、腾讯、字节跳动等均有自己的SRC。研究人员发现并提交有效漏洞后,可获得积分、奖金或荣誉激励。文中提到的Burp Suite是一款专为Web应用安全测试设计的集成工具,核心功能是拦截并修改浏览器与服务器之间的HTTP/HTTPS流量(即"抓包"),是渗透测试中最常用的工具之一。NMAP用于端口扫描和网络探测,NC(Netcat)常用于网络连接调试,Telnet则可测试端口连通性。这些工具各司其职,但输出结果均需依赖人工判断,这正是新手难以高效利用它们的根本原因。
AI 介入后:三步法的三重改变
把 AI 引入漏洞挖掘流程,三步法的每个环节都发生了实质性变化。
信息收集更清晰。 过去挖洞主要靠自己逐页点击访问,现在可以让 AI 先"洗一遍盘"——探测 Web 服务器后端架构、前端形态、认证方式、所用数据库及访问方式。AI 能盘点出功能模块、路由入口,标注每个入口承担的业务及参数形态,最终输出结构化的资产清单。表里会清楚列出功能对应的接口、如何验证,人只需复核即可,不必从零手动收集。
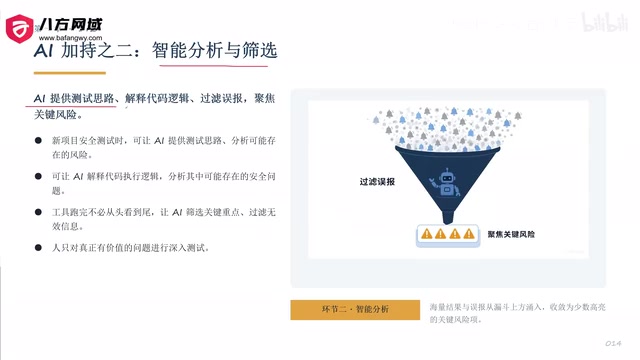
智能分析与筛选。 第二个环节中,AI 能提供测试思路,对不懂的代码给出解释,并过滤误报。挖洞过程中常常面对海量结果和误报,AI 可以筛掉大部分噪声,把注意力聚焦到严重、高危、中危漏洞上。低危漏洞数量可能很多但不急于处理,而严重和高危漏洞需要立即着手。借助 AI,筛选范围更大、结果更准确,人只对真正有价值的问题深入测试。
报告生成更轻松。 在筛选和报告阶段,AI 可以调用工具、执行命令、生成报告。Kali 系统里工具众多,让人熟练掌握每一个几乎不可能,而 AI 可以方便地调度这些工具并做筛选。漏洞报告的四要素——漏洞 URL、复现过程、危害性、修复建议——AI 都能按格式生成初稿。
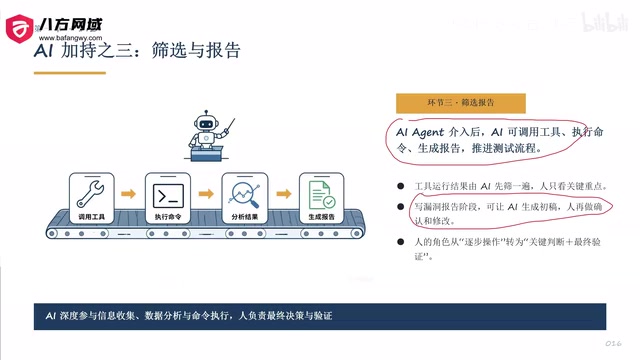
但要特别注意,AI 生成的只是初稿,最终提交前必须人工精审:复现 URL 是否真有问题、复现过程是否准确、危害是否如报告所述。如果全部交给 AI 自动提交,很可能被拉入黑名单。报告这一环,最终必须由人来敲定。
关键区别:AI Agent 而非问答工具
这是全文最核心的一点。能真正起到挖洞作用的,不是像 DeepSeek广告、通义千问广告网页端那样一问一答的聊天工具,而是能够执行工具、连续判断、找出挖掘步骤并执行这些步骤的 AI 智能体(Agent)。
换句话说,不能用"仅能解答问题"的 AI 来挖洞,而应该使用能直接参与实际漏洞挖掘工作流的工具。视频中提到的可用智能体包括 Codex、Claude(Cloud)、以及 Tree、早期的 OpenCloud、Amos Agent 等。
这些智能体能做什么?读取并分析项目工程代码、理解代码实现逻辑、指出安全问题、执行探测与测试命令、调用安全类工具对目标进行渗透测试。引入的不是一个问答框,而是一个能动手的 Agent。
AI Agent(智能体)与普通对话式AI的本质区别在于"行动能力"。对话式AI(如网页版ChatGPT、DeepSeek)只能接收文本输入并返回文本输出,无法主动调用外部工具、执行系统命令或持续跟踪多步任务。而AI Agent具备工具调用(Tool Use)能力,可以直接调用终端命令、调用API、读写文件,并根据上一步的执行结果自主决定下一步行动,形成"感知—决策—执行"的循环。文中提到的Codex是OpenAI推出的代码能力模型,Claude(Anthropic出品)同样具备较强的代码理解与工具调用能力。在漏洞挖掘场景中,Agent能够自主驱动Nmap扫描、解析输出、调用Burp Suite、分析响应,并将整个流程串联起来,而不需要人在每一步手动介入。
AI 挖洞的核心价值与边界
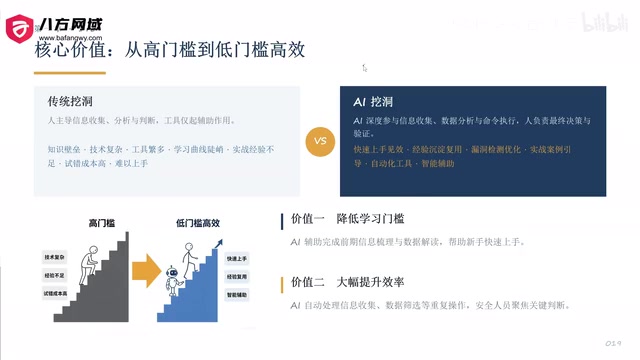
有了 AI Agent 的深度参与,漏洞挖掘从以人为主导的信息收集、分析、判断,转变为由 Agent 承担信息收集、数据分析、命令执行,人则负责决策和验证——验证漏洞是否真实存在,并撰写报告提交。
核心价值体现在两点。一是降低学习门槛,打破网络安全技术复杂、学习曲线陡峭带来的壁垒。二是大幅提升挖洞效率。按传统方式,有人一年可能只提交几十到上百个漏洞;而借助 AI 挖洞,有人一年提交了超过一万四千个漏洞。
需要清醒认识的是,AI 挖洞并不是让智能体替代人去挖洞、放手不管。它的作用是降低门槛、提高效率,把那些大量依赖经验和长期时间投入的工程变得可以正常推进。决策与验证的责任,始终在人这一侧。
一年提交超过一万四千个漏洞,折算下来每天约38个,这一数字侧面反映了AI批量化处理信息收集与初步验证的能力上限。值得注意的是,SRC平台对漏洞质量同样有审核机制,低质量或重复漏洞通常不计分甚至会被降低信用评级。因此这一效率提升的前提,是AI筛选出的漏洞具备足够的真实性与可复现性,这也是文章反复强调"人工精审"不可省略的原因。此外,在授权范围之外对系统发起漏洞探测在多数司法管辖区属于违法行为,AI Agent自动执行扫描和渗透命令时,使用者需对测试目标的合法授权负完全责任。
相关推荐

Claude Code本地化部署全解析:用本地模型玩转Vibe Coding
深入解析Claude Code本地化部署原理:如何用Ollama、vLLM等推理引擎将本地模型包装成API服务,让Claude Code脱离云端运行,摆脱token成本。涵盖显卡配置、模型选型与量化技巧。

Normalizing Trajectory Models:让少步生成重拾精确似然框架
Normalizing Trajectory Models(NTM)将扩散模型反向过程的每一步建模为条件归一化流,实现少步生成下的精确似然训练,兼顾速度与概率框架完整性,突破蒸馏与一致性训练的局限。

LangGraph生产级实战:五年Agent架构经验的沉淀
一位五年Agent开发老兵开源LangGraph生产级参考项目并撰写博客系列,分享从条件树到图状态机的架构演进经验,剖析LangGraph在可维护性与团队协作上的真正价值。