AI智能体需要全新的安全模型吗?传统方案为何失灵
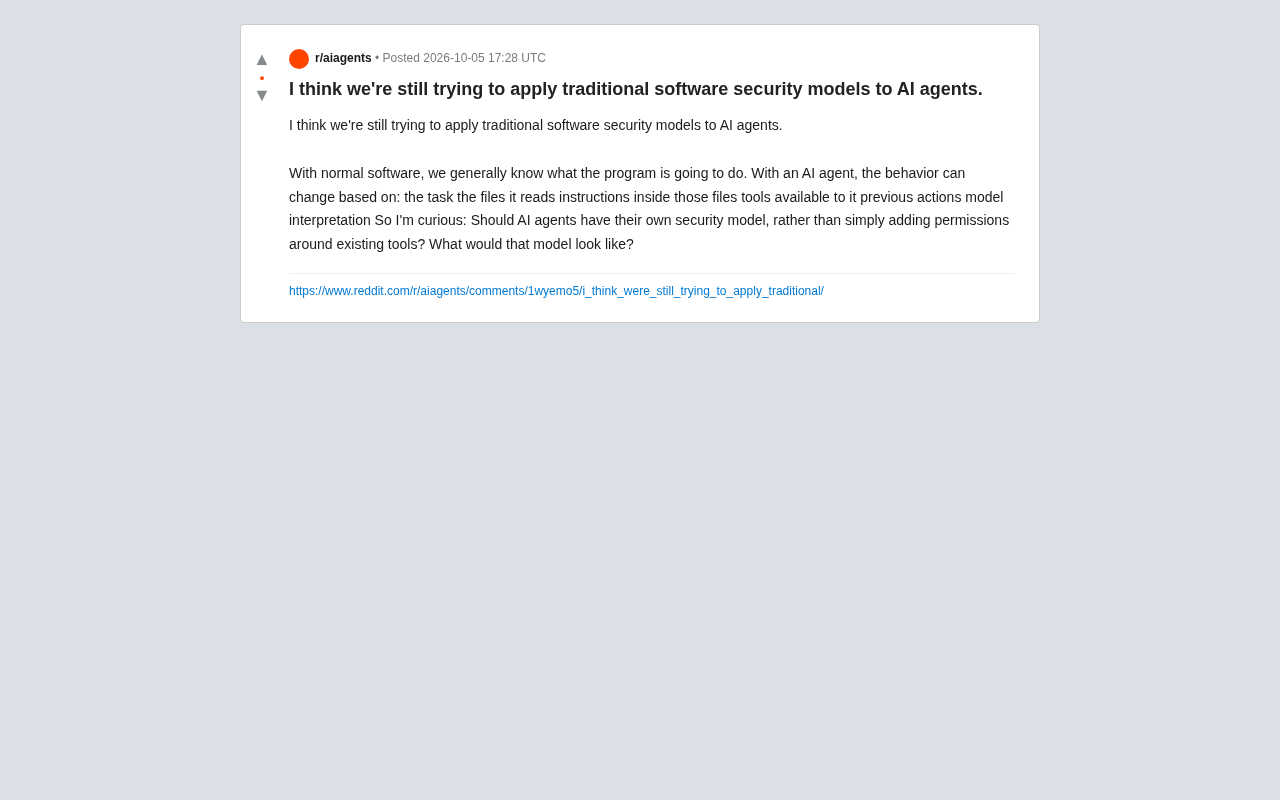
传统权限控制无法应对AI智能体的概率性行为,行业需要从意图验证到运行时监控的全新安全范式。
文章指出,AI智能体的行为由任务目标、读取内容、可用工具、历史动作和模型解读共同动态决定,根本上颠覆了传统软件"输入确定、行为可预测"的前提。当前主流做法是在现有工具外叠加权限控制,但这种静态ACL模型只能约束单个工具的访问,无法防御"合法权限的危险组合"——提示注入攻击正是利用这一盲区,通过在智能体读取的外部内容中埋入指令来劫持行为,全程不触碰任何权限边界。文章勾勒了专属安全模型的四个方向:意图层面约束、数据与指令信任分级、行为链实时监控,以及最小化可回滚操作。核心论点是:AI智能体的概率性与自主性本质,要求行业重新设计安全范式,而非修补面向确定性系统的传统机制。
当传统安全模型遇上AI智能体
一个在Reddit上引发讨论的观点正在触及AI工程领域的痛点:我们是否还在用传统软件的安全思维来约束AI智能体(AI Agent)?
传统软件的核心特征是行为可预测。给定相同的输入,程序会执行相同的逻辑路径,输出结果也在可控范围内。正因如此,我们的安全模型建立在明确的边界之上——权限控制、输入校验、沙箱隔离,这些机制本质上都在约束一个“我们已知其行为”的系统。
但AI智能体打破了这个前提。它的行为并非由固定代码路径决定,而是由多个动态因素共同塑造。原帖作者精准地列举了这些变量:被分配的任务、读取的文件内容、文件内部暗藏的指令、可调用的工具、此前执行的动作,以及模型本身对上下文的解读方式。
为什么“加权限”不够用
当前主流做法是在现有工具外层叠加权限控制——限制智能体能访问哪些文件、能调用哪些API、能执行哪些系统命令。这种思路本质上是把传统的访问控制列表(ACL)套用到了AI身上。
问题在于,这种静态权限模型假设“风险来自工具本身”,而AI智能体的风险往往来自行为的组合与演化。一个智能体可能拥有完全合法的单项权限,却因为读取了一份被恶意构造的文件,而把这些权限串联成一次危险操作。
这正是提示注入(Prompt Injection)攻击的核心逻辑:攻击者不需要突破任何权限边界,只需在智能体会读取的文件、网页或邮件中埋入指令,就能劫持它的行为。传统安全模型对此几乎无能为力,因为从权限层面看,智能体“什么都没做错”。
行为不确定性带来的三重挑战
上下文即攻击面:对传统程序而言,数据就是数据。但对AI智能体来说,它读取的任何内容都可能被解读为指令。数据与指令之间的边界被彻底模糊,这是传统安全模型从未面对过的局面。
权限的动态组合:单个权限的安全性无法保证组合后的安全性。智能体可以在一次任务中以人类难以预判的方式串联多个工具调用。
模型解读的不可控:同样的输入,模型可能在不同上下文下给出不同判断。这种概率性行为让“白名单/黑名单”式的确定性规则失去意义。
一个专属安全模型可能长什么样
原帖提出了关键问题:AI智能体是否应该拥有自己的安全模型,而非简单地在现有工具上包权限?虽然原帖并未给出答案,但从问题本身出发,可以勾勒出几个值得探索的方向。
意图层面的约束。与其只控制“能调用哪些工具”,不如在任务意图层面建立护栏。智能体在执行前,需要对照原始任务目标验证当前动作是否偏离,一旦检测到行为与初始意图不符就触发中断。
数据与指令的信任分级。既然上下文可能携带恶意指令,就需要为不同来源的内容标注信任等级。来自用户的直接指令、来自内部可信文档的信息、来自外部网页的内容,应当被赋予不同的“指令执行权重”,低信任来源的内容不应被当作可执行命令。
行为链的实时监控。相比静态权限审批,运行时的行为审计可能更关键。记录智能体的完整决策链条,对异常的工具调用组合进行实时拦截,让安全机制跟随行为演化而非固定在初始配置。
最小化与可回滚。每一步操作都应遵循最小权限原则,并尽可能保证可逆。当智能体行为的不可预测性无法完全消除时,降低单次错误的破坏半径就成为务实的选择。
上述方向在学术界和工业界已有若干早期实践可供参考。护栏(Guardrails)框架(如NVIDIA NeMo Guardrails、Guardrails AI)试图在模型输出前后插入规则检测层,但目前多聚焦于内容过滤而非行为意图验证。**最小权限智能体(Least-Privilege Agent)**的概念借鉴自操作系统安全,Anthropic在其Model Card中提出"有限行动空间"设计原则,建议为智能体提供完成任务所需的最窄工具集。可解释行为日志方面,LangChain等框架提供了基础的工具调用链追踪,但离真正意义上的实时异常拦截仍有差距。信任分级思路则与W3C提出的"数据来源溯源"(Data Provenance)研究方向高度吻合——为内容附加可验证的来源元数据,是将信任模型落地为工程实现的潜在路径之一。这些探索表明专属安全范式的轮廓正在形成,但尚无公认的完整方案。
这场讨论的真正价值
这个Reddit帖子之所以值得关注,不在于它给出了答案,而在于它提出了一个被行业长期忽视的框架性问题。随着AI智能体加速进入生产环境——从代码助手到自动化运维,从客服系统到数据分析——安全模型的滞后正在成为真实风险。
传统软件安全建立在“确定性”之上,而AI智能体的本质是“概率性”和“自主性”。用约束确定性系统的工具去管理一个会自主解读、自主决策的系统,注定会留下结构性的缝隙。
行业需要的或许不是对现有安全机制的修补,而是一套从智能体行为本质出发重新设计的范式。这套范式应当承认行为的不确定性,并围绕意图验证、信任分级、运行时监控来构建防线。在AI智能体大规模落地之前,这个问题越早被认真对待越好。
背景补充
提示注入(Prompt Injection)本质上是一种针对大语言模型的输入劫持攻击,可分为两类:直接注入指攻击者直接在对话框中输入恶意指令,覆盖系统预设的行为规则;间接注入则更为隐蔽,攻击者将指令埋入智能体会主动读取的外部内容中——例如一份PDF报告的页脚、一个网页的白色文字、一封邮件的隐藏字段——当智能体处理这些内容时,恶意指令便随正常数据一起进入模型上下文并被执行。2023年曾有研究人员演示通过在网页中嵌入不可见文字,成功让配备浏览工具的ChatGPT泄露用户对话历史。间接注入对自主智能体的威胁尤为严重,因为智能体会主动探索外部环境,天然扩大了攻击者可植入恶意内容的"投放面"。
相关推荐
美国最东与最西点之谜:地理坐标与航行方向的两种答案
美国的最东点和最西点究竟在哪里?按经度算,阿拉斯加同时是最北、最西、最东;按航行方向算,答案却是关岛和圣克罗伊岛的乌德尔角。本文解析两种地理定义背后的逻辑与巧合。

12个让人直呼"离谱"的个人AI助手实用场景
科技博主Matthew Berman演示12个个人AI助手实用场景:用Grokbot自动谈判订阅省钱、控制特斯拉、管理家庭日程、会议纪要、邮件分流和账单优化,附提示词设计思路与风险边界分析。

从Demo到上线:AI Agent工程化落地的关键差距
搭建AI Agent很容易,真正部署上线才是难点。本文从一位开发者的八晚实战课程切入,剖析Demo与生产级系统之间的工程化鸿沟,包括稳定性、成本控制与部署落地的关键差距。