AI智能体总是过度索取数据?数据最小化的落地难题与解法

AI智能体因通用API过度获取数据,需从架构层强制落实数据最小化原则。
在构建AI智能体的实践中,一个普遍存在的隐患是:智能体通过通用API获取的数据远超完成任务的实际需要。一旦完整的客户记录进入模型的上下文窗口,账单、消费习惯等敏感字段便暴露在推理链路和运行日志中,违背了GDPR等法规明确要求的数据最小化原则。文章梳理了应对这一问题的多种方案:为每个用例构建专用端点最为彻底,但维护成本随用例数量线性增长;更务实的中间方案包括API网关的响应层字段过滤、基于任务的数据访问控制范围划分,以及用派生计算字段替代原始敏感数据。核心结论是:AI智能体的数据治理不能依赖模型的"自觉",必须在数据离开可信后端之前,通过架构手段强制约束其可见范围。
问题的根源:API返回了比任务需要更多的数据
在构建AI智能体(AI Agent)的实践中,一个常被忽视却极其棘手的问题正浮出水面:智能体几乎总是会请求超出任务所需的数据。
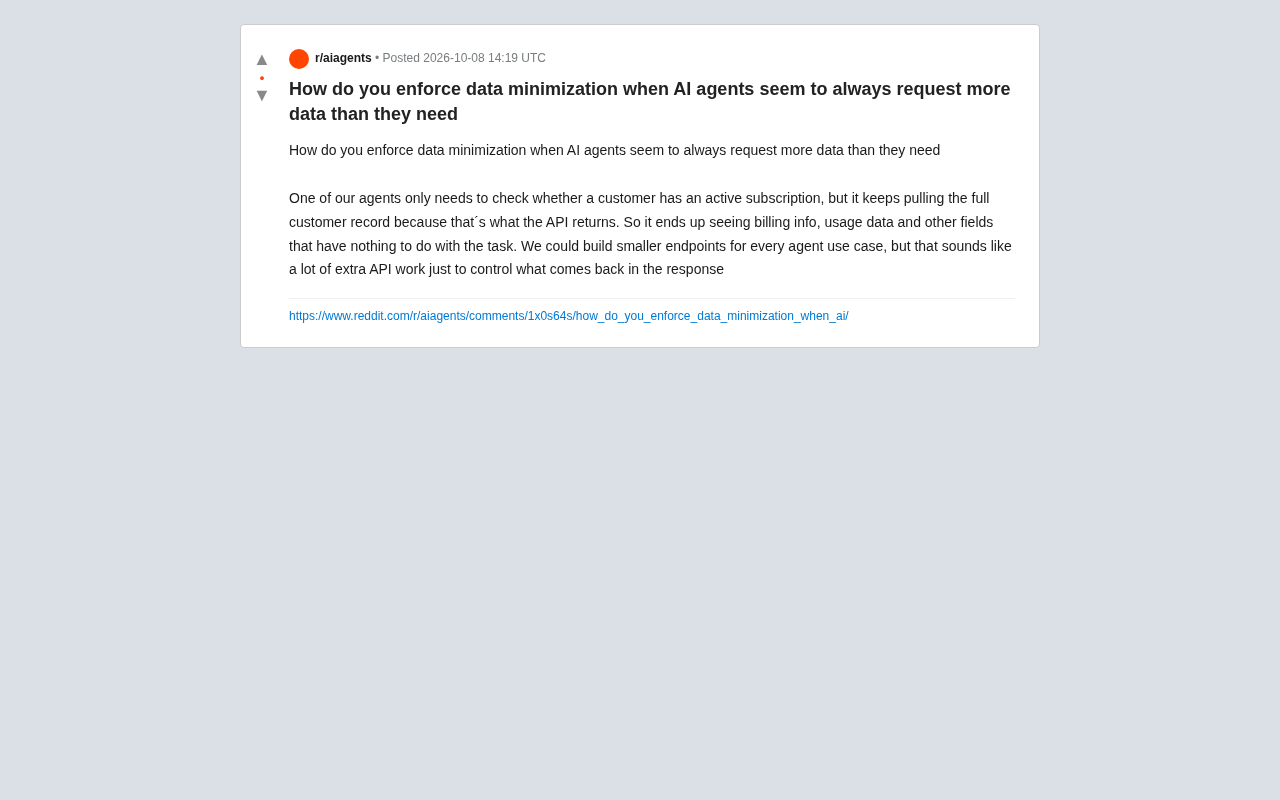
一位Reddit用户分享了典型场景:他们有一个智能体,任务仅仅是检查某个客户是否有有效订阅。按理说,这只需要一个布尔值(是/否)即可完成。但由于后端API的设计是返回完整的客户记录(full customer record),这个智能体最终「看到」了账单信息、使用数据以及其他与任务毫无关联的字段。
这不是一个孤立的工程细节,而是触及了数据治理中的核心原则——数据最小化(Data Minimization)。该原则要求系统只收集、处理和暴露完成特定任务所必需的最少数据。在GDPR等隐私法规中,数据最小化是明确的合规要求。而当AI智能体介入时,这个原则的执行变得格外困难。
为什么AI智能体让数据最小化更难
传统应用中,开发者对数据流有精确的控制:代码明确知道需要哪些字段,并只处理这些字段。但AI智能体引入了新的变量。
智能体往往通过通用API获取「上下文」,然后由大语言模型自行判断如何使用这些信息。问题在于,模型拿到的是什么,它就「知道」什么。即便任务只是校验订阅状态,一旦完整客户记录进入模型的上下文窗口,账单、消费习惯等敏感字段就已经暴露在推理链路中——这些数据可能被记录在日志里,可能影响模型输出,也可能在多轮对话中被意外引用。
换句话说,AI智能体的「最小必要」边界比传统程序更模糊。模型天然倾向于「多多益善」,而底层API的粗粒度设计又在不断喂给它过量数据。
大语言模型的上下文窗口(Context Window)机制是理解这一问题的关键。模型在推理时会将所有输入信息——包括系统提示、工具调用的返回结果、历史对话——一并纳入"注意力"范围。这意味着,一旦完整客户记录以JSON格式出现在上下文中,模型在生成回复时理论上可以引用其中任何字段,而开发者往往无法精确预测模型会"注意到"并使用哪些内容。此外,许多智能体框架会将完整的推理链路(包括工具调用的原始响应)写入运行日志以便调试,这进一步扩大了敏感数据的实际落地范围。与传统代码中变量作用域严格隔离不同,模型的"感知边界"与数据传入边界完全重合,这是AI智能体在数据治理上天然比传统程序更难收敛的根本原因。
为每个用例构建专用端点,值得吗
原帖提到了最直接的解法:为每个智能体用例构建更小、更专用的API端点。比如专门做一个 check-subscription-status 接口,只返回一个布尔结果。
这个方案在数据最小化层面是最彻底的——从源头上就不让多余数据离开后端。但正如发帖者所顾虑的,这意味着大量额外的API开发工作。每新增一个智能体任务,可能就要配套一个新端点,长期来看会造成接口膨胀和维护负担。
专用端点的权衡
- 优点:数据从不离开可信边界,合规性最强,攻击面最小。
- 缺点:开发维护成本高,接口数量随用例线性增长,灵活性差。
对于高敏感、高频的核心场景,专用端点依然是最稳妥的选择;但要为所有长尾用例都这么做,投入产出比确实不划算。
更务实的中间方案
除了「为每个用例造轮子」,实践中还有几种折中思路,可以在不重写所有API的前提下收敛数据暴露:
1. 响应层字段过滤
在API网关或中间层加一道「字段白名单」过滤。原始API仍返回完整记录,但在数据抵达智能体之前,由代理层剥离掉与任务无关的字段。GraphQL的按需查询(client-specified fields)天然适配这一思路——调用方只声明需要的字段,服务端只返回这些字段。
GraphQL之外,BFF(Backend for Frontend)模式也是实现响应层字段过滤的常见架构选择。BFF层专门为某一类客户端或用例裁剪后端数据,聚合多个微服务的返回并只向上游暴露必要字段,本质上充当了一个可编程的数据精简代理。对于已有REST架构的团队,也可在API网关(如Kong、Nginx)配置响应转换插件,通过JSON Path规则在流量层剔除敏感字段,无需修改后端服务本身。这类"数据门廊"方案的优势在于改造成本较低、可集中审计,但需要注意:字段过滤规则必须随业务变更同步维护,否则新增字段可能悄然穿透过滤层而不被察觉。
2. 基于角色/任务的数据访问控制
为不同的智能体任务分配不同的数据访问范围(scope)。订阅校验智能体只被授予订阅状态字段的读取权限,即便它调用了通用接口,权限层也会拦截并屏蔽越权字段。这把控制逻辑从「API设计」转移到了「访问策略」,更易集中管理。
3. 数据脱敏与派生字段
在把数据交给模型前,用派生值替代原始敏感数据。例如不传完整账单,而是传一个 has_active_subscription: true 的计算字段。模型拿到的是任务所需的结论,而非可被滥用的原始明细。
核心启示:把数据最小化前移到架构层
这场讨论的真正价值,在于提醒我们:AI智能体时代的数据治理,不能依赖模型的「自觉」,而要在架构层面强制约束。
模型永远不会主动放弃它能拿到的数据。因此,真正的控制点应当落在数据离开可信后端之前——无论是通过专用端点、网关过滤、权限范围还是字段派生。与其让智能体「看到后再决定不用」,不如从一开始就让它「根本看不到」。
对于正在落地AI智能体的团队,这意味着在设计阶段就要回答一个问题:这个智能体完成任务,到底需要哪一个字段?把答案固化到接口或策略里,才是数据最小化真正可执行的路径。
从合规角度看,GDPR第5条第1款(c)项明确将数据最小化列为个人数据处理的基本原则,要求数据"限于与处理目的相关且必要的范围"。在AI智能体场景下,一旦模型将敏感字段纳入推理或日志,监管机构可能认定这已构成对该数据的"处理",即便开发者的主观意图并非如此。因此,架构层的强制约束不仅是工程最佳实践,也是规避合规风险的必要措施。部分企业已开始在AI智能体的数据访问审计报告中增加"实际传入上下文的字段列表"这一维度,以证明其符合数据最小化要求——这也侧面说明,仅靠"模型不会主动使用"这一假设来应对合规审查是远远不够的。
相关推荐

LangChain的商业模式还能走多远?LangSmith面临的生存挑战
LangChain的核心营收依赖LangSmith,但AWS Omni等云厂商原生可观测性工具的崛起正在挤压其增长空间。本文分析独立AI开发工具与云原生方案的护城河之争,以及LangChain面临的商业化挑战。

用强化学习在UE5中训练AI钢铁侠:PPO算法救援13名乘客实验
一位开发者在虚幻引擎5中用PPO强化学习算法训练AI钢铁侠,让其学会飞行救援13名下坠乘客。本文解析该体素风格项目的技术思路、PPO选型逻辑与UE5仿真训练的价值与局限。

传奇设计师Richard Garriott重掌《创世纪》系列版权
游戏传奇设计师Richard Garriott正式重新获得经典RPG系列《创世纪》(Ultima)的控制权。本文解读这一版权回归对玩家与游戏行业的潜在意义。