AI助手横向对比:Grok、Claude与ChatGPT谁更胜一筹
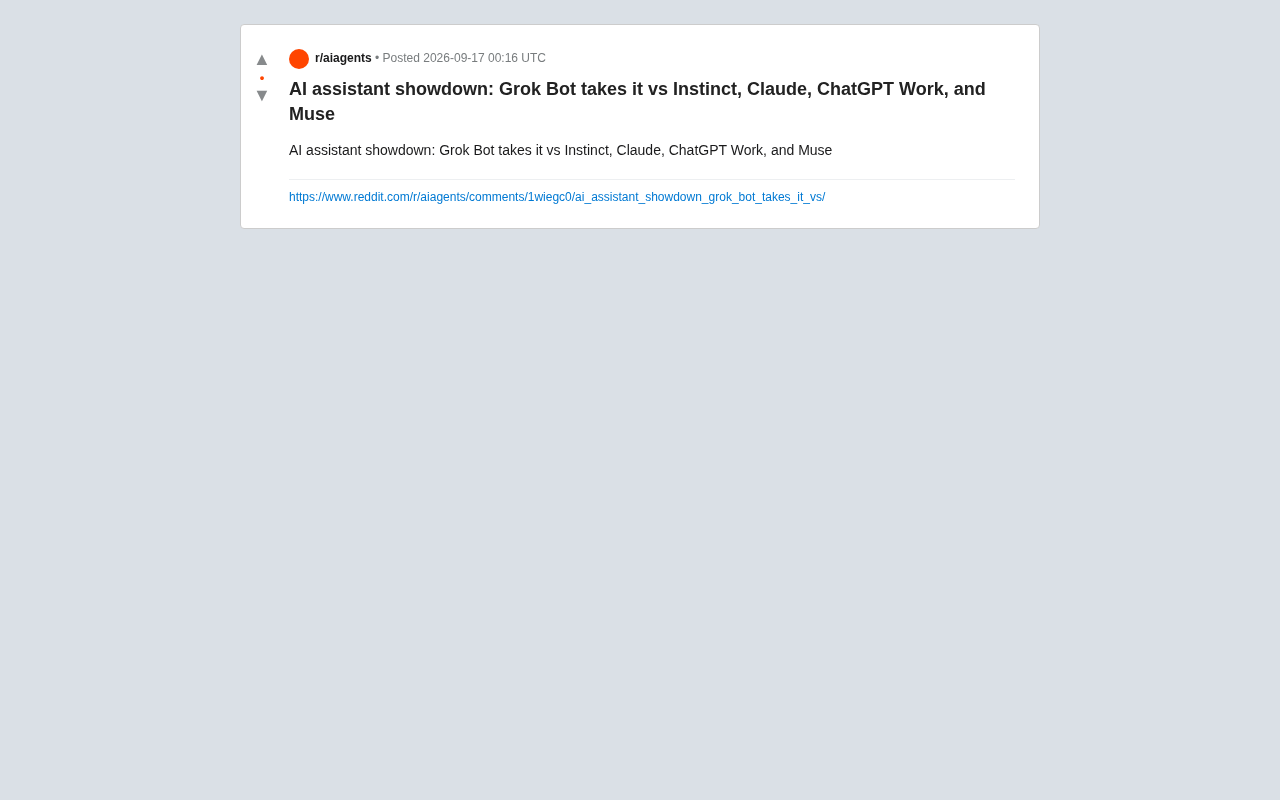
Reddit社区对比中Grok胜出,折射出AI助手赛道多元分化与用户评测标准日趋务实的行业趋势。
一篇Reddit社区帖子引发关注:在Grok、Claude、ChatGPT Work、Instinct与Muse的横向对比中,xAI的Grok被认为表现最佳。文章以此为切入点,梳理了当前AI助手市场的产品分化格局,并分析了用户在真实场景下评判AI助手的核心维度——包括回答准确性与幻觉率、上下文理解能力、实时信息接入能力,以及使用体验与响应速度。文章同时提醒读者,单一社区对比的代表性有限,不同任务类型下各产品表现差异显著,建议用户结合自身需求亲自试用,而非盲从排名结论。整体而言,赛道的激烈竞争最终指向用户受益。
AI助手大乱斗:一场值得关注的横向较量
近期在Reddit社区出现了一场关于AI助手的横向对比讨论,标题直指Grok Bot在与Instinct、Claude、ChatGPT Work以及Muse的较量中胜出。这类对比帖反映出当前AI助手市场竞争的白热化,用户开始用真实场景去检验各家产品的实际能力,而非单纯依赖官方宣传的跑分数据。
需要说明的是,原始素材信息量有限,仅提供了对比结论而未展开具体的测试维度和数据。因此本文更多从行业视角出发,梳理这类AI助手对比背后的意义,以及用户在选择AI助手时应当关注的核心要素。
参与对比的主流AI助手一览
从标题提及的产品来看,这场对比涵盖了目前几款具有代表性的AI助手:
- Grok:由xAI推出的对话助手,以接入实时信息和相对开放的对话风格著称,在这次对比中被认为表现最佳。
- Claude:Anthropic的产品,长期以来在长文本处理、推理能力和安全性方面口碑良好。
- ChatGPT Work:面向工作场景的ChatGPT版本,主打企业协作与生产力提升。
- Instinct 与 Muse:相对小众的助手产品,代表了这一赛道不断涌现的新玩家。
这样的组合本身就说明,AI助手已经从单一的通用聊天机器人,分化出面向不同场景、不同人群的多元产品形态。
值得补充的是,Grok由埃隆·马斯克创办的xAI公司于2023年底推出,早期仅向X(原Twitter)Premium+订阅用户开放。其核心差异化优势在于与X平台的深度整合,可实时抓取社交媒体上的最新信息,从而在时效性上明显优于训练数据有截止日期的竞争对手。Claude则出自专注AI安全的Anthropic公司,其背后有谷歌等巨头的大额投资;Claude系列以极长的上下文窗口(最高可达200K tokens)和较低的幻觉率著称,在专业写作和学术辅助场景中用户黏性较高。ChatGPT Work(即ChatGPT Team/Enterprise版本)是OpenAI面向企业用户的付费订阅服务,提供更高的数据隐私保护、更大的上下文窗口和团队协作功能,定位与消费级免费版有明显区隔。
为什么用户对比结果值得参考
官方基准测试往往在标准化任务上进行,但真实用户的使用场景千差万别。Reddit这类社区的对比帖之所以有价值,在于它更贴近日常实际需求——写作辅助、代码生成、信息检索、逻辑推理等。
一个助手能否"胜出",通常取决于几个关键维度:
回答质量与准确性
用户最看重的仍是答案的可靠程度。是否会产生幻觉、事实是否准确、逻辑是否严密,直接决定了工具的可用性。
"幻觉"(Hallucination)是大语言模型领域的专有术语,指模型以高度自信的语气生成事实上并不存在或错误的信息——例如捏造论文引用、编造历史事件或给出错误的计算结果。这一现象源于语言模型的本质:它们的核心机制是预测下一个最可能出现的词元(token),而非从知识库中检索经过验证的事实。幻觉率的高低是当前各大AI助手最受关注的质量指标之一,也是企业用户在正式采购前必须重点评估的维度。不同任务类型下幻觉率差异显著:开放式创意写作中幻觉危害较低,而医疗、法律、财务等专业场景中一旦出现幻觉则可能产生严重后果。
上下文理解与记忆
在多轮对话中保持连贯、准确理解用户意图,是区分优秀助手和普通助手的重要标准。
上下文窗口(Context Window)决定了AI助手在单次对话中能够"看到"的最大文本量,通常以token数量衡量(1个中文汉字约对应1.5-2个token)。窗口越大,模型在长对话或处理长文档时越不容易"遗忘"早期内容。然而,上下文窗口大小与实际的记忆质量并非完全等同——研究表明,许多模型在处理超长上下文时,对位于中间部分的信息关注度会显著下降,即所谓的"迷失在中间"(Lost in the Middle)问题。此外,当前大多数AI助手并不具备跨对话的持久记忆能力,每次新建对话都从零开始,这与人类对"记住用户"的直觉期待存在明显落差。
实时信息接入
Grok在这方面具有先天优势,能够接入较新的信息,这可能是它在部分对比中占优的原因之一。
使用体验与响应速度
界面友好度、响应延迟、可定制性等因素,同样影响着用户的最终选择。
单一对比结论需谨慎看待
虽然这条帖子给出了Grok胜出的结论,但作为单一来源的社区观点,其代表性有限。不同用户的测试任务、评判标准乃至个人偏好都会显著影响结果。同一款助手在写作任务上可能表现出色,在代码或数学推理上却未必领先。
因此,与其盲信某一次对比的排名,不如根据自身的核心需求,亲自试用几款产品做出判断。多数AI助手都提供免费版本或试用额度,实际体验是最可靠的参考依据。
结语:竞争推动进步
无论这次对比谁胜谁负,AI助手赛道的激烈竞争最终受益的是用户。各家产品在你追我赶中快速迭代,能力边界不断被推高。对普通用户而言,保持关注、按需选择、动手试用,才是应对这一快速变化领域的务实策略。
相关推荐
Vercel AI SDK 阿里巴巴适配器更新:多轮对话默认保留推理链
Vercel AI SDK 阿里巴巴适配器 @ai-sdk/alibaba 发布 0.0.28 版本,新增在支持的模型上多轮请求默认保留推理链(reasoning)的功能,提升通义系列模型多轮对话的连贯性。
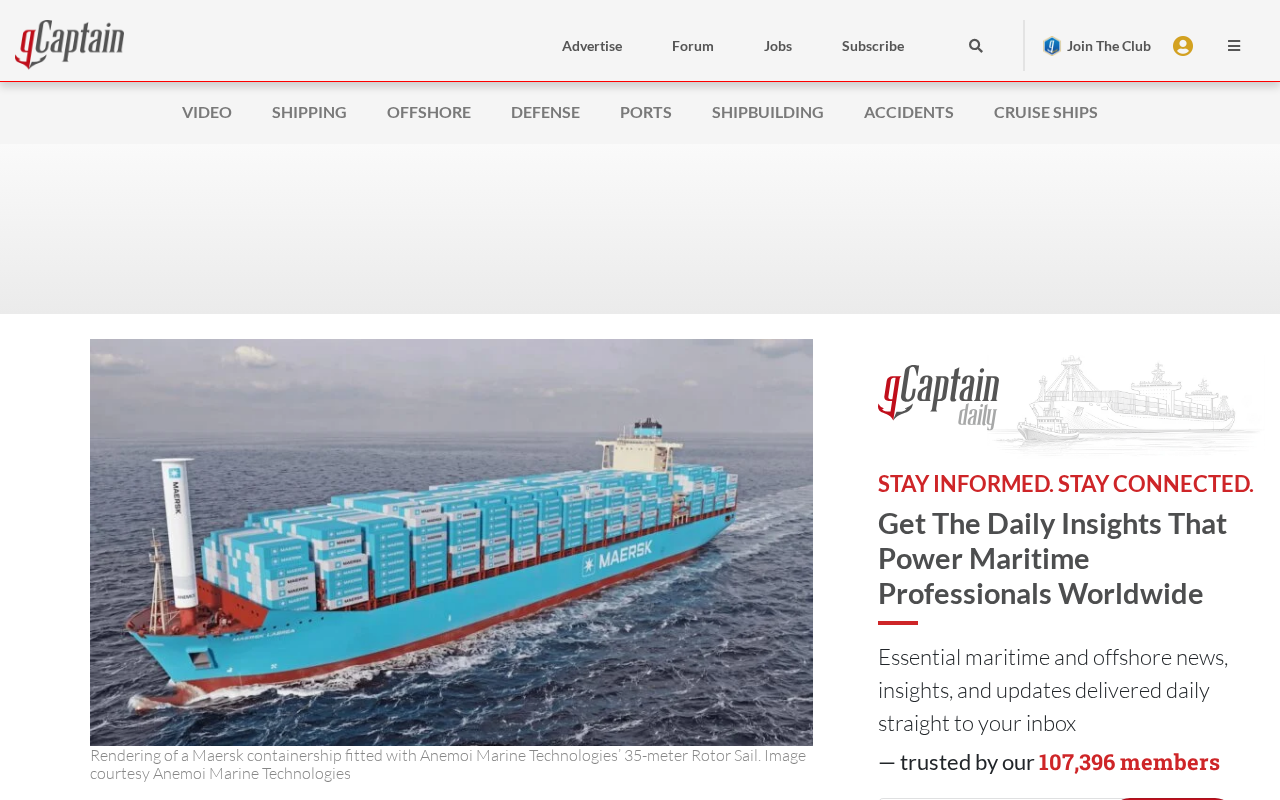
风帆动力回归:货轮如何重新拥抱风能减排
货轮为何重新拥抱风能?本文解析转筒帆、硬翼帆等现代风力辅助技术,以及航运业在减排压力与燃油成本下回归风帆动力的经济逻辑与现实挑战。
比AI智能体接管互联网更可怕的:CEO卡特尔垄断AI
一篇Hacker News观点引发思考:相比AI智能体接管互联网的科幻恐慌,少数科技巨头垄断AI产业的权力集中风险或许更值得警惕。本文分析AI垄断、开源制衡与治理透明的核心议题。