AI自动化陷阱:扣除监督与修复成本后,什么任务仍值得自动化?

自动化价值取决于扣除监督修复等隐性成本后的净收益。
文章从Reddit小企业主的困惑出发,指出自动化热潮中人们常只计算节省的时间,却忽略监督、修复集成、维护和机会成本等隐性成本,导致“AI员工”叙事在演示与真实运营间存在鸿沟。基于社区讨论,文章评估了候选任务:研究类信息收集、模板化报告生成和工单初筛在计入监督成本后较可能保持正向收益;而多步骤跨系统操作、高合规要求任务和高度非结构化输入场景往往试过后退回脚本或人工。文章还提供选择第一个运营工作流的五步框架:画出流程、定义自主边界、设定干预频率、小规模试运行、设定退出标准。结论强调自动化边界是经济学问题而非技术问题,应从验证成本低、错误后果轻的任务入手,用真实数据检验净收益。
引言:自动化热潮背后的冷静拷问
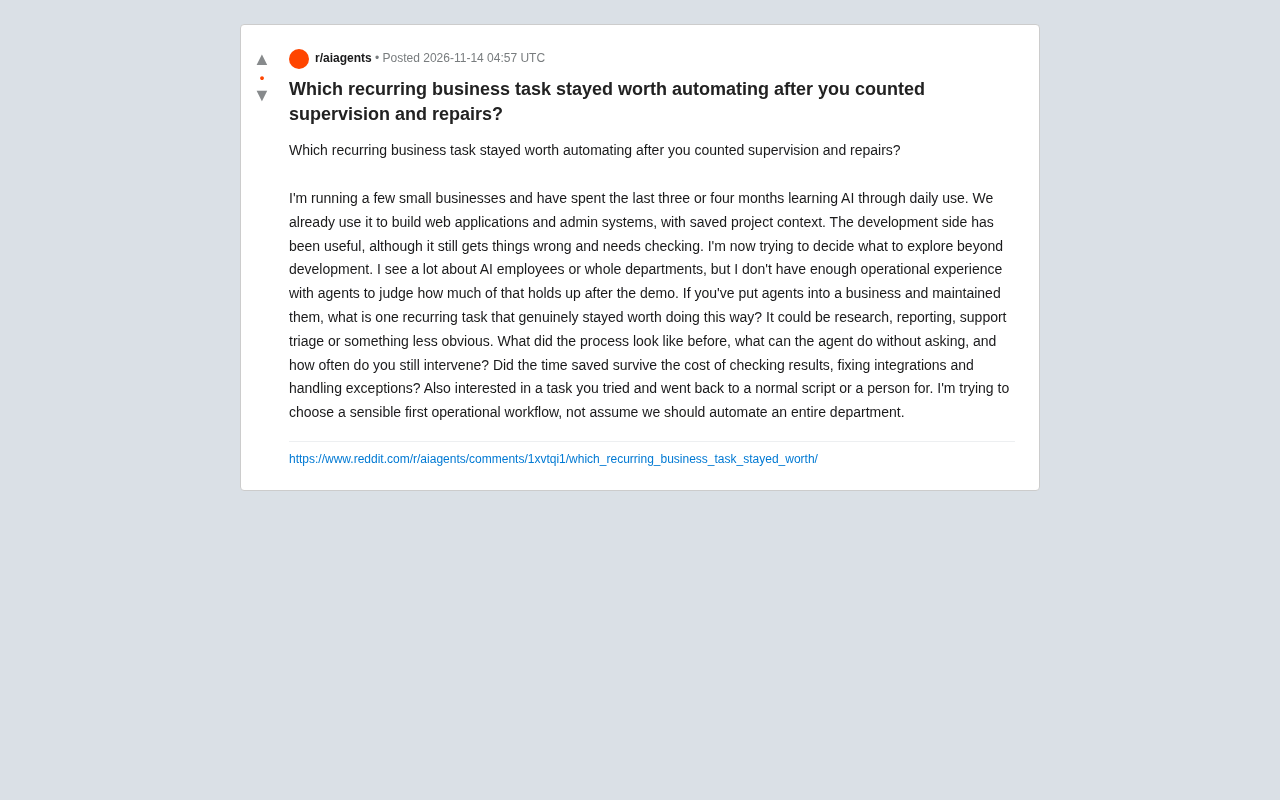
Reddit上一位小企业主分享了自己的困惑:用AI开发网页应用和后台系统几个月后,开发效率确实提升了,但AI仍会出错、需要人工检查。当他考虑将AI扩展到运营环节时,发现市面上充斥着“AI员工”“AI部门”的宣传,却缺乏真实运营经验来判断这些方案在演示之后是否还站得住脚。他提出了一个关键问题:在扣除监督、修复集成和处理异常的成本后,哪些重复性业务任务真正值得自动化?
这个问题切中了当前AI应用的核心矛盾——我们往往只计算自动化节省的时间,却忽略了维持自动化系统运转所需的隐性成本。
自动化经济学的真相:时间节省不等于净收益
隐性成本清单
在评估任何自动化方案时,以下成本必须纳入计算:
- 监督成本:AI输出的检查与校验时间
- 修复成本:集成故障排查、异常处理
- 维护成本:提示词调整、模型更新适配
- 机会成本:为自动化而标准化流程所牺牲的灵活性
那位企业主的原话值得深思:“节省的时间是否经得起检查结果、修复集成和处理异常的成本?”这提醒我们,自动化的价值不在于“能做什么”,而在于“净收益是否为正”。
净收益(Net Benefit) 在自动化语境下指自动化带来的总收益减去总成本后的余额。总收益不仅包括节省的直接人工时间,还可能包括减少的错误率、更快的响应速度等;总成本则涵盖文中列出的监督、修复、维护和机会成本。许多自动化项目失败并非因为技术不可行,而是因为只计算了显性收益(时间节省)而忽略了隐性成本。一个实用的估算方法是:在试运行阶段记录每项任务的人工介入时间、故障排查次数和流程僵化带来的额外沟通成本,将这些折算为时间或金钱,与节省的时间对比。只有当净收益持续为正且稳定时,自动化才值得扩展。
为什么“AI员工”叙事容易误导
演示环境中的AI代理通常运行在理想条件下:干净的输入、明确的边界、无需例外处理。但真实业务充满了边缘情况、系统对接摩擦和模糊判断。没有实际运营经验的人很难分辨演示与现实之间的鸿沟。正如这位企业主所说,他“没有足够的代理运营经验来判断这些在演示之后有多少能站得住脚”。
AI代理(AI Agent) 与传统的自动化脚本有本质区别。脚本执行预设的固定指令序列,行为完全确定;而AI代理基于大语言模型,能够理解自然语言指令、进行一定程度的推理和决策,并调用工具(如搜索、API、数据库)来完成多步骤任务。这种灵活性使其能处理非结构化输入和模糊场景,但也带来了不确定性:同样的输入可能产生不同的输出,错误模式难以穷举预测。代理的“自主性”通常通过提示词、工具权限和护栏(guardrails)来约束,但约束越松,监督成本越高。理解这一区别是评估自动化净收益的前提——代理的灵活性是有代价的,代价就体现在监督、异常处理和输出验证上。
候选任务评估:什么类型的工作更可能通过净收益测试
基于社区讨论和实际案例,以下任务类型在计入监督成本后仍较有可能保持正向收益:
研究类任务:结构化信息收集
典型场景:竞品价格监控、行业新闻摘要、供应商背景调查。
为什么可能成立:这类任务的输出易于验证——价格可以核对,新闻可以溯源。错误通常表现为遗漏而非捏造,修复成本相对可控。代理可以在预设范围内自主运行,仅在发现异常时触发人工介入。
风险点:信息源变化可能导致代理失效,需要定期检查数据管道。
报告生成:模板化数据汇总
典型场景:周报数据填充、销售仪表盘摘要、财务数据初步整理。
为什么可能成立:输入输出结构固定,验证成本低。人工只需核对数字准确性,而非重新生成整份报告。
关键前提:数据源必须稳定,且格式变化频率低。
支持工单初筛:分类与路由
典型场景:客户咨询分类、优先级标注、常见问题自动回复。
为什么可能成立:分类错误的影响有限(可人工纠正),且随着反馈积累,准确率可以逐步提升。代理不需要完全自主——它可以只做初筛,将复杂案例转交人工。
注意事项:需要明确的升级规则和异常标记机制。
反面案例:哪些任务试过之后又退回了脚本或人工
原帖作者特别询问了“尝试后改回普通脚本或人工的任务”,这是极具价值的反向视角。根据社区中反复出现的模式:
多步骤跨系统操作
涉及多个系统状态变更的任务(如订单处理、账户开通)往往在异常处理上耗费大量精力。一个步骤失败可能导致状态不一致,排查成本远超自动化节省的时间。退回脚本是常见选择——脚本行为确定,失败点明确。
高合规或高准确性要求的任务
财务对账、合同条款审核等任务,错误代价过高,人工复核几乎无法省略。自动化在这里变成了“辅助”而非“替代”,净收益有限。
输入高度非结构化的场景
当输入格式变化频繁(如不同供应商的发票格式、各种渠道的客户反馈),代理需要频繁调整,维护成本居高不下。退回人工或半自动化流程更为经济。
非结构化输入指格式不固定、缺乏预定义模式的数据,如自由文本邮件、手写笔记、不同版式的发票、扫描件或聊天记录。与之相对,结构化数据(如数据库表格、固定格式的CSV)易于程序解析。AI代理相比传统脚本的优势之一就是能处理一定程度的非结构化输入,但这种能力并非无限:当输入格式变化频繁或差异过大时,代理的解析准确率会下降,需要不断调整提示词或增加预处理步骤,维护成本随之上升。因此,评估自动化可行性时,应统计输入格式的变异程度和频率——变异越大,越可能需要人工兜底或退回半自动化流程。
选择第一个运营工作流的实用框架
那位企业主的最终目标是“选择一个合理的第一个运营工作流,而不是假设我们应该自动化整个部门”。以下是可操作的决策框架:
第一步:画出当前流程
记录任务从触发到完成的每个步骤,标注:谁在做、耗时多少、出错频率、错误后果。这能暴露真正的瓶颈和风险点。
第二步:定义代理的自主边界
明确代理可以“不询问就做”的范围。范围越窄,监督成本越低。例如:代理可以自动分类工单,但涉及退款决策时必须转人工。
第三步:设定干预频率预期
坦诚评估你愿意且能够承受的介入频率。如果每天需要多次干预,自动化的净收益可能为负。
第四步:小规模试运行
先在一个子集上运行数周,记录实际监督时间、修复次数和异常类型。用真实数据替代直觉判断。
第五步:设定退出标准
提前明确什么情况下放弃自动化退回脚本或人工。这能避免沉没成本陷阱。
结语:自动化的边界是经济学问题,不是技术问题
AI代理能做什么,与它是否值得做,是两个完全不同的问题。那位Reddit企业主的提问方式本身就值得借鉴——他不问“AI能自动化什么”,而问“扣除监督和修复成本后,什么仍值得自动化”。这种净收益视角,比任何技术演示都更接近业务现实。
对于正在评估第一个运营工作流的企业,建议从验证成本低、错误后果轻、输入结构稳定的任务入手,用真实数据检验时间节省是否经得起隐性成本的侵蚀。自动化不是目标,可持续的净收益才是。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。