AI自动提取PDF发票数据到Excel并邮件发送全流程解析
AI工具可批量并行处理PDF发票,自动提取结构化数据汇入Excel并邮件交付,大幅替代手动录入。
这篇文章介绍了一个基于AI的PDF发票批量处理演示:用户只需拖拽上传多份格式不统一的发票并用自然语言下达指令,工具即可在后台并行抽取各项字段,将结构化数据汇总为Excel并自动发送至邮箱,全程无需人工守候。文章将此归类为"文档智能抽取(Document AI)"方向,强调其相比传统固定模板OCR的核心优势在于能容忍版式差异、支持异步批量处理,并实现端到端闭环交付。作者同时指出实际落地前需关注抽取准确率、人工复核机制以及敏感财务数据的安全合规问题,认为这一演示代表了发票录入类标准化任务被AI快速自动化的整体趋势。
发票数据录入的老问题
很多财务和运营岗位的日常工作里,依然存在一项极其耗时的任务:把一张张PDF发票里的金额、日期、供应商、税额等字段,逐行复制粘贴到Excel表格中。当发票数量达到几十上百份时,这项机械劳动不仅效率低下,还容易出错。
这段来自YouTube的演示展示了一种更现代的解决思路:借助AI工具批量处理PDF发票,自动把结构化数据汇总到Excel,并把结果直接发送到邮箱。整个流程几乎不需要人工干预,演示者的原话是——"Stop manual entry."(停止手动录入)。
演示流程拆解
从演示来看,操作路径被压缩到了极简:
第一步:发出指令
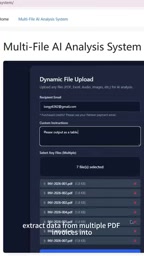
演示者直接向自己的定制工具下达自然语言指令——"从多份PDF发票中提取数据到Excel,并把附件发到邮箱"。这意味着工具支持以对话式的方式触发任务,而不是让用户在复杂的菜单里逐项配置。
第二步:拖拽上传
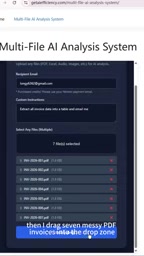
接着,演示者把7份"杂乱"(messy)的PDF发票一次性拖进上传区(drop zone)。所谓"杂乱",暗示这些发票格式并不统一——不同供应商、不同排版,正是实际业务中最常见的场景。
第三步:提交后离开
点击提交后,演示者直接关掉了标签页。这里透露出一个关键设计:任务在后台异步执行,用户无需守在屏幕前等待。
幕后的并行处理
真正值得关注的是"behind the scenes"的那部分。按演示说法,AI会并行处理每一个文件(processes every file in parallel),而不是逐个排队。对于批量任务来说,并行处理直接决定了整体耗时——7份发票如果串行可能需要等待数分钟,并行则能大幅压缩到接近单份处理的时间。
处理完成后,系统会把一份结构化报告(structured report)直接投递到用户邮箱,可以直接查看和下载。
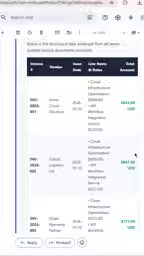
这种"提交即走、结果进邮箱"的交互模式,本质上把一次性的人工操作转化成了一条自动化流水线:输入(PDF)→ 处理(AI抽取+结构化)→ 输出(Excel+邮件)。
这里的并行处理在工程实现上通常依赖云函数或任务队列架构。每份PDF上传后会被拆分为独立的处理任务,分发到多个计算节点同时运行,而不是在单台服务器上逐个排队。常见实现方式包括AWS Lambda、Azure Functions等无服务器计算,或者Celery、BullMQ这类消息队列系统。用户关掉标签页后任务仍能继续执行,正是因为处理逻辑已从前端浏览器完全转移到后端服务。最终结果以邮件形式推送,也避免了用户必须保持页面打开以轮询状态的体验问题。对企业用户而言,这种架构意味着处理100份发票与处理7份在等待时间上差异有限,系统扩展性相对线性。
这类工具的价值与适用场景
从财务自动化的角度看,这个演示代表了一类正在成熟的应用方向——文档智能抽取(Document AI)。它的核心价值体现在几个方面:
- 消除重复劳动:把复制粘贴这类零增值工作交给机器。
- 容忍格式差异:面对不同供应商的杂乱发票仍能抽取关键字段,这是传统基于固定模板的OCR方案很难做到的。
- 异步与并行:批量任务不占用人工等待时间,适合处理高频、大批量的发票流。
- 闭环交付:结果直接以Excel和邮件形式交付,无缝接入现有工作流。
适用场景包括应付账款(AP)团队的发票录入、报销审核、供应商对账,以及任何需要把非结构化文档转成结构化表格的岗位。
文档智能抽取(Document AI) 是近年来随着大语言模型和多模态视觉模型成熟而快速发展的一个技术方向。与传统OCR(光学字符识别)不同,传统OCR本质上只是把图像中的文字转成可编辑文本,依赖预设模板来定位字段位置,一旦发票版式变化就容易失效。Document AI则结合了版面分析(Layout Analysis)和语义理解,能够"读懂"文档结构——即便不同供应商的发票排版各异,模型也能根据上下文语义判断哪个数字是税额、哪个字符串是供应商名称。代表性的底层技术包括微软的LayoutLM系列模型、Google Document AI平台,以及集成进GPT-4o等多模态大模型的视觉理解能力。演示中工具能处理"杂乱"发票,正是依赖这种语义感知能力,而非固定坐标模板。
需要留意的现实问题
演示本身是营销性质的产品展示,有几个问题在实际落地前需要验证:
抽取准确率是关键。发票字段一旦识别错误(比如金额、税号),对财务数据的影响是直接且敏感的,因此是否有人工复核环节、置信度提示很重要。此外,涉及发票这类敏感财务文件,数据上传到哪里、是否加密、是否符合合规要求,也是企业采用前必须确认的。演示中并未展示错误处理和数据安全的细节。
尽管如此,这段演示清晰传达了一个趋势:发票数据录入这类标准化的文档处理任务,正在被AI工具快速自动化。对于仍在手动录入的团队来说,评估并引入这类工具,可能是提升效率的直接切入口。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。