Aleph Alpha开源Kolibri-1:78B参数仅激活3.46B,支持百万Token上下文

欧洲AI公司Aleph Alpha开源78B参数MoE模型Kolibri-1,推理仅激活3.46B参数,支持百万Token上下文,采用Apache 2.0许可。
德国AI公司Aleph Alpha在Hugging Face上以Apache 2.0许可证开源了Kolibri-1,这是一款采用混合专家(MoE)架构的大语言模型。其总参数量达78B,但每次推理仅激活约3.46B参数,激活比例不足5%,在大幅压缩实际计算开销的同时保留了大容量模型的知识储备。模型还宣称支持最高100万Token的超长上下文窗口,适用于长文档分析、大型代码库理解和RAG等场景。宽松的Apache 2.0许可使其可自由用于商业场景,无月活用户数等附加限制。Kolibri-1的发布体现了欧洲AI自主性的战略方向,也为全球开发者提供了独立于美国主流厂商的高效长上下文开源模型选项,但其在超长上下文中的实际推理质量仍有待社区验证。
欧洲AI公司Aleph Alpha在Hugging Face上发布了新模型Kolibri-1,以Apache 2.0许可证开源。这款模型采用混合专家(MoE)架构,总参数量达到78B,但推理时仅激活3.46B参数,同时支持最高100万Token的上下文长度。对于关注高效大模型和长上下文能力的开发者来说,这是一个值得关注的开源选项。
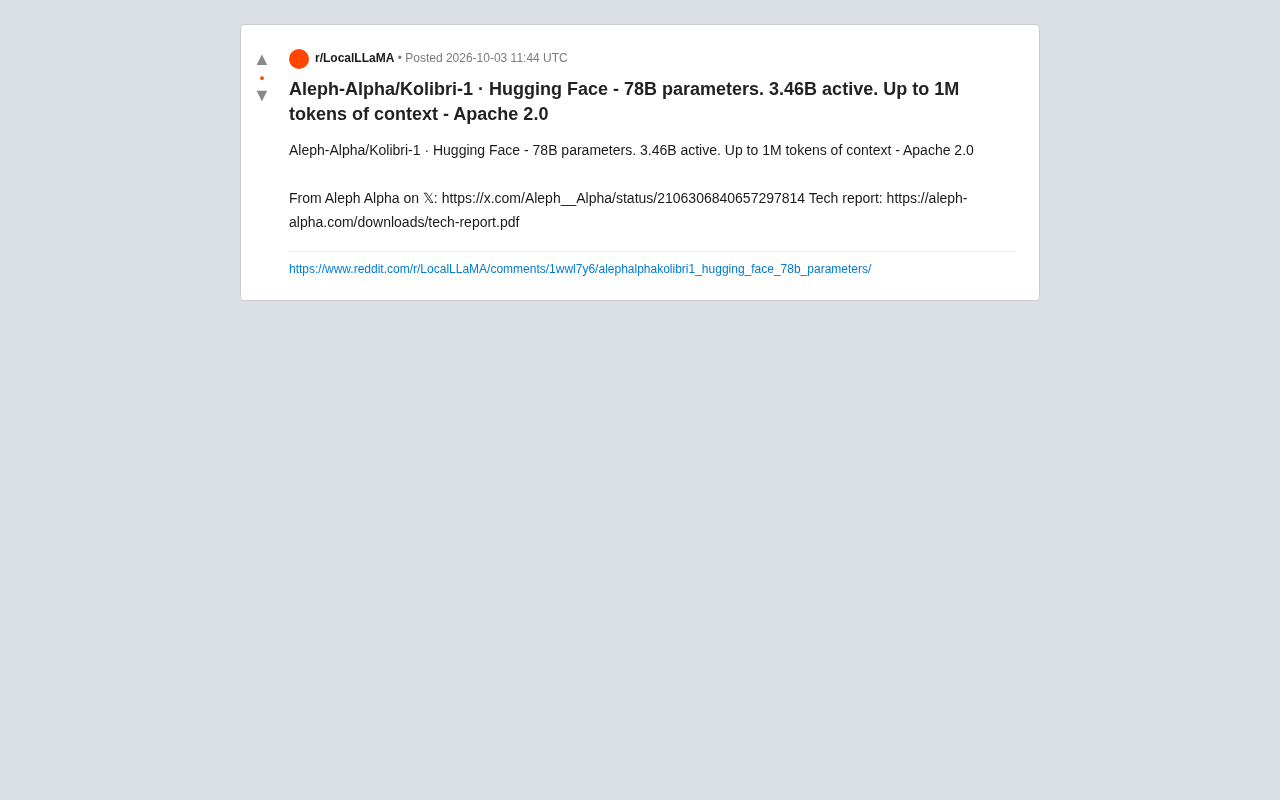
稀疏激活:78B总量,仅跑3.46B
Kolibri-1最引人注目的设计是其极高的参数稀疏度。模型总参数为78B,但每次前向推理只激活约3.46B参数,激活比例不足5%。这种混合专家架构的核心思路是:模型内部包含大量"专家"子网络,但针对每个输入token只路由激活其中一小部分。
这种设计带来的直接好处是推理成本大幅下降。相比传统的稠密(dense)模型,同等效果下MoE模型在实际运行时的计算开销可以显著降低。对于算力预算有限的团队或希望在本地部署的场景,这种"大容量、低激活"的组合提供了更好的性价比权衡。
不过需要注意的是,78B的总参数仍然意味着加载模型需要相当可观的显存或内存资源——稀疏激活降低的是计算量,而非存储占用。
混合专家(Mixture of Experts,MoE)架构并非新概念,其思想可追溯至1990年代,但直到近几年才在大语言模型领域大规模落地。典型的MoE层由若干"专家"前馈网络和一个"路由器"(Router)组成,路由器对每个输入token计算权重,只将其分配给得分最高的Top-K个专家处理。以Kolibri-1为例,78B参数分布在众多专家网络中,但每次推理只有对应3.46B参数量的专家被唤醒计算,其余专家权重虽然常驻显存,却不参与当前token的矩阵运算。这种机制使得模型在保留大容量知识储备的同时,将每次前向传播的浮点运算量(FLOPs)压缩到接近同等激活参数量稠密模型的水平。Mixtral 8×7B、DeepSeek广告-V2等近年热门开源模型均采用类似思路,印证了MoE在效率与容量平衡上的实用价值。
百万Token上下文窗口
Kolibri-1宣称支持最高100万Token的上下文长度。超长上下文一直是大模型竞争的焦点之一,它直接决定了模型能处理多长的文档、代码库或对话历史。
百万级Token的窗口意味着模型可以一次性读入整本书籍、大型代码仓库或海量检索文档,这对RAG(检索增强生成)、长文档分析、代码理解等应用场景尤为关键。当然,长上下文的实际效果还需要结合具体任务来验证——窗口大小是上限,而模型在超长上下文中的信息检索与推理质量才是真正的考验。
超长上下文能力的实现在工程上面临两大核心挑战。其一是位置编码的外推能力:传统的绝对位置编码难以泛化到训练长度之外,因此当前主流方案普遍采用RoPE(旋转位置编码)并配合YaRN、LongRoPE等外推技术,将位置编码的有效范围扩展到百万级别。其二是注意力机制的计算复杂度:标准自注意力的计算量随序列长度呈平方增长,处理100万Token的全量注意力在工程上不现实,实际实现往往依赖滑动窗口注意力、稀疏注意力或分块(Chunked)注意力等变体来控制开销。此外,"支持100万Token上下文"与"在100万Token上下文中表现良好"之间存在显著差距——业界常用的"大海捞针"(Needle-in-a-Haystack)测试可以衡量模型在超长上下文中定位关键信息的实际能力,这是评估此类模型时不可跳过的重要指标。
Apache 2.0许可:商用友好
Kolibri-1以Apache 2.0许可证发布,这是对开发者和企业最友好的开源协议之一。相比一些带有使用限制的"开放权重"模型,Apache 2.0允许自由的商业使用、修改和再分发,没有月活用户数限制或额外授权要求。
这一点对于欧洲AI生态具有特别意义。Aleph Alpha作为德国的AI公司,长期强调数据主权和欧洲本土AI能力。以宽松许可开源一款兼具效率与长上下文能力的模型,有助于降低企业采用门槛,也为欧洲乃至全球开发者提供了独立于美国主流厂商的替代选择。
技术定位与看点
Kolibri-1的参数配置反映了当前大模型发展的一个重要趋势:在追求模型容量的同时,通过稀疏激活控制实际推理成本。这与近年来多家厂商在MoE架构上的探索方向一致。
根据发布信息,Aleph Alpha同时提供了技术报告,详细说明了模型的训练与架构细节。对于希望深入评估的开发者,建议结合技术报告和Hugging Face上的模型卡片,重点关注以下几个方面:
- 实际推理资源需求:78B总参数对部署硬件的要求
- 长上下文真实表现:在百万Token窗口下的检索与推理质量
- 多语言与欧洲语言支持:作为欧洲公司产品的潜在优势
- 基准测试成绩:与同规模开源模型的横向对比
小结
Kolibri-1将高总参数量、低激活比例、超长上下文和商用友好许可集于一身,是开源大模型领域一个有特色的新成员。它既延续了Aleph Alpha对欧洲AI自主性的重视,也顺应了MoE高效推理的技术潮流。对于寻找可商用、长上下文开源模型的团队而言,这款模型值得纳入评估清单。实际效果如何,还需要社区在真实任务中的进一步验证。
信息来源:Aleph Alpha官方Hugging Face页面及技术报告(经Reddit社区讨论传播)。本文基于公开发布信息整理,具体性能指标以官方技术报告为准。
相关推荐

气态巨行星上的浮空城市:为什么人类终将移居木星云端
SFIA 主持人 Isaac Arthur 重新定义气态巨行星浮空城市:它们不是等待聚变的燃料站,而是散装氢、氦、氮的"质量城市"。本文解析其工程原理、供电方案与从工业前哨到文明家园的演化逻辑。

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。