AlignedHPO:让损失函数超参自动调优,速度提升12倍

AlignedHPO 用梯度对齐与 JVP 高效调优损失函数超参,提速近 12 倍。
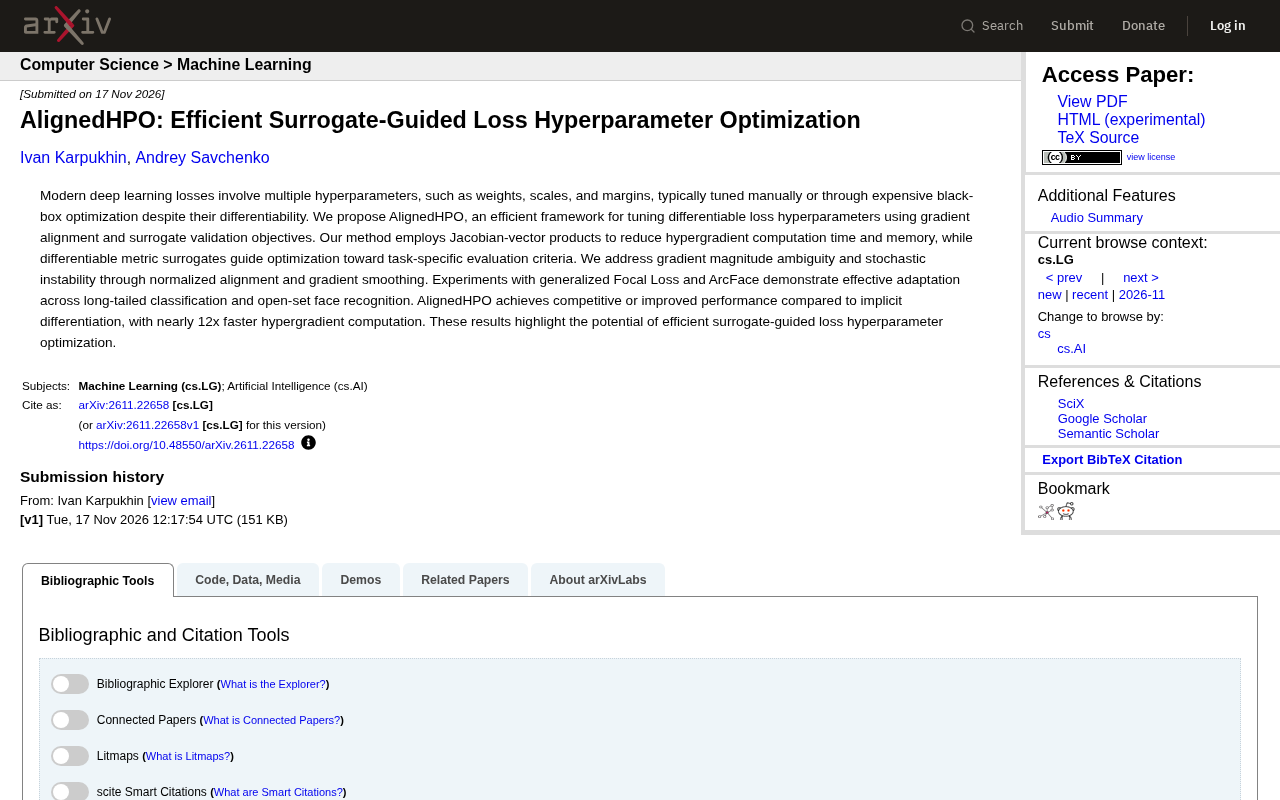
AlignedHPO 是一个用于自动调优损失函数超参数的轻量框架。文章指出,权重、尺度、margin 等超参数虽可微,但实践中仍依赖手动调参或昂贵的黑盒优化,而隐式微分虽提供理论路径却计算与内存开销大、对随机性敏感。AlignedHPO 通过三项设计应对这些痛点:用 Jacobian-vector 乘积估计超梯度以避免显式矩阵构造与求逆,带来近 12 倍加速;对梯度归一化后再对齐,消除不同超参数敏感度差异造成的幅度歧义;引入梯度平滑以抑制小批量噪声导致的估计抖动。方法还使用可微指标代理替代不可微的评估指标,使超参数直接朝任务评价标准调整。在广义 Focal Loss 长尾分类和 ArcFace 开集人脸识别任务上,其性能与隐式微分相当或更优。
深度学习的损失函数往往包含多个超参数——权重、尺度、margin 等。这些参数虽然可微,但实践中仍主要靠手动调参或昂贵的黑盒优化。一篇新论文提出的 AlignedHPO 框架,尝试用梯度对齐和代理验证目标来高效解决这个问题,在长尾分类和开集人脸识别任务上取得了与隐式微分相当甚至更好的效果,同时把超梯度计算速度提升了近 12 倍。
为什么损失函数超参难调
现代损失函数的设计越来越精细。以广义 Focal Loss 和 ArcFace 为例,前者需要调节不同类别的权重和聚焦参数来应对长尾分布,后者则依赖尺度因子和角度 margin 来增强人脸特征的判别性。这些参数直接影响优化景观和最终表征质量,但它们的最优值往往随数据集、模型架构和训练阶段变化。
手动调参依赖经验且难以复现;黑盒优化(如贝叶斯优化)需要反复完整训练,计算成本极高。一个自然的想法是:既然损失函数对超参数可微,能否直接计算超梯度来更新它们?隐式微分提供了理论路径,但计算和内存开销大,且对随机性敏感。AlignedHPO 正是针对这些痛点提出的轻量方案。
超梯度(hypergradient) 指的是验证集损失(或代理指标)对超参数的导数。与普通梯度不同,超参数通过影响模型训练过程(即内层优化)间接影响最终模型参数,因此超梯度需要沿整个训练轨迹反向传播。精确计算超梯度有两条路径:一是展开整个训练过程做反向传播(unrolled differentiation),内存随训练步数线性增长;二是隐式微分(implicit differentiation),利用训练收敛时的最优性条件求导,内存开销小但需要求解线性系统或近似逆矩阵。两者的共同难点是训练过程本身包含随机性(小批量采样、数据增强),导致超梯度估计有偏且方差大。
AlignedHPO 的三个关键技术
论文的核心思路是用梯度对齐来估计超梯度方向,并用可微的指标代理引导优化。具体包含三个设计:
Jacobian-vector 乘积降低开销。 通过 JVP 计算超梯度,避免显式构造和求逆大型矩阵,显著减少计算时间和内存占用。这是实现“近 12 倍加速”的主要来源。
归一化对齐解决梯度幅度歧义。 不同超参数对损失的敏感度差异很大,原始梯度幅度可能误导更新方向。AlignedHPO 对梯度进行归一化后再做对齐,使优化更稳定。
梯度平滑应对随机不稳定性。 小批量训练带来噪声,超梯度估计容易抖动。论文引入梯度平滑机制,让更新方向在随机环境下更可靠。
此外,方法使用可微的指标代理(differentiable metric surrogates)来替代不可微的评估指标(如 F1、准确率),把优化目标直接拉向任务真正关心的评价标准,而不是仅最小化训练损失。
Jacobian-vector 乘积(JVP) 是自动微分中的一种前向模式运算:给定函数 $f$ 和向量 $v$,直接计算 $J_f \cdot v$,而无需显式构造雅可比矩阵 $J_f$。在许多超梯度估计中,真正需要的只是雅可比矩阵与某个向量的乘积,而非矩阵本身。使用 JVP 可以把时间和内存从与参数维度平方相关的开销降到线性量级,并且可以与反向模式自动微分组合使用(即前向-反向混合模式)。这正是 AlignedHPO 能够绕开显式矩阵构造与求逆、实现大幅加速的底层机制;理解这一点,也就理解了“近 12 倍加速”并非工程技巧,而是自动微分模式选择带来的算法级收益。
实验结果:两类任务验证有效性
论文在两类差异明显的任务上做了验证。长尾分类使用广义 Focal Loss,开集人脸识别使用 ArcFace。这两个场景的共同点是:损失函数超参数对性能影响大,且数据分布复杂。
结果显示,AlignedHPO 在性能上与隐式微分方法相当或更优,但超梯度计算速度提升近 12 倍。这意味着在相同计算预算下,可以更频繁地更新超参数,或把节省的算力用于更大规模的实验。论文还强调,该方法能自适应地调整超参数,而非依赖固定启发式。
可微指标代理 是为解决“任务指标不可微”而设计的替代函数。F1、准确率、AUC 等评价指标通常涉及 argmax、阈值比较或离散计数,梯度几乎处处为零,无法直接用于基于梯度的超参数优化。常见做法是构造一个光滑的替代量,例如用 soft-F1(以概率代替硬预测)、可微的排序近似或温度缩放的 softmax 来逼近原指标。代理指标设计的关键在于与原指标保持足够高的相关性,否则优化方向会偏离真实目标。这也解释了原文提到的局限:代理指标需要针对具体任务定制,其质量直接影响 AlignedHPO 的实际效果。
对实践者的意义
这项工作的价值在于把“损失函数超参自动调优”从理论可行性推向工程可用性。JVP 和梯度平滑都是成熟工具,组合后的效率提升显著。对于需要精细调节损失函数的场景——长尾学习、人脸识别、度量学习——AlignedHPO 提供了一条比黑盒搜索更省算力、比隐式微分更轻量的路径。
不过,论文目前只在两个任务上验证,代理指标的设计也需要针对具体任务定制。能否推广到更广泛的损失函数和训练流程,仍需进一步观察。但“用梯度对齐替代昂贵超梯度计算”这个思路,值得关注。
相关推荐
FBI警告:黑客用AI代理ARTEX攻击200+组织
FBI发布预警,点名AI渗透框架ARTEX被用于攻击200多家组织,CrowdStrike追踪到VaporPanda团体。本文拆解ARTEX的代理编排架构、真实攻击链与损失数据,并整理FBI给出的五条防御建议。
FBI警告:免费AI黑客工具Artex失控,三小时攻破云系统
FBI警告免费开源AI渗透工具Artex被犯罪与国家背景黑客滥用,最快三小时攻破云系统。本文解析真实攻击案例、被忽视的侧门风险,以及企业与个人可立即采取的防御措施。

Verse Engine:一键将Blender/Unity/Unreal场景变成浏览器3D链接
Verse Engine by Ctruh是一款浏览器原生3D与XR引擎,支持从Blender、Unity、Unreal一键发布3D场景为浏览器链接,无需下载安装。按视野流式传输让10.3亿三角面城市场景在笔记本打开,提供嵌入、API与SDK,适合开发者、3D艺术家、建筑与电商团队。