AlphaGenome 2发布:DNA变异预测迎来细胞类型级精度
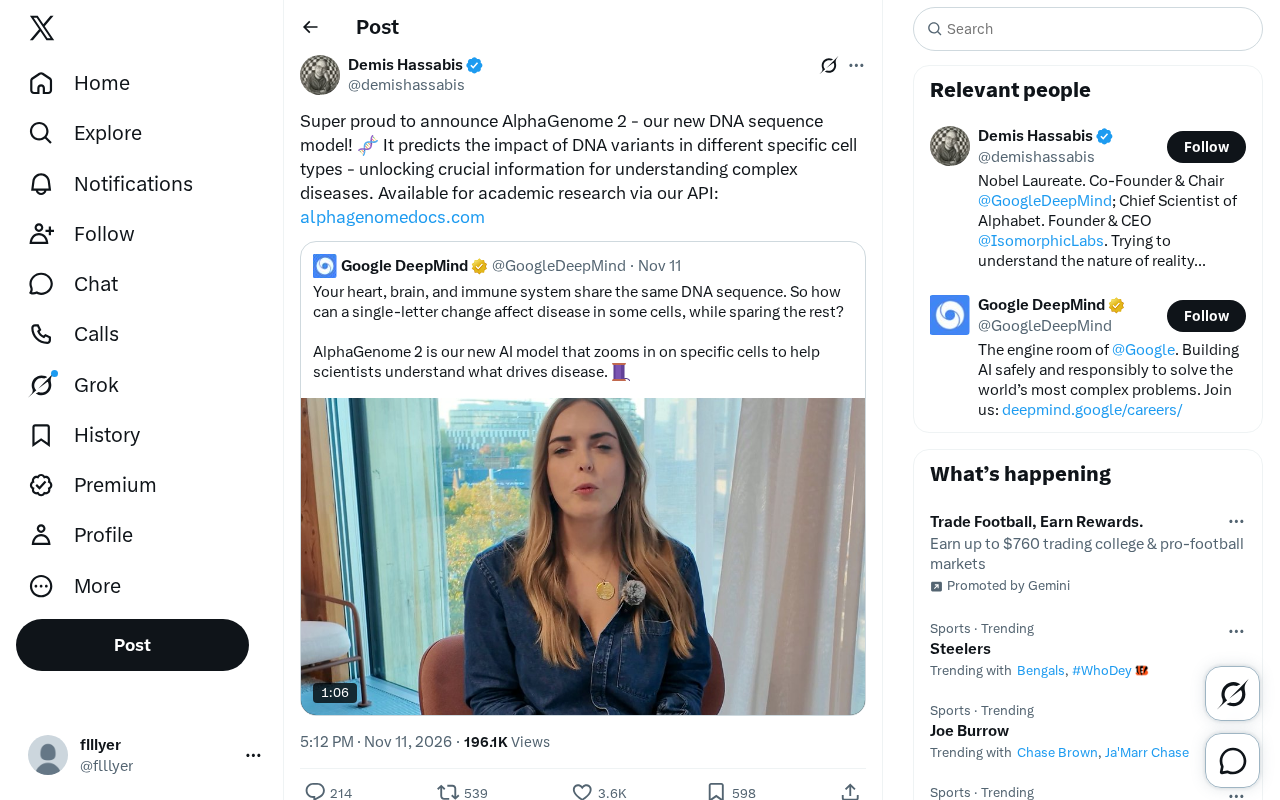
AlphaGenome 2以细胞类型为维度预测DNA变异影响,直指复杂疾病非编码变异解读难题。
AlphaGenome 2 是一款新的DNA序列模型,其核心设定是按特定细胞类型预测DNA变异的功能影响,而非给出笼统的平均化变异打分。文章指出,复杂疾病的遗传基础多由非编码区的微弱效应变异构成,这些变异通过调控基因表达发挥作用,而调控逻辑高度依赖细胞环境,因此细胞类型特异的预测对GWAS候选位点的机制解读和药物靶点发现更具操作价值。模型目前以API形式向学术研究开放,降低了算力与复现门槛。但公告未披露模型架构、训练数据规模、基准测试表现及API调用细节,也未说明产业界能否使用,作者因此建议在独立评测与同行评议之前对其能力保持审慎判断。
从序列到疾病:AlphaGenome 2 想要解决什么问题
基因组学的一个核心难题是:同一段DNA变异,为什么在不同细胞里产生完全不同的后果?AlphaGenome 2 的发布正是冲着这个问题去的。据发布方在Twitter上的公告,这是一个新的DNA序列模型,能够预测DNA变异在特定细胞类型中的影响,从而为理解复杂疾病提供关键信息。

传统变异效应预测工具往往给出一个"平均化"的答案,忽略了组织特异性。而大量复杂疾病——从自身免疫病到神经退行性疾病——恰恰只在特定细胞环境中才表现出病理特征。AlphaGenome 2 把"细胞类型"作为预测的基本维度,这一设定本身就比笼统的变异打分更有生物学意义。
细胞类型特异性:复杂疾病研究的关键切口
公告中反复强调"different specific cell types",这不是随口一提的修饰词。复杂疾病的遗传基础通常由大量效应微弱的变异共同构成,而这些变异往往落在非编码区,通过调控基因表达发挥作用。调控逻辑高度依赖细胞环境:一个增强子序列在肝细胞中可能活跃,在神经元中却沉默。
因此,能够按细胞类型预测变异影响,意味着研究者可以把全基因组关联分析得到的候选位点,直接映射到具体细胞背景下去解读。对于药物靶点发现而言,这比一个全局性的致病性评分更接近可操作的线索。公告明确将"understanding complex diseases"作为核心应用场景,定位清晰。
非编码区约占人类基因组的98%,绝大多数全基因组关联分析(GWAS)识别出的疾病相关变异都落在这一区域,而非蛋白质编码序列。这些变异并不改变蛋白质结构,而是通过影响增强子、启动子、绝缘子等调控元件的活性来改变基因表达水平。由于同一调控元件在不同细胞类型中受不同的转录因子组合和染色质状态调控,其活性具有强烈的组织特异性。这正是为什么一个变异可能只在特定细胞环境中产生功能后果,也是细胞类型分辨率的变异效应预测被视为解读GWAS信号下游机制的关键环节。
API开放:学术研究的可用性设计
AlphaGenome 2 目前通过API向学术研究开放。这一分发方式值得注意:它降低了使用门槛,研究者无需自行复现模型或准备大规模算力,即可把变异效应预测嵌入自己的分析流程。
不过公告信息有限,API的调用限制、支持的细胞类型覆盖范围、输入格式与输出粒度等关键细节均未披露。对于打算在实际课题中采用该模型的研究者,这些是决定可用性的核心参数,需要以官方文档为准。
在基因组学领域,深度学习模型的可用性长期受制于算力与工程门槛:一个大规模DNA序列模型往往需要数十至数百GPU的训练资源,复现与部署成本极高。以API形式提供推理服务,使研究者只需上传变异位点与目标细胞类型即可获得预测结果,实质上是把模型能力封装为一种云服务。这种分发模式在蛋白质结构预测领域已有先例,并显著扩大了非计算背景研究者的采用范围。但其局限也显而易见:研究者无法针对自身数据微调模型,也难以深入审查模型的内部表征,对方法学透明性要求较高的课题而言,API封装可能构成一定障碍。
冷静看待:公告之外的空白
这条发布信息本质上是产品公告,而非技术论文。模型架构、训练数据规模、基准测试表现、与现有方法的对比结果,均未在公告中呈现。对于DNA序列模型这类快速迭代的方向,缺乏基准数据意味着无法判断其相对优势究竟有多大。
另一个现实约束是"学术研究"的限定范围。产业界用户能否获得访问权限、商业化使用是否受限,公告没有说明。这会影响该模型在转化研究中的实际渗透速度。
总体而言,AlphaGenome 2 提出的方向——细胞类型特异的变异效应预测——切中了复杂疾病遗传学研究的真实痛点。但在独立评测和技术细节公开之前,对其能力的判断应保持审慎。对非编码变异的功能解读仍是基因组学最难的开放问题之一,一个模型能否实质性推进这一领域,最终要靠同行评议和可复现的基准来回答。
评估DNA序列模型的基准表现,通常依赖几类公开任务:变异效应预测(如区分eQTL阳性与阴性变异)、调控元件活性预测、基因表达预测以及染色质状态预测等。业内常参考的评测框架包括对GTEx等队列中eQTL信号的复现能力,以及在留出染色体或留出细胞类型上的泛化表现。缺乏这些基准数据时,无法判断模型是否真正优于既有的序列到功能模型,也无法排除其在训练分布外细胞类型上性能下降的可能。对于声称具备细胞类型分辨率的模型,跨细胞类型的泛化能力尤其值得独立检验。
相关推荐

Punchcutter:一句话或手写体,生成真实字体家族
Punchcutter 是一款免费开源的 AI 字体生成工具,兼容 Claude、ChatGPT、Codex 和 Cursor。输入一句话或手写照片,即可生成 TTF、OTF、可变字体和 Web 字体家族,自带 Studio 应用。
OffiAI:把AI编程会话搬进3D办公室的Mac应用
OffiAI 是一款免费 Mac 应用,将 Claude Code、Codex、Cowork 和 Gemini 会话放入 3D 办公室工位,支持多代理任务管理,无需账号且本地处理数据。

Puffin:为AI智能体提供身份与收件箱,接管你的数字沟通
Puffin为AI智能体提供独立邮箱、Discord/Slack/Telegram席位和日历,支持审批与全自动驾驶双模式,让智能体以数字身份融入团队协作。