AMD 395核显跑Qwen3大模型:Windows下的本地部署实测

AMD 395核显Windows本地跑大模型:开源引擎GFX1151 Engine实测全记录
B站UP主「仿宝剪蛮」开源了GFX1151 Engine推理引擎,让AMD 395(8060S核显)得以在Windows上运行Qwen3 Flash-Next大模型。引擎提供预编译包,部署门槛极低,但受限于Windows平台的资源竞争和专用算子优化程度,实测预填充速度约900 token/秒、生成速度30~40 token/秒,全部96GB显存会被占满。作者坦言主要靠Kimi/ChatGPT辅助开发、逆向参考了原闭源Linux方案才达到现有性能,上限明显低于对标的Linux方案(1200~1400 token)。该项目更适合Windows用户入门体验和二次开发学习,不建议当生产力主力使用。
一个开源引擎,让395在Windows上跑起大模型
B站UP主「仿宝剪蛮」最近折腾出一件颇有意思的事:让 AMD 395(搭载 8060S 核显)在 Windows 系统上运行 Qwen3 系列的 Flash-Next 大模型。在此之前,他介绍过一个名为 Hologen Flash Server 的方案,但那个项目只能跑在 Linux 上、闭源、且依赖 Docker 部署,门槛不低。
为了让 Windows 用户也能体验,这位UP主自己动手写了一个推理引擎,取了个相当朴素的名字——GFX1151 Engine,并已经在 GitHub 上开源。核心定位很明确:性能会比原项目差一些,但支持 Windows,适合想自己动手改、学习方案机制的开发者和爱好者。
这类围绕 AMD APU 核显做本地大模型推理的尝试,正是当下「用消费级硬件跑大模型」热潮的一个缩影。专用内核、专用算子对发挥 395 这类硬件的潜力至关重要,这也是整个折腾过程最大的技术看点。
**AMD 395(龙晟/Strix Halo)**搭载的8060S核显是当前消费级APU中集成GPU规模最大的产品之一,集成了40个RDNA 3.5计算单元,更关键的是配备了高达96GB的统一内存(LPDDR5X),CPU与GPU共享这块内存池。这一架构让它在本地大模型推理上颇具吸引力:相比独显方案无需PCIe带宽瓶颈,模型权重可以直接驻留在统一内存中被GPU访问。代价是内存带宽由CPU和GPU共享竞争,且ROCm(AMD的GPU计算平台)在Windows上的生态成熟度远不及Linux,需要专门编写针对GFX1151架构(即8060S的GPU架构代号)的算子内核才能充分发挥性能。
部署流程:下载即用,权重放对位置
整个使用流程被作者做得相当简单。GitHub 上提供了已经编译好的程序包,下载解压后直接打开即可,无需复杂的编译环境配置。
关键一步是放置模型权重:把权重文件丢到程序目录下的 Models 文件夹即可。作者提醒,他视频里用的是自己转换过的权重,和官方版本不一样,普通用户直接用官方权重就行——Hugging Face 和 ModelScope(魔搭)上都能找到,国内用户走魔搭下载会快很多。
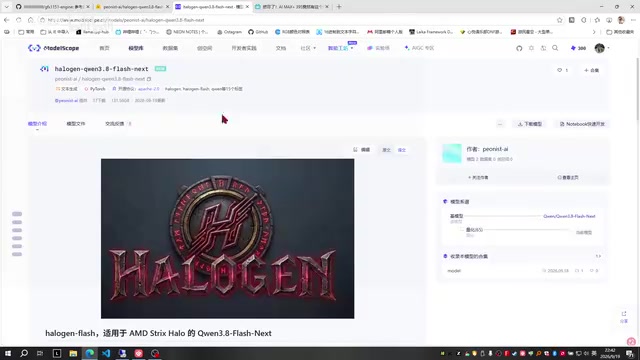
模型准备好后,可以调整几个参数,比如端口、上下文长度、MTP 草稿 Token(默认为 3)等。作者坦言更靠后的参数「我自己都不知道是干嘛用的」,建议保持默认不要乱动。双击运行即可启动,操作门槛被压到很低。
性能实测:96G显存被吃光,900 token左右
运行起来后出现了一个让人略感意外的现象:96G 的显存会被全部吃光,SSD 读写速度维持在 4GB/秒左右。
作者解释了背后原因:这个模型权重总量约 116G,其中一部分被卸载(offload)到 SSD 上,但有 60 多G 是必须塞进显存的;为了提升推理性能,引擎会主动占用大量显存。这是性能换空间的典型取舍,「跑不掉,也没有什么好办法」。
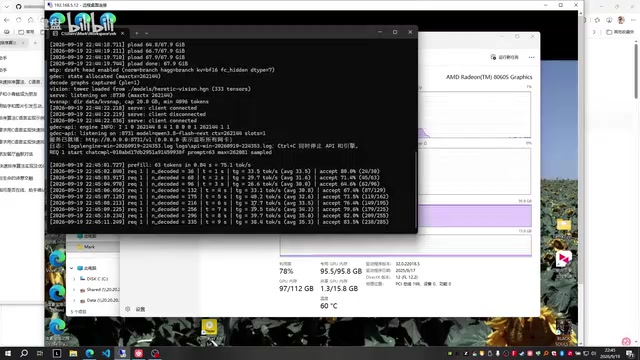
实测对话生成速度为每秒 30 到 40 token,具体取决于投机采样的接受率。作者还演示了在 Z.ai Code 环境下处理系统提示词的场景:重复输出时接受率更高,速度能冲到 40 token;处理一段 Z Code 系统提示词大约耗时 18 秒完成。
一个值得注意的细节是 Windows 平台的「抢资源」问题——后台应用若占用内存带宽或 CPU,推理速度会明显受影响。这也是作者反复表达「不太喜欢 Windows」的原因之一。
**投机采样(Speculative Decoding)**是这里提到「接受率」的技术背景。传统自回归推理每次只生成一个token,投机采样的思路是:先用一个小型「草稿模型」快速生成多个候选token(即MTP草稿Token,默认值3),再交给主模型一次性验证。如果草稿token被接受,就相当于一次前向传播完成了多步生成,吞吐量大幅提升。接受率越高,加速效果越明显——这正是为什么在重复性输出(如代码补全)时速度更快,而生成多样性强的内容时速度偏低。参数里的「MTP草稿Token数量」本质上是在接受率和计算开销之间做权衡,数值太大反而可能因为草稿频繁被拒绝而得不偿失。
性能瓶颈:外行人靠顶级AI也难调到最优
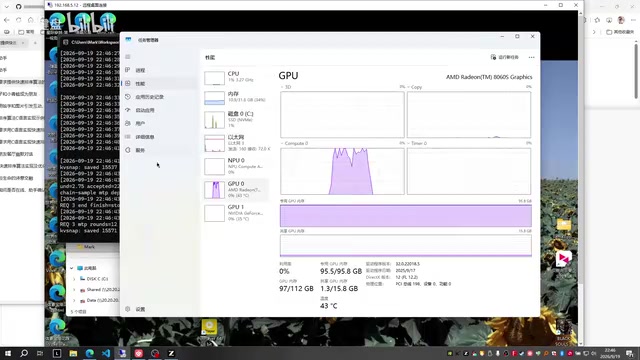
在一段较长任务的测试中,预填充(prefill)速度达到了 870 到 900 token 左右。作者直言,这个框架的性能上限大约就在 900 到 1000 token,在 Windows 上被抢占一些资源后,基本徘徊在 900 左右,「勉强可用」。
这段分享里最真诚的部分,是作者对自己技术边界的坦白。他表示自己并非专业工程师,开发过程主要依靠 Kimi、ChatGPT 等顶级大模型辅助——「哪个额度没了就换下一个接力」。但他发现,即便是这三个头部模型,也很难把性能调到最佳:
我在自己做到 600 左右 token 的时候,再往上提升就很难很难了,真的非常非常难。
最终他通过逆向参考 Hologen Flash Server 的方案,才把水平提升到 800 到 1000 token。他毫不避讳地承认这是「抄人家的作业」,核心思路来自原开源项目,自己的工作仅供参考学习。相比之下,那个闭源 Linux 项目能做到 1200 到 1400 token,差距明显。
预填充(Prefill)速度与解码(Decode)速度是衡量大模型推理性能的两个不同维度。预填充阶段处理的是输入的整段提示词(prompt),可以并行计算所有token的注意力,属于计算密集型,通常以「每秒处理多少输入token」来衡量;解码阶段逐token生成输出,受限于显存带宽,是内存带宽密集型任务。文中「900 token」指的是预填充速度,「30~40 token/秒」则是解码速度。对于AMD 395这类APU,CPU与GPU共享内存带宽,后台进程抢占带宽会同时拖累这两个阶段,这正是Windows平台资源争抢问题格外突出的原因。
实用建议:生产力场景要谨慎
关于这个项目到底该怎么用,作者给出了相当务实的分流建议:
- 追求最佳性能、用 Linux 的用户:直接用原来的 Hologen Flash Server 方案,性能更强(1200~1400 token)。
- 想在 Windows 上 DIY、学习方案机制的用户:可以 fork GFX1151 Engine 自己改。
但对于想把它当生产力工具的人,作者态度偏悲观。极限的显存占用意味着:如果你指望一边部署模型、一边把这台机器当 Windows 办公机正常使用,性能会受到很大影响。它更像是「一个 Windows 用户的替代方案」,将就能用。
写在最后
这期内容的价值不只在于一个能用的 Windows 推理引擎,更在于它真实呈现了普通爱好者用消费级 AMD 硬件折腾本地大模型的全貌:从硬件潜力、部署便利性,到性能瓶颈和显存代价,再到一个「非专业人士借助 AI 做工程」的真实天花板。
专用算子和内核优化对 395 这类硬件的性能释放确实关键,而这恰恰是开源社区协作最能发力的地方。作者也发出了邀请:如果有更懂内核算法的「大手子」愿意继续优化,欢迎一起来把它做得更好。
相关推荐

谷歌推出全新Gemini企业智能体:一个提示框搞定所有工作
谷歌在NASA一号机库的Gemini at Work活动上推出全新Gemini企业智能体,一个提示框即可完成问答、知识工作、图像生成和代码运行。本文解析其统一智能体、持久执行、多智能体编排等六大核心架构原则。

Markdown为何成为人机与AI智能体沟通的通用语言
Markdown正成为人机与AI智能体之间的通用信息表示格式。本文解析它为何胜出,以及非结构化数据转Markdown这一关键翻译层对AI应用的意义。

Pollo AI 携手 OpenAI 模型,把创意变成完整广告战役
Pollo AI 整合 GPT-5.6、GPT-6 Astra 与 GPT-Image-2.5 等 OpenAI 模型,打通创意构思、图像生成到电影级视频广告的完整工作流,帮助创作者将灵感快速转化为营销战役。