AMD MoRI + vLLM:面向MoE的宽专家并行与RDMA KV缓存传输

AMD工程师将在PyTorch Conference 2026展示结合宽专家并行与RDMA KV传输的MoE分离式推理方案。
AMD的三位工程师计划在PyTorch Conference 2026上以海报形式展示一套面向混合专家模型(MoE)的推理优化方案,核心技术包括宽专家并行(Wide Expert Parallelism)与RDMA KV缓存传输,并将AMD自身的技术栈MoRI与开源推理框架vLLM深度集成。宽专家并行通过将专家横向铺开至更多设备来提升并行度、均衡负载;RDMA则被用于分离式推理架构中跨节点传输体积庞大的KV缓存,以降低端到端延迟。这项工作体现了AMD在大模型推理软件栈上的持续布局,意在通过开源生态的整合拓宽其在AI服务领域的影响力。具体性能数据与架构细节预计将在会议现场正式披露。
AMD在PyTorch Conference展示MoE服务新方案
来自AMD的三位工程师——AI模型研究员Ravi Gupta、GPU软件开发者Rishi Madhuri和AI工程师Shiksha——将在PyTorch Conference 2026上带来一场海报展示,主题聚焦于宽专家并行(Wide Expert Parallelism)与RDMA KV缓存传输,用于在AMD硬件平台上实现分离式(disaggregated)MoE模型的高效服务。
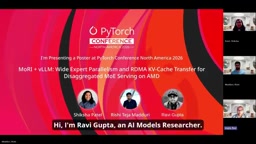
从公开的预告信息来看,这项工作的核心是将MoRI(AMD的相关技术栈)与业界广泛使用的推理框架vLLM结合,针对混合专家模型(Mixture-of-Experts, MoE)在大规模部署时面临的性能瓶颈提供优化路径。
为什么宽专家并行值得关注
MoE架构近年来成为大模型扩展参数规模的主流路径。它通过将模型拆分为多个"专家"子网络,并在推理时仅激活其中一部分,从而在控制计算成本的同时大幅提升模型容量。但这种架构在实际部署中带来了新的工程挑战:专家分布在不同设备上,如何高效地在节点间路由token、同步数据,直接决定了服务的吞吐与延迟。
宽专家并行正是针对这一问题的策略,它将专家横向铺开到更多设备上,以减少单设备的负载压力并提升整体并行度。AMD团队将其与vLLM集成,意味着这套方案有望在开源生态中被更广泛地采用和验证。
值得注意的是,MoE架构面临的一个特殊挑战是「专家负载不均衡」(Expert Load Imbalance):不同专家被激活的频率差异悬殊,容易造成部分设备空闲、部分设备过载的情况。宽专家并行(Wide Expert Parallelism)在设备维度上横向扩展专家分布,与传统的张量并行或流水线并行不同,它侧重于让更多设备各自承载独立的专家权重,从而在token路由时能够跨越更大的设备池进行负载均衡。这种策略在专家数量极多(如DeepSeek广告-V3的256个专家)的模型上尤为关键——每次推理只激活少数专家,宽并行度意味着热门专家可以被复制到多张卡上分摊压力,冷门专家则不占用额外内存。其代价是节点间通信量随并行宽度线性增长,因此需要配套高带宽互联方案。
RDMA KV缓存传输的意义
在分离式推理(disaggregated serving)架构中,预填充(prefill)和解码(decode)阶段通常被拆分到不同的硬件资源上执行,这就需要在阶段之间高效传输KV缓存。KV缓存往往体积庞大,传输效率成为端到端延迟的关键因素。
**RDMA(远程直接内存访问)**技术允许设备绕过CPU直接访问远程内存,从而显著降低数据传输的延迟与开销。AMD将RDMA用于KV缓存传输,正是为了解决分离式MoE服务中跨节点数据流动的瓶颈,这对追求低延迟、高并发的生产级推理服务尤为重要。
分离式推理(Disaggregated Serving)是近两年高性能推理架构的重要趋势,其核心思想是将计算特征截然不同的预填充阶段(Prefill,计算密集)与解码阶段(Decode,内存带宽密集)解耦,分配到各自最适合的硬件资源池中独立扩缩容。这样做可以避免两类任务互相干扰、资源利用率低的问题。然而,解耦带来了新的数据移动需求:预填充节点生成的KV缓存必须实时传递给解码节点,而对于长上下文或大批量请求,单次传输的KV缓存可能高达数GB。RDMA(Remote Direct Memory Access)通过绕过操作系统内核、让网卡直接读写远端GPU显存,将传输延迟从微秒级的TCP协议栈开销压缩到纳秒量级,同时大幅降低CPU占用。AMD的ROCm生态通过支持RDMA over Converged Ethernet(RoCE)实现这一能力,与InfiniBand方案形成竞争,使AMD卡组成的集群在分离式推理场景下具备与NVIDIA方案抗衡的数据传输基础。
AMD生态的进一步布局
这项工作由AMD内部的研究员与工程师共同推进,体现出AMD在AI推理软件栈上的持续投入。长期以来,大模型推理优化的讨论多集中在特定厂商的硬件生态,而AMD通过与vLLM这类开源框架的深度集成,正在尝试拓宽自身在AI服务领域的影响力。
对于关注MoE部署与异构硬件推理的开发者而言,这场海报展示值得留意。它将MoE服务中的三大核心议题——专家并行、分离式架构、KV缓存传输——整合在一个面向AMD平台的实践方案中。
小结
目前公开的信息仍以预告为主,具体的性能数据、架构细节和实现代码预计会在PyTorch Conference 2026的现场展示中进一步披露。对于希望在AMD硬件上部署大规模MoE模型的团队,这套结合MoRI与vLLM的方案提供了一个值得跟进的技术方向。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。