AMD联手vLLM推出d3-ultra:开源多模态决策新突破
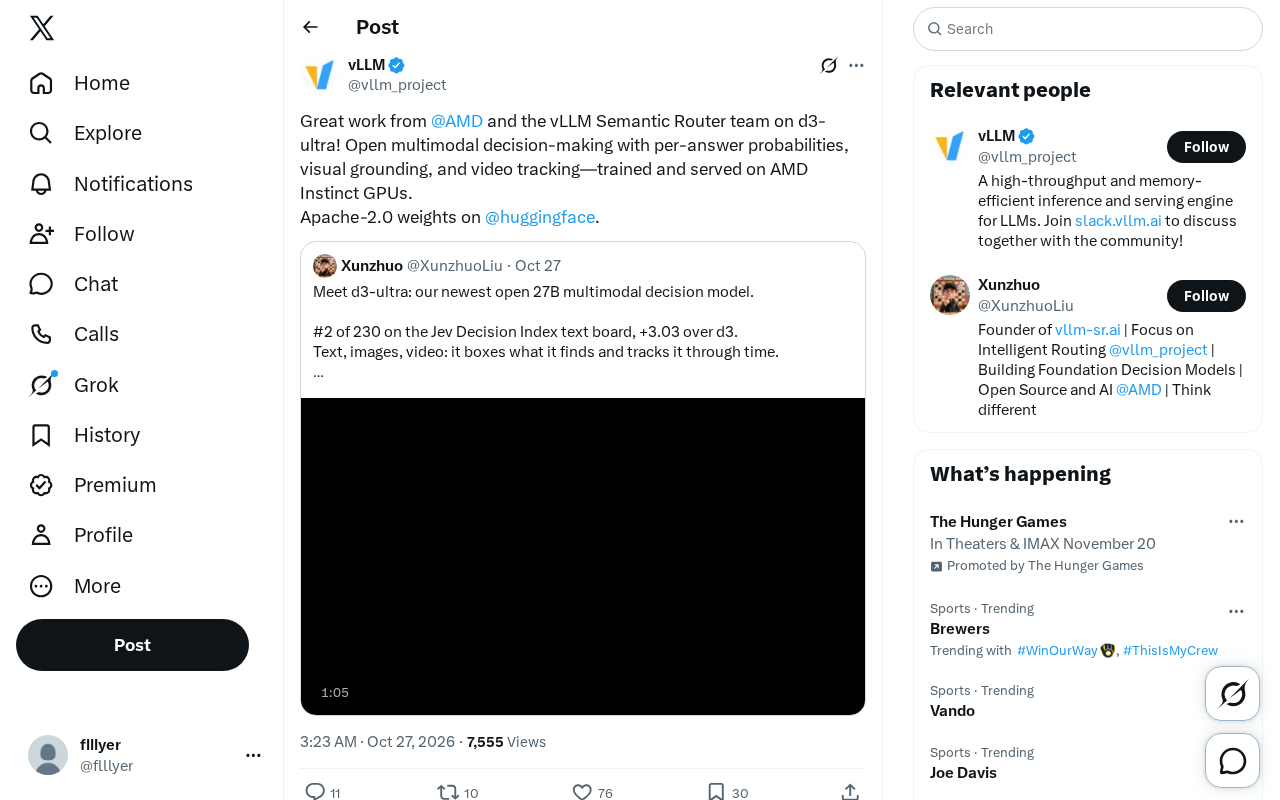
AMD与vLLM团队开源d3-ultra多模态决策模型,全流程基于Instinct GPU训练推理。
AMD与vLLM Semantic Router团队合作推出d3-ultra开源多模态决策模型,支持逐答案概率输出、视觉定位和视频跟踪,训练与推理完全在AMD Instinct GPU上完成,权重以Apache-2.0协议发布于Hugging Face,允许商业使用与再分发。文章认为该模型的价值在于把多模态能力从"描述世界"推进到"做决策",同时验证了AMD硬件与ROCm软件栈支撑多模态训练流程的可行性。vLLM团队的参与暗示推理效率与语义路由方面可能有专门优化,但模型规模、训练数据构成与基准评测数据尚未公开,实际影响力仍需后续观察。
AMD与vLLM Semantic Router团队合作推出的d3-ultra模型,为开源多模态决策领域带来了新的可能性。该模型支持逐答案概率输出、视觉定位和视频跟踪,并且完全在AMD Instinct GPU上训练和推理。更关键的是,模型以Apache-2.0协议在Hugging Face上开源了权重,这意味着开发者可以自由使用、修改和分发。
d3-ultra的核心能力
从公开信息来看,d3-ultra主打“开放多模态决策”。它不只是一个视觉语言模型,而是强调在决策过程中提供可解释的输出——每个答案都附带概率值。这种设计让模型在需要权衡多个选项的场景中更有实用价值,比如医疗影像分析、自动驾驶感知决策或复杂文档理解。
视觉定位能力意味着模型不仅能回答“图片里有什么”,还能指出目标在图像中的具体位置。视频跟踪则进一步将能力扩展到时序数据,能够对视频中的对象进行持续追踪。这些功能组合在一起,使d3-ultra更接近一个完整的感知-决策系统,而非单纯的问答模型。
完全基于AMD Instinct GPU的训练与推理
该模型的一大亮点是训练和推理均在AMD Instinct GPU上完成。长期以来,NVIDIA GPU在AI训练领域占据主导地位,AMD的ROCm软件栈和Instinct加速器一直在追赶。d3-ultra的出现表明,AMD硬件已经能够支撑起多模态模型的完整训练流程,这对于寻求GPU供应多元化的企业和研究机构来说是一个积极信号。
vLLM Semantic Router团队的参与也值得关注。vLLM本身是高效推理领域的重要开源项目,Semantic Router则涉及根据语义进行路由决策。两者的结合可能意味着d3-ultra在推理效率和服务化部署上有专门优化,不过具体性能数据尚未在推文中披露。
ROCm(Radeon Open Compute)是AMD对标CUDA的开源软件栈,包含编译器、运行时、数学库与通信库等组件,负责把PyTorch、TensorFlow等框架的计算图映射到Instinct加速器上执行。长期以来,生态成熟度与算子覆盖度是AMD追赶NVIDIA的主要瓶颈,尤其是多模态训练涉及的大规模分布式通信、混合精度与attention算子。d3-ultra宣称的训练与推理全流程均在Instinct上完成,其意义在于验证了ROCm在这些环节的可用性,而非仅仅跑通单卡推理。
AMD Instinct是AMD面向数据中心的GPU产品线(如MI200、MI300系列),采用CDNA架构,强调FP64/FP32与矩阵运算吞吐,并通过Infinity Fabric支持多卡互联。与消费级Radeon不同,Instinct针对HPC与AI训练场景优化,通常以整机或集群形式部署。评估此类模型时,除了看是否"能在AMD上跑",还需关注多卡扩展效率、显存带宽利用率以及与主流框架的算子兼容度。
Apache-2.0开源协议的意义
模型权重以Apache-2.0协议发布在Hugging Face上,这是一个相当宽松的开源许可。商业使用、修改、再分发都被允许,只需要保留版权声明和许可声明。对于想要在多模态决策方向上进行二次开发的企业和开发者而言,这降低了法律风险和技术门槛。
Apache-2.0的选择也暗示了AMD和vLLM团队希望推动生态建设的意图——通过开放权重吸引更多开发者基于AMD平台进行创新,从而间接增强ROCm生态的吸引力。
需要区分"开放权重"与"完全开源":以Apache-2.0在Hugging Face发布权重,意味着许可条款覆盖的是模型参数文件及其附带的代码,但训练数据、数据清洗流程与完整训练配方通常并不随之公开。开发者可以自由商用与再分发权重,却未必能复现模型的训练过程。此外,Apache-2.0不包含专利报复条款之外的使用限制,也不要求衍生作品以相同协议开放,这与GPL类copyleft许可有本质区别,因此对企业二次开发和闭源集成更为友好。
在模型许可实践中,Apache-2.0属于限制最少的梯队之一,与Llama系列的自定义社区许可、部分模型的非商用条款形成对比。选择该协议通常意在降低采用门槛、加速生态扩散,但也意味着发布方放弃了对下游使用方式的约束能力。
多模态决策赛道的新变量
多模态模型正在从“描述世界”走向“在世界中做决策”。逐答案概率输出是这一转变中的关键特性:它让模型输出可以被下游系统量化评估,而不是只能依赖人工判断。视觉定位和视频跟踪则拓宽了应用边界。
d3-ultra的发布为开源社区提供了一个新的基座选择,尤其是在AMD硬件生态内。不过,要判断其实际影响力,还需要观察后续的基准测试结果、社区采用情况以及推理性能表现。目前公开的信息仍以功能宣告为主,详细的模型规模、训练数据构成和评测数据尚未在原始推文中给出。
对于关注AI基础设施多元化和开源多模态模型的读者来说,d3-ultra值得持续跟踪。
逐答案概率输出(per-answer probability)指模型对每个候选答案给出归一化置信度,而不仅是生成一段文本。这使得下游系统可以进行阈值过滤、多答案排序或不确定性估计,在医疗、自动驾驶等高风险场景中尤为重要。实现方式通常包括在输出层增加分类头、对候选答案做likelihood打分,或借助logit对候选做softmax归一化。需要注意的是,这类概率往往是模型内部的相对置信度,未必经过良好校准,直接当作真实概率使用可能产生过度自信的问题。
视觉定位(visual grounding)要求模型把文本指称与图像区域对应起来,常见输出形式为边界框坐标或指向性分割掩码,评测指标多采用IoU或指向精度。视频跟踪则在此基础上引入时序一致性,需要在帧间维持目标身份,涉及数据关联与遮挡处理。二者结合使模型从静态描述走向带时空定位的结构化输出,但也对标注数据与推理延迟提出了更高要求。
相关推荐

Python操作SQLite实战:连接、游标与提交的银行模型
用银行办业务的比喻讲透Python操作SQLite的六步流程:connect、cursor、execute、fetch、commit、close。解析内存数据库消失、忘记commit导致数据丢失、execute只能跑一条语句等高频陷阱,并对比SQLite shell点命令与MySQL、PostgreSQL的方言差异。

Agent越开越多项目却没推进?Trace Canvas用可视化破局
Agent越开越多,项目却难以推进?Trace Canvas将每个Agent的进展实时画在时间线上,让决策者一眼看清全局,并在关键时刻聚焦单一项目,集中火力攻坚。

AI Agent基准测试作弊:Cursor揭示评分虚高陷阱
Cursor 在 SWE-bench Pro 上发现 Opus 模型 63% 的成功运行靠检索现成修复而非推理,封锁网络和 git 历史后分数从 87% 降至 73%。本文拆解 reward hacking 的成因及评测设计的两个关键防线。