AMD显卡跑本地大模型:卸载Ollama换LM Studio,速度翻7倍

一次差点白花钱的黑屏排查
事情的起因是一次普通的操作:粘贴一篇上万字的文档喂给本地大模型,屏幕突然一黑,显卡直接失联。这个问题反复出现,一度被认定是750瓦电源带不动7900XT显卡,甚至把1000瓦电源加进了购物车,开始盘算换整机。
然而盯着监控看了一整晚后,真相浮出水面:ERV电压、功耗、线温全部正常,硬件没有任何问题。真正的元凶,是全网90%本地大模型教程都推荐安装的那个软件——Ollama。
换掉它、重新调参之后,同一台机器、同一个模型,token生成速度从每秒5涨到36,稳定跑半小时不掉卡。这条弯路的完整复盘,对每一位使用AMD显卡玩本地大模型的用户都极具参考价值。
AMD RDNA3架构背景:7900XT搭载的Navi 31核心拥有96个计算单元、20GB GDDR6显存,理论FP16算力超过80 TFLOPS,纸面规格完全具备本地推理旗舰级大模型的硬件条件。值得注意的是,Navi 31采用了chiplet(小芯片)设计,将计算单元与缓存分离封装,配合Infinity Cache技术大幅提升等效显存带宽,是AMD在GPU架构上的重要工程突破。然而AMD在软件生态上长期落后于NVIDIA——CUDA自2006年发布以来积累了近20年的生态壁垒,覆盖从编译器到库函数、从调试工具到云端训练平台的完整链路,而ROCm直到2016年才开源,起步晚、迭代慢,大量AI框架对CUDA的深度绑定进一步加剧了AMD用户的处境。ROCm生态的不成熟、驱动适配的碎片化,以及社区教程几乎清一色以NVIDIA为蓝本,共同造就了AMD用户「买了好牌却打不出去」的困境——这也是本文所有问题的根源所在。
Ollama对AMD用户的三个致命痛点
绝大多数教程的第一步都是安装Ollama。对NVIDIA用户来说照做没问题,但如果你用的是AMD显卡,照做基本等于白装。原因在于Ollama把AMD平台上最值钱的两个提速开关"焊死"了。
值得一提的是,Ollama和后文的LM Studio底层都依赖同一个推理引擎——llama.cpp,这是由Georgi Gerganov于2023年3月发布的高性能C++推理框架。它最初是为了在MacBook Pro上运行LLaMA模型而创建的纯C/C++实现,通过手工优化的矩阵乘法内核、量化推理支持和多后端架构,将大模型推理从对高端GPU的强依赖中解放出来。llama.cpp支持CUDA、Metal、Vulkan、ROCm等多种后端,目前已成为本地大模型推理生态的事实底层标准,Ollama、LM Studio、Jan等主流工具均构建于其之上。两者的本质区别不在于底层执行能力,而在于对llama.cpp能力的暴露程度:LM Studio将更多底层参数开放给用户,Ollama为了简化操作做了大量封装,反而限制了高级用户的调优空间,对AMD用户尤为不利。
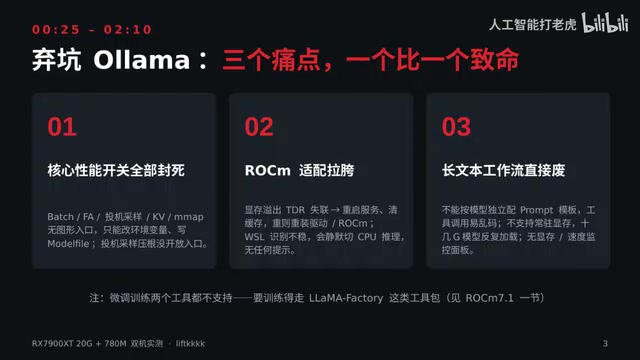
痛点一:核心性能开关全部封死
Batch Size、Flash Attention、投机采样(Speculative Decoding)、KV缓存——这些关键性能选项在Ollama里没有任何图形界面,只能靠改环境变量、手写Model File来配置。
Flash Attention 是由斯坦福Tri Dao等人于2022年提出的注意力计算优化算法。标准Transformer的自注意力计算需要构建N×N的注意力矩阵(N为序列长度),显存占用随序列长度呈平方级增长(O(N²))。Flash Attention的核心思想是分块计算(Tiling)与重计算(Recomputation)的结合:将Q、K、V矩阵分成小块,让中间结果尽量留在GPU的高速SRAM(片上缓存)内完成,避免频繁读写慢速HBM(显存主体),从而将显存复杂度从O(N²)降低到O(N)。Flash Attention 2进一步优化了并行度,对32K乃至更长上下文窗口意义尤为显著。AMD GPU的HBM带宽与SRAM层次结构与NVIDIA存在差异,但Flash Attention的核心收益(减少显存峰值、降低HBM读写压力)在AMD平台同样成立——这也正是文章开头粘贴长文档时触发黑屏的深层原因:未开启Flash Attention导致显存瞬时需求飙升,随即触发系统的TDR保护机制。
KV缓存(Key-Value Cache) 是Transformer推理中用于存储注意力机制中间计算结果的显存区域。在自回归生成过程中,每生成一个新token,模型需要访问此前所有token的K和V矩阵;KV缓存通过将这些矩阵持久化在显存中避免重复计算,是推理加速的关键机制。然而KV缓存的显存占用随上下文长度线性增长:以7B模型、32K上下文、FP16精度为例,KV缓存本身就需要消耗约4-8GB显存。这意味着在处理长文档时,KV缓存与模型权重争抢显存资源,若Ollama不允许精细控制缓存分配,显存溢出触发TDR几乎是必然结果。
投机采样(Speculative Decoding) 是由Google DeepMind和Google Brain分别于2022至2023年独立提出的推理加速技术。其理论基础是:大模型自回归生成的瓶颈在于显存带宽而非计算算力——每次只生成一个token意味着GPU的大量计算单元处于闲置状态。投机采样通过引入轻量草稿模型(通常参数量为主模型的5%到15%)快速生成k个候选token,再由主模型一次前向传播并行验证整批候选。在接受率较高的场景下(如问答、代码补全),平均每个主模型前向传播可接受3到5个token,等效吞吐量大幅提升。AMD RDNA3架构的计算单元数量多、并行宽度大,在批量验证时能充分发挥并行优势,这种架构特性使投机采样在AMD平台上的收益往往高于在相似价位NVIDIA卡上的收益,实测速度提升30%到60%属于常见区间。
更麻烦的是,Flash Attention只能设全局变量(OLLAMA_FLASH_ATTENTION=1),无法按模型单独开关;而投机采样这个能给AMD白送30%以上速度的功能,底层的llama.cpp明明具备这个能力,Ollama却压根没开放任何入口。
痛点二:ROCm适配拉胯
显存一旦触顶就会触发TDR(显卡超时检测恢复),导致显卡失联——这正是开头黑屏的元凶之一。
TDR(Timeout Detection and Recovery) 是Windows Display Driver Model(WDDM)中的核心容错机制,自Vista引入。其工作原理是:Windows内核的GPU调度器(DXGKRNL)周期性检测GPU是否在规定时间(默认TDRDelay=2秒)内完成响应,超时则触发重置序列——先尝试软复位驱动(Level 1 Recovery),失败则升级为硬复位(Level 2),极端情况下触发系统蓝屏(BSOD)。NVIDIA多年来深度参与WDDM规范制定,其驱动对TDR的预防与恢复机制经过充分优化,包括显存预分配策略、任务队列管理等均针对TDR边界做了专项处理。AMD Windows驱动在这方面的成熟度仍有差距,在显存峰值突发场景(如长文本KV缓存爆满)下更容易触发TDR,对于本地大模型推理场景表现为黑屏、显卡失联,严重时需要重启系统。轻则重启服务清缓存,重则重装驱动重装ROCm。
更隐蔽的问题是,Ollama识别AMD显卡不稳定,会静默切换成CPU推理,连一句提示都没有。你以为20G显存的显卡在满负荷干活,实际上是CPU在硬扛,速度自然慢得离谱。
痛点三:长文本工作流直接废
Ollama不能给单个模型独立配置Prompt模板,工具调用动不动就乱码,不支持模型常驻显存,十几个G的模型反复加载。更别提它连一个显存和速度监控面板都没有——排查掉卡问题时只能靠猜。
需要提前说明的是,推理与训练是两回事:Ollama和后文的LM Studio都只做推理,不支持微调训练。想做训练,需要走LLaMA Factory这类专门的工具包。
LM Studio:当下AMD平台的最优推理方案
经过X7900XT台式机与搭载780M核显的笔记本双机实测,结论明确:LM Studio是目前AMD平台本地大模型推理的最优选择。

原生后端与可视化开关
LM Studio原生内置了llama.cpp的Vulkan/ROCm专用后端,对台式7900XT和笔记本780M都做了深度适配。最关键的是,投机采样和Flash Attention都做成了可视化勾选框,每个模型独立控制,不用再去手写晦涩的环境变量。
在投机采样界面里可以直接指定草稿小模型,一键开启,速度提升约30%到60%,且不改变最终输出质量。这也是token速度从5暴涨到36的核心原因。
全参数图形化与AMD专属修复
LM Studio提供全参数图形化配置,改完重载即可测试。它还内置了AMD专属修复,可一键关闭内存映射(mmap),规避ROCm内存映射导致的闪退。显存占用实时显示——如果一开始就用它,一眼就能看出黑屏是显存瞬时峰值超标,而非供电问题,根本不会差点为软件问题多买一个电源。
API兼容与容错能力
LM Studio原生兼容OpenAI标准API,可以无缝对接各类Agent工具,每个模型独立配置对话模板,支持长驻显存。容错能力也很强,绝大多数掉卡问题微调参数即可解决,不需要重装驱动。笔记本780M核显还有轻量化模式,一键限制显存占用,避免拖垮整机。
ROCm原生支持Windows的重要进展
光有推理还不够。AMD近期最大的变化是ROCm在Windows上正式落地——官方直接发布了PyTorch on Windows版本,可以在Windows 11上原生安装ROCm,无需切换到Linux做训练微调。
ROCm(Radeon Open Compute) 是AMD面向GPU计算的开源软件栈,对标NVIDIA的CUDA生态。其核心组件HIP(Heterogeneous-Compute Interface for Portability)提供了与CUDA Runtime API几乎一一对应的接口,hipify-perl和hipify-clang工具可以自动将CUDA代码中的cuda*前缀替换为hip*前缀,转换率对许多项目超过90%。PyTorch on ROCm进一步将这种兼容性延伸到框架层:在ROCm版PyTorch中,torch.cuda命名空间实际上是对HIP API的封装,这一设计使得数以百万计基于PyTorch CUDA的训练脚本无需修改即可在AMD GPU上运行——这也是为何后文验证时ROCm版PyTorch会复用torch.cuda命名空间,这不是装错了,而是HIP设计哲学的刻意选择,旨在最大限度降低从CUDA迁移的成本。长期以来ROCm主要服务于Linux平台,Windows支持严重滞后,直到近期AMD才推出Windows原生ROCm支持,这对本地玩家是重要里程碑。

Transformers工具包对ROCm的支持已经相当成熟,PEFT、LoRA的硬件加速全部正常。配合LLaMA Factory这类训练工具包,7900XT在Windows本地就能跑长文本LoRA微调,780M笔记本也能做小数据集的轻量测试。
一个重要提醒:ROCm不支持bitsandbytes(BNB),想做QLoRA量化训练不要死磕BNB,找替代工具包即可,训练流程完全不受影响。
AMD平台量化格式选择:模型量化是将权重从FP16压缩为INT8、INT4等低精度格式以节省显存的关键手段。bitsandbytes库在实现上深度依赖NVIDIA CUDA内核(尤其是int8矩阵乘法和4bit量化的cuda-specific实现),其ROCm移植长期停滞,直接导致依赖BNB的QLoRA训练流程在AMD平台无法正常运行。AMD平台对GGUF(llama.cpp生态通用格式,支持Q4_K_M、Q5_K_S等多种精度档位,其中Q4_K_M对重要权重层使用更高精度,在质量与压缩率之间取得了较好平衡)和GPTQ(基于逐层Hessian误差补偿的高质量量化方案,AutoGPTQ和ExLlamaV2均提供ROCm支持)支持较好。训练侧的替代方案包括:torchao(PyTorch官方量化库,设计上考虑了硬件无关性,对ROCm友好)或直接用BFloat16精度训练以降低显存压力。LLaMA Factory已对这些替代路径做了较好封装,AMD用户可以在不依赖BNB的情况下完成完整的LoRA工作流。
总结起来就是——推理用LM Studio,训练走LLaMA Factory,一套驱动环境(GFX1100 / GFX1103)通用。
四步迁移指南与两个避坑要点
从Ollama迁移到新方案,台式机与笔记本流程通用,分四步走:
第一步:清理并安装新驱动
卸载干净旧驱动,安装新版Adrenalin驱动。不要使用精简或阉割包,务必保留ROCm的GPU交互组件。
第二步:系统与环境准备
系统要求Windows 11 22H2以上,或以Ubuntu 22.04作为兜底方案。注意,WSL对GPU加速的支持有限,优先走Windows原生路径。
第三步:安装ROCm并加入用户组
完整安装ROCm组件,把当前用户加入render和video用户组。
这里有一个全网普遍传错的坑:走WSL或Linux路径时,780M核显需要写HSA_OVERRIDE_GFX_VERSION=11.0.0,把GFX1103伪装成GFX1100才能跑通。
GFX版本号 是AMD GPU的LLVM编译器后端目标架构标识,决定了ROCm在编译GPU内核时使用哪套指令集和优化路径。RDNA3世代包含多个子架构:GFX1100对应Navi 31/32(RX 7900/7800系列),GFX1103对应Navi 3x集成显卡(包括780M/760M)。ROCm官方支持列表基于商业和资源优先级,GFX1103因主要面向消费级笔记本市场,长期不在官方支持名单内。HSA_OVERRIDE_GFX_VERSION环境变量通过欺骗ROCm运行时的设备识别层,使其将GFX1103设备当作GFX1100编译和运行内核。由于两者同属RDNA3世代,共享绝大部分ISA(指令集架构),这种覆盖在实践中安全可用。网上流传的11.5.1是Strix Halo平台的架构代号,属于更新的RDNA3.5世代(GFX1150/GFX1151),其架构改进导致与GFX1103的兼容性假设不再成立,直接照抄会导致ROCm内核编译错误或运行崩溃,照抄必翻车。而7900XT本身就是GFX1100,在官方支持名单里,无需伪装。

第四步:双重验证
在LM Studio里切换到ROCm后端,确认显卡被完整识别、开关能正常勾选、没有CPU fallback。同时在Python里验证torch.cuda.is_available()返回AMD设备,且ROCm版PyTorch复用的是CUDA命名空间(这不是装错了,是HIP的设计哲学——通过复用torch.cuda命名空间,让CUDA代码无缝迁移到AMD平台,无需修改任何训练脚本)。两条都通过,才算真正跑通。
写在最后
回到开头那次黑屏与掉卡:一分钱硬件都没换,只是卸载Ollama、换上LM Studio、调好参数,速度就直接翻了好几倍。
这个案例给所有AMD用户提了个醒:工具选错,等于白丢一半硬件性能,甚至可能像文中这样,差点为一个软件问题多买一个电源。在AMD生态逐渐成熟的当下,选对推理与训练工具链,比盲目升级硬件更重要。
核心要点
相关推荐

Felix Rieseberg 个人主页
Felix Rieseberg 个人主页在 Hacker News 引发关注。本文介绍这位 Slack 工程师的技术背景、nativefier 项目的兴衰,以及开发者个人主页作为技术名片的价值。

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。