安全测试的真相:验证保证本身,而非实现它的那行代码
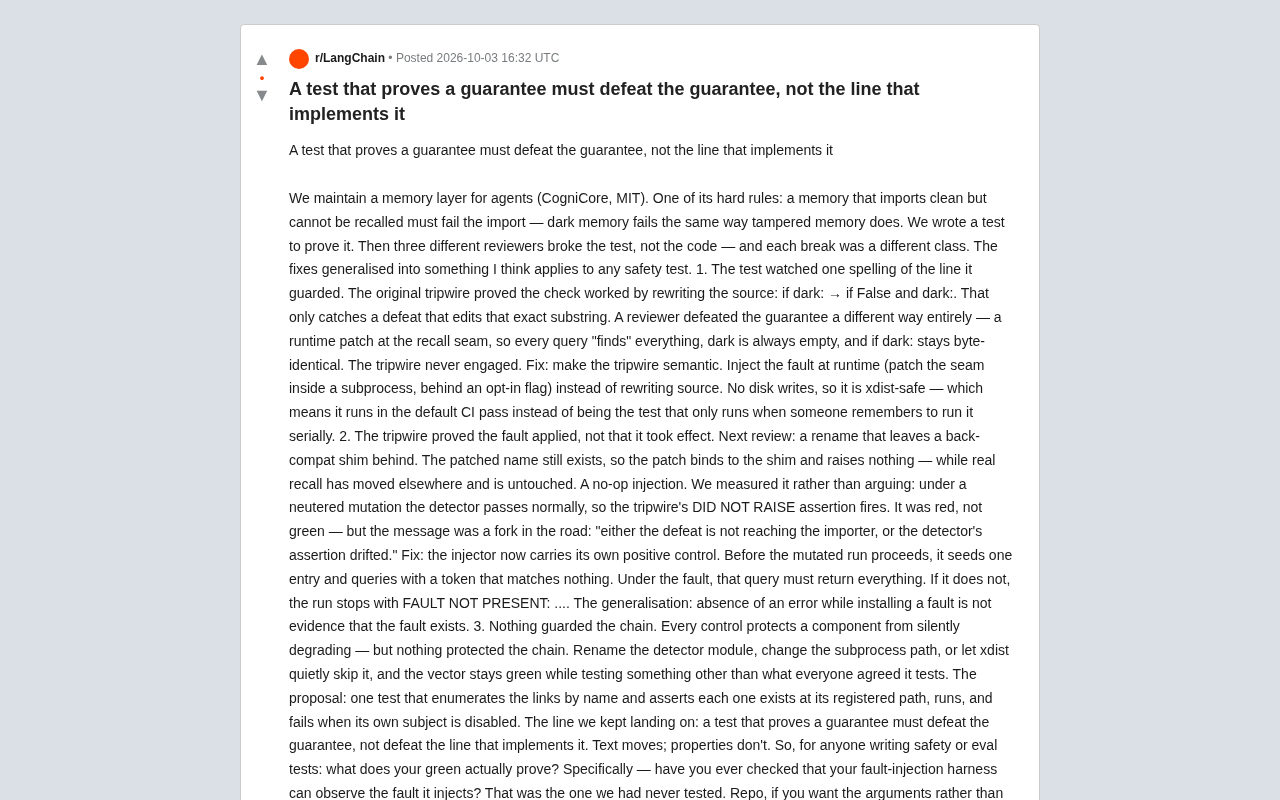
CogniCore团队记录了安全测试被三次以不同方式破坏的经过,归纳出"验证保证本身而非其实现"的测试原则。
CogniCore 团队在为 AI Agent 记忆层维护"暗记忆必须导入失败"这一安全保证时,发现他们的安全测试被三位不同审查者以三种截然不同的方式悄悄破坏,且每次测试始终亮绿灯。第一类失效是绊线只检查源码字符串,被运行时补丁绕过;第二类是故障注入命中了向后兼容的旧 shim 而非真正的执行路径,产生"空操作注入";第三类是每个组件都有测试,却没有任何机制守护整条链路的完整性。三次失效共同指向一个核心原则:安全测试必须验证"属性"而非"文本"——不能断言某行代码长什么样,而要断言某项性质是否在运行时真正成立,并且测试工具本身也必须能够观测到它自己注入的故障。
一个被三次打破的测试,揭示了安全测试的盲区
当你为 AI Agent 的记忆层写一个安全测试,并自信地看到它亮起绿灯时——你真正验证的究竟是什么?
CogniCore(MIT 许可,基于 SQLite、无向量数据库)团队在为其 Agent 记忆层维护一条硬性规则时,遭遇了一次深刻的教训。这条规则很直接:一段记忆如果能够干净地导入、却无法被召回,就必须让导入失败——也就是说,"暗记忆"(dark memory)必须和被篡改的记忆以同样的方式失败。
为了证明这条保证成立,他们写了一个测试。随后发生的事颇具戏剧性:三位不同的审查者先后破坏了这个测试,而且破坏的不是代码本身,而是测试。更关键的是,每一次破坏都属于一个不同的失效类别。这些修复经过归纳后,形成了一个作者认为适用于任何安全测试的通用原则。
三类失效:测试如何在"绿灯"下骗过所有人
第一类:测试只盯着实现它的那一行
最初的"绊线"(tripwire)通过改写源码来证明检查有效:把 if dark: 改写为 if False and dark:。问题在于,这种做法只能捕捉到恰好编辑了那个特定子串的破坏方式。
一位审查者用完全不同的手段击败了这条保证——在召回接缝处做了一个运行时补丁(runtime patch),让每个查询都"找到"所有内容。于是 dark 永远为空,而 if dark: 这一行字节不变。绊线从未触发。
修复方案是让绊线变得语义化:在运行时注入故障(在子进程内、通过显式启用的开关给接缝打补丁),而不是改写源码。由于不涉及磁盘写入,它对 pytest-xdist 并行安全(xdist-safe)——这意味着它能跑在默认的 CI 流程里,而不是沦为"只有有人记得串行运行时才会执行"的那种测试。
运行时补丁(runtime patch) 是指在程序执行期间动态替换某个函数、方法或模块属性,而不修改磁盘上的源文件。在 Python 生态中,unittest.mock.patch 是最常见的实现方式:它可以在测试范围内将任意可导入名称指向一个伪造对象,测试结束后自动还原。这类技术在测试中被广泛用于隔离外部依赖,但同样可以被用来"绕过"安全检查——只需将检查所依赖的函数替换成一个永远返回"安全"结果的版本即可。这正是第一类失效的核心:基于源码字符串的绊线完全无法感知运行时的名称绑定被替换,因为它检查的是静态文本,而程序实际执行的是动态绑定后的逻辑。
第二类:证明了故障被施加,却没证明故障生效
下一轮审查引入了一个更微妙的问题:一次重命名保留了向后兼容的 shim(垫片)。被打补丁的旧名字依然存在,于是补丁绑定到了 shim 上、什么也没抛出——而真正的召回逻辑已经搬到别处、丝毫未受影响。这是一次空操作注入(no-op injection)。
团队没有停留在争论,而是用测量来说话:在一个被"阉割"的变异下,检测器照常通过,于是绊线的 DID NOT RAISE 断言被触发。它是红的,不是绿的——但这条信息本身是一个岔路口:"要么是破坏没有抵达 importer,要么是检测器的断言发生了漂移。"
修复方案是让注入器自带正向对照(positive control)。在变异运行开始前,先植入一条记录,并用一个不匹配任何内容的 token 去查询。在故障状态下,这个查询必须返回所有内容;如果没有,运行就以 FAULT NOT PRESENT 中止。
由此归纳出的原则是:安装故障时没有报错,并不能证明故障确实存在。
向后兼容 shim(垫片) 是软件重构中常见的过渡手段:当一个函数或模块被重命名或迁移后,旧名称保留下来并转发调用到新位置,以避免破坏已有的调用方。这在大型代码库中极为常见,但对测试基础设施构成隐患——如果测试的补丁目标是旧名称(shim),而实际逻辑已迁移到新位置,补丁就只是修改了一个"空壳转发器",真正的执行路径毫发无损。正向对照(positive control) 这一概念借自实验科学:在每次实验中同时运行一个"已知应当产生阳性结果"的对照组,用来验证实验本身的检测能力是否正常工作。将这一思路引入故障注入测试,意味着在断言"故障被施加"之前,必须先用一个可预期的案例确认"检测机制确实能感知到故障"——这是防止空操作注入产生假绿灯的关键屏障。
第三类:没有任何东西守护"链条"本身
前两类修复都针对单个组件,但团队发现还有一个更隐蔽的漏洞:每一个控制机制都在保护某个组件不被悄悄降级,却没有任何东西保护整条链条。
重命名检测器模块、修改子进程路径,或者让 xdist 悄悄跳过它——这些操作都会让测试向量保持绿灯,而它实际测试的东西已经和大家约定它要测的东西不一样了。
他们的提案是:增加一个专门的测试,按名字逐一列举链条上的每个环节,断言每一个都存在于其注册的路径上、确实运行、并且在它自己的测试对象被禁用时失败。
这也呼应了整个讨论反复落回的那句话:
一个证明某项保证的测试,必须击败这项保证本身,而不是击败实现它的那一行代码。文本会移动,属性不会。(Text moves; properties don't.)
这类问题在软件工程中有时被称为测试覆盖的组合谬误:对每个组件单独编写测试并全部通过,并不能保证这些组件按预期方式组合在一起协同工作。对于安全保证而言,问题更为严峻——攻击面恰恰可能存在于组件之间的接缝处,而非组件内部。"链条完整性测试"的思路与集成测试和契约测试有所交叉,但侧重点不同:它不仅要验证各环节能否协同产生正确输出,还要验证各环节是否真的以注册的身份、在注册的路径上参与了执行——这是防止某个环节被悄悄替换或跳过而测试框架浑然不觉的最后一道防线。
对安全与评估测试的启示
这个案例对所有编写安全测试或评估(eval)测试的开发者都有直接的参考价值。核心拷问只有一句:你的绿灯到底证明了什么?
更具体地说:你是否检查过,你的故障注入工具(fault-injection harness)能否观测到它自己注入的那个故障?作者坦承,这恰恰是他们从未测试过的一环。
从工程实践角度看,这三类失效分别对应三种常见的脆弱假设:
- 假设一:以为盯住某行实现就等于守住了行为。实际上同一个行为可以有无数种实现与绕过方式。
- 假设二:以为"没报错"等于"故障已生效"。空操作注入会让你在虚假的安全感中通过测试。
- 假设三:以为每个组件都测了就等于整条链路都测了。链路的完整性需要被单独守护。
这套思路的价值在于把测试的焦点从"文本层面"提升到"属性层面"——不去断言某段代码长什么样,而去断言某项性质是否成立。对于 AI Agent 的记忆层、安全护栏乃至更广泛的评估体系而言,这种从实现到属性的视角转换,可能是避免"假绿灯"的关键。
完整的论证和代码位于项目仓库(github.com/cognicore-dev/cognicore-env,MIT 许可,基于 SQLite,无向量数据库)。
相关推荐
Aleph Alpha发布Kolibri:欧洲主权开放权重大模型
德国AI公司Aleph Alpha发布开放权重大模型Kolibri,主打"主权AI"定位,强调数据主权与本地化部署。本文解析其技术定位、欧洲AI自主战略及社区反响。
用DeepSeek一小时破解游戏坐标加密?一次AI逆向分析实录
一位B站UP主演示用国产大模型DeepSeek辅助逆向某游戏坐标加密算法。本文从AI代码分析能力、技术真实性与合规风险角度,理性解析AI辅助逆向工程的现状与边界。
0基础用Dify搭建写小说AI工作流:10分钟跑通教程
零基础教程:手把手教你用开源平台Dify搭建一个写小说的AI工作流。从GitHub安装、API Key配置模型,到Chatflow节点搭建与提示词设置,10分钟跑通你的第一个AI应用。