安全测试全过,产品测试却翻车:Statewave Guide 的实验复盘

AI产品知识可以零错误却毫无用处,架构需新增Guidance Compiler层翻译验证事实。
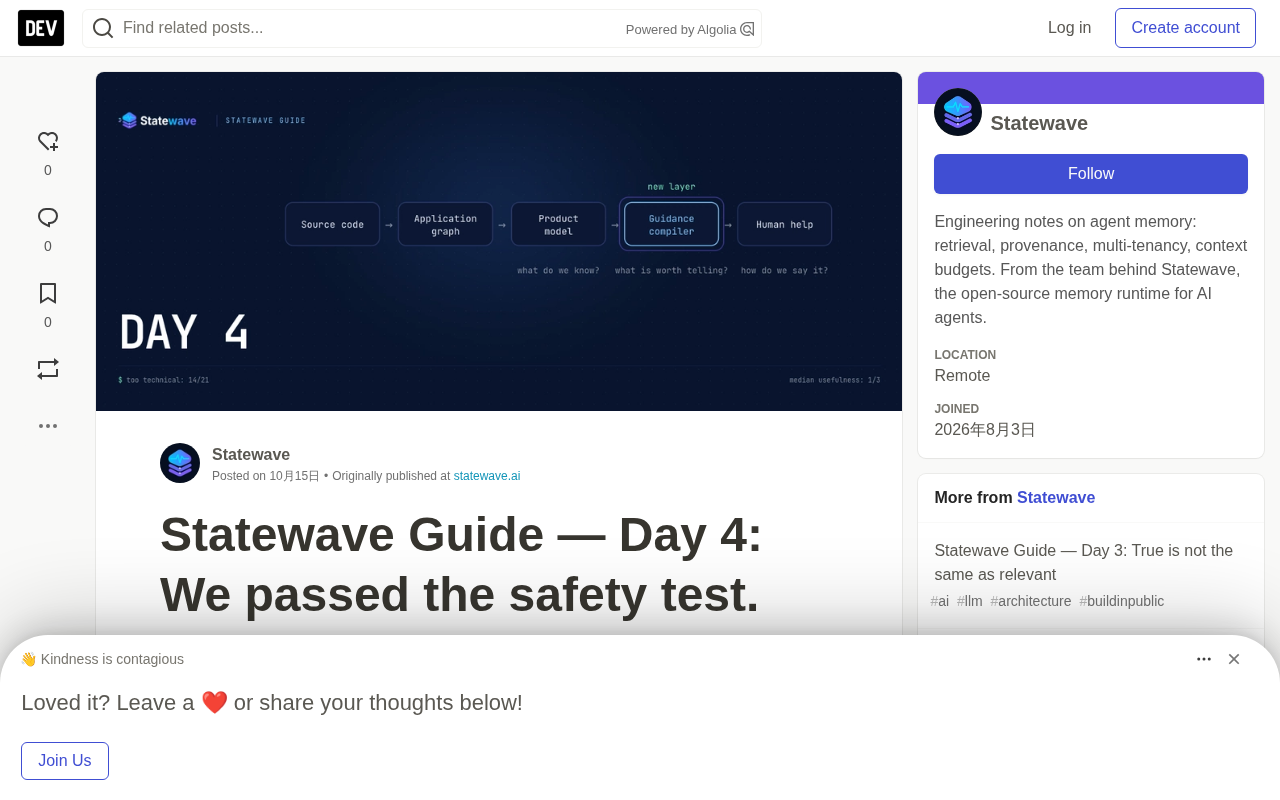
Statewave Guide 第四天实验揭示了一个反直觉结论:当模型不再胡编乱造后,真正的问题才开始。安全测试全过——错误声明0次、模型克制30/30、验证产出率95%,但产品测试中位数有用性仅1/3,只有24%被评为真正有用,几乎全部平庸。冒烟枪在于10个功能点直接向用户暴露调试语句,100%被评为过于技术化。团队由此意识到安全与有用是两条独立轴,问题可能出在呈现层而非能力层——修掉语言问题后能力信号才显现。架构因此新增Guidance Compiler层,负责把已验证的产品事实转化为人类可理解的指引,而不引入新的未经证实声明。
AI 生成的产品知识可以做到技术上完全正确,却依然对用户毫无用处。Statewave Guide 项目第四天的实验记录给出了一个反直觉的结论:当模型不再胡编乱造之后,真正的问题才刚刚开始。
安全测试:一次干净的全过
实验设置沿用前一天:单一模型 anthropic-opus-5,针对团队自己编写的一个应用,只检测预先知道要去寻找的模式。结果接近完美——错误功能声明被接受的次数为 0,无依据声明被接受的次数为 0,模型克制(model restraint)30/30,经过验证的声明产出率 95%。
这组数字说明,至少在「不让模型说错话」这件事上,基于验证的架构已经站稳了。凡是无法追溯到应用实际能力的声明,都被系统挡在了外面。安全性层面的防线没有漏洞。
问题在于,安全并不等于有用。
模型克制(model restraint) 指的是模型在面对缺乏证据支持的问题时,主动选择不给出确定性回答,而不是强行生成一个听起来合理的答案。它衡量的是模型"忍住不说"的能力:当某个功能是否真实存在、某项权限是否可用无法从应用实际能力中追溯确认时,模型应当拒绝断言,而不是用流畅的语言填补空白。
在验证驱动的架构中,模型克制是与幻觉率相对的另一极指标。幻觉率高说明模型说了不该说的话;克制率高说明模型在不该回答时保持沉默。30/30 意味着在所有需要克制的测试场景中没有一次越界。但需要警惕的是:克制率满分并不必然带来有用性,因为"什么都不说"和"说得让人看不懂"都可能让用户一无所获。
产品测试:三分之一的及格线
团队接着追问了第二个问题:这些输出真的能帮到人吗?
评分没有用真人来做。一个独立模型 OpenAI GPT-5.6 Sol 按照固定评分标准,对 21 个功能点逐一打分。它不是被测模型,所以这不算自评,但同样也不是人工审核——团队在原文中明确承认了这个局限。
结果是:中位数有用性 1/3,只有 24% 被评为「真正有用」。
没有危险错误,也没有完全无用的东西。但几乎一切都是平庸的。团队原本以为剩下的问题是能力缺失,数据却给出了不同答案:
1.43   有已验证能力的功能的平均分
1.14   没有已验证能力的功能的平均分
差距微乎其微。后来的一轮实验在修掉语言问题之后,同样的对比变成了 2.00 对 1.07,能力信号才真正显现——也就是说,信号一直存在,只是被糟糕的呈现方式掩盖了。
用另一个模型(OpenAI GPT-5.6 Sol)作为评判者,属于常见的 LLM-as-a-judge 评估范式。其核心假设是:不同模型家族之间存在一定的独立性,用模型 B 评判模型 A 的输出,可以规避模型给自己打分时的系统性偏好,也就是自评偏差。
这种方法的局限也很明显。评判模型依然可能对某些表述风格、术语密度或句式结构存在固有偏好,而这些偏好未必与真实用户的理解一致。它无法感知用户实际使用场景中的上下文,也无法复现人类对"啰嗦但清楚"和"简洁但费解"的微妙权衡。因此,24% 这个数值更应被理解为一种相对可比性的信号,而非绝对的可用性度量。团队引入它,是为了在没有大规模真人标注的条件下获得一个方向性的读点。
冒烟枪:调试语句直接念给用户听
最扎眼的发现是:21 个输出里有 14 个被判定为「过于技术化」,13 个被标记为缺少某项能力。
真正的问题出在一句话上。有 10 个功能点直接把这句原文暴露给了用户:
"No capability, route or permission has been verified for this feature."
这 10 个功能点,无一例外,全部被评为「过于技术化」。10/10。
这不是产品文案,这是调试器在客户面前进行存在主义危机。
另一个功能点的证据链堪称优秀——POST 端点、创建权限、提交通路、按钮,全部齐备——但确定性渲染器 proudly 输出了这样一句话:
"You can create a new invoices create form and submit the invoices create form form…"
技术上无懈可击,语言学上已经死亡。
这里暴露的是渲染器(Renderer)与内部诊断信息的边界问题。在验证驱动的管道中,系统内部需要区分三种状态:能力已验证、能力未验证、能力被明确否定。当某个功能点落在"未验证"状态时,系统内部会产生一条诊断记录,用于后续回溯和调试。
问题在于,某些渲染路径没有为"未验证"这一内部状态准备面向用户的替代文案,于是直接把诊断记录的原文当作文案输出。从工程角度看这是合理的——字段有值、格式合法、逻辑一致;从产品角度看这是灾难,因为用户看到的不是"这项功能暂未确认,建议联系管理员"这类可读指引,而是一句指向系统内部的元描述。这说明验证层与呈现层之间缺少一层转换逻辑,而这一层正是后文 Guidance Compiler 要填补的。
架构新增一层:从「知道什么」到「该说什么」
这两个案例指向同一个边界。团队此前已经把「应用实际做什么」和「模型以为它做什么」分开了。现在需要再分一层:「我们知道什么」和「人类真正需要听到什么」。
于是架构增加了一个新层:
Product Model        →  我们知道什么?
Guidance Compiler    →  什么值得告诉用户?   ← 新增
Renderer             →  应该怎么说?
验证规则没有放松,模型的权限也没有扩大。团队只是终于承认了一件对软件开发者来说显而易见的事:技术上正确的数据结构,并不会自动知道该怎么和人类说话。
这一层 Guidance Compiler 的职责,是把经过验证的产品事实,翻译成用户能够理解和使用的指引,同时在翻译过程中不引入任何新的、未经证实的声明。这是整个系列里一个关键的架构转折。
Guidance Compiler 的定位介于知识表示与自然语言生成之间。它接收的是经过验证的结构化产品事实(例如某个按钮存在、某个权限已确认、某条通路可提交),输出的是面向用户的可执行指引。它必须在两个约束下工作:一是不引入任何新的、未经证实的声明,二是把技术性的字段语义翻译成用户能理解的动作与后果描述。
这与传统的模板渲染不同。模板渲染关心的是如何把字段填进固定句式;Guidance Compiler 关心的是在当前事实集合下,对用户而言什么信息最值得说、以什么粒度说、是否需要省略。它类似于把数据库 schema 转换为自然语言说明,但增加了"选择性表达"和"避免技术暴露"这两个产品约束。架构上多出这一层,意味着系统承认:验证的完备性与表达的可用性之间需要显式的转换步骤,而不是靠渲染器顺带完成。
值得关注的三个判断
安全与有用是两条独立的轴。 一个系统可以同时做到「零错误声明」和「几乎全部平庸」,这两件事之间没有自动的转换关系。把验证做到满分,不代表用户体验会自然改善。
评分方式本身需要被质疑。 用另一个模型来评判被测模型的输出,只能排除自评偏差,不能替代真人评估。24% 这个数字有多大参考价值,取决于评分标准的设计,团队对此保持了清醒。
问题可能出在呈现层,而不是能力层。 第一轮实验里能力信号几乎不可见,修掉语言问题后信号就清晰了。这意味着早期实验很容易把「表达糟糕」误判为「能力不足」,做产品判断时需要格外小心。
Statewave Guide 构建在 Statewave 之上——一个开源、可自托管的 AI agent 记忆运行时,关注治理与来源追溯,而非仅仅检索,采用 Apache 2.0 许可。项目下一步要回答的问题是:能否在不编造任何新内容的前提下,把经过验证的产品事实转化为对人有用的指引?
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。