Android ML Kit 端侧AI:性能优化与质量突破

Google详解端侧AI四大优势、Gemini Nano优化与ML Kit新能力及诈骗检测实战。
文章基于Google Android AI Core产品负责人David Cho的技术演讲,系统阐述端侧AI的四大优势:相比云端约2倍速度、百万次推理可省数十万美元、离线可用(62%开发者看重)与隐私保护(72%开发者看重)。ML Kit通过封装模型下载、运行时配置等复杂性降低集成门槛,AI Core已覆盖1.75亿台设备。Gemini Nano通过2位量化、共享KV缓存、惰性加载编码器和NPU时钟缩放降低内存,并借助前缀缓存和投机解码提速。2B模型在MMLU Pro上媲美去年27B模型。新增语音翻译、嵌入、文本转语音和函数调用能力,并以跨境包裹诈骗检测案例展示端到端串联,全部在设备端完成。
为什么选择端侧AI:四大核心优势
在云端AI能力飞速发展的今天,为什么还要把AI推理放在设备端?Google Android AI Core产品负责人David Cho在技术演讲中给出了四个关键理由:速度、成本、可用性和隐私。
速度方面,端侧推理无需在用户设备与云端之间来回传输数据。据其测试,许多场景下端侧AI比云端运行快2倍。成本方面,假设每天运行百万次推理,在用户设备上运行相比云端可节省数十万美元。可用性上,一项开发者调查显示,62%的开发者将离线可用性列为使用端侧AI的前三大原因——无论用户身处万米高空还是东京地铁地下层,都能使用AI能力。隐私则是另一个关键驱动力:72%的开发者将其列入前三大原因,40%将其列为第一大原因。用户的短信、语音笔记、照片乃至财务医疗信息,都更希望留在本地处理。
ML Kit:让端侧AI触手可及
据David Cho介绍,ML Kit的设计目标是极大简化端侧AI的集成难度。开发者只需接入ML Kit API,背后的复杂性——输入输出安全信号管理、模型与权重下载、运行时配置——全部由AI Core处理。
目前,AI Core已覆盖1.75亿台设备,并预计在未来一年显著扩展至数亿台新设备。生态方面,已有9个下载量超千万的第三方应用采用了这些生成式AI能力,AI生产功能的应用启动量季度环比增长110%。
Gemini Nano 的四大底层优化
为了让端侧模型更高效,Google对Gemini Nano进行了多项深度优化,显著降低了运行内存需求。David Cho列举了四项核心改进:
- 2位量化替代4位量化:位数减半意味着需要流经模型的数据量减半。
- 共享KV缓存:模型前20层共享KV缓存,使整个包体积大幅缩小,同时仍能支持16K token的上下文长度。
- 惰性加载视觉与音频编码器:对于大量纯文本用例,无需一开始就加载这些编码器,从而节省内存。
- NPU时钟缩放:让NPU按需运行以节省功耗,同时保证高质量输出。
在速度优化上,前缀缓存(prefix caching)让系统提示词无需反复处理,示例中节省了60%的token输入,对应60%的速度提升。投机解码(speculative decoding)则通过一个远小于Gemini Nano的草稿模型快速生成多个token,再由Gemini Nano验证,内部用例平均实现2倍加速。
量化(Quantization) 是压缩神经网络模型的核心技术:将模型权重和激活值从高精度浮点数(如16位或32位)映射到低精度整数表示,从而减少存储占用和内存带宽需求。常见方案包括训练后量化(PTQ)和量化感知训练(QAT)。位数越低,模型越小、推理越快,但精度损失风险也越大。2位量化属于极低比特量化,通常需要特殊的缩放因子、分组策略或混合精度处理来维持可用质量;相比4位量化,其理论内存占用和传输量减半,这正是文中“数据量减半”表述的技术背景。
KV缓存(Key-Value Cache) 是Transformer自回归推理中的关键优化:生成每个新token时,模型需要重新计算此前所有token的注意力键值对;缓存这些结果可避免重复计算,显著加速长上下文生成。但KV缓存随上下文长度线性增长,占用大量内存。共享KV缓存(即多个层复用同一份键值表示)是一种以少量质量损失换取大幅内存节省的架构级折衷,使小模型也能支持16K token的长上下文。
前缀缓存(Prefix Caching) 针对的是推理中反复出现的系统提示词。在对话或智能体应用中,系统指令、角色设定和示例往往在每次请求中完全相同;若每次都重新编码这些前缀token,会造成大量冗余计算。前缀缓存将已处理前缀的KV状态保存下来,后续请求直接复用,从而跳过重复的预填充阶段。文中“节省60%的token输入”即指这部分前缀token不再需要重新计算,对应约60%的延迟下降。
投机解码(Speculative Decoding) 是一种加速自回归生成的推理技术:用一个参数量远小于主模型(此处为Gemini Nano)的草稿模型(draft model)快速连续生成多个候选token,再由主模型一次性并行验证这些token是否可接受。若草稿模型的预测与主模型一致,则多个token被一次性确认,突破逐token串行生成的瓶颈;若不一致,则回退到主模型重新生成。该方法在输出分布上保持与主模型一致(无损),实际加速比取决于草稿模型的接受率,文中内部用例平均达到2倍。
质量跃升:2B模型媲美去年27B
一个令人印象深刻的进展是模型质量的提升。David Cho宣布,这个2B参数模型在多个基准上已能与去年的27B模型同台竞技。在标准知识基准MMLU Pro上,2B模型几乎与去年的27B模型持平;在研究生科学推理和智能体工具使用基准上,2B模型甚至表现更好,尽管其规模不到去年模型的十分之一。
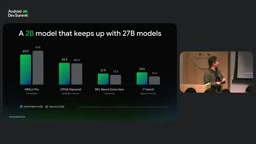
David Cho表示,这一趋势预计将持续,团队正与GDM团队紧密合作,持续改进模型。
能力扩展:从语音翻译到函数调用
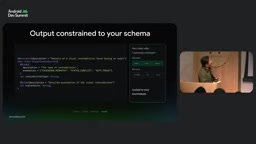
ML Kit近期新增了四项关键能力:语音翻译(支持超过20种语言转写)、嵌入(支持按语义而非关键词搜索应用内容)、文本转语音(提供接近人声的语音)以及函数调用(让应用代表用户执行操作)。此外,系统指令、多图输入、思考模式和结构化输出等能力也已就绪。其中结构化输出允许开发者注解Kotlin类,直接返回符合schema的对象。
嵌入(Embedding) 是将文本、图像或音频映射为高维稠密向量的表示方法,语义相近的内容在向量空间中距离更近。多模态嵌入把不同模态映射到同一语义空间,使得“镜头订单邮件”和“镜头产品图片”即使没有共享词汇也能被比较。检索时通常用余弦相似度衡量向量夹角,文中阈值0.68即判定“足够相似”的边界。嵌入是语义搜索、推荐、聚类和检索增强生成(RAG)的基础设施。
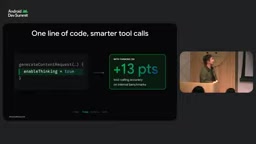
函数调用(Function Calling) 让大模型不直接执行代码,而是输出结构化的调用意图(函数名与参数),由宿主应用决定是否执行并回传结果。这种“模型提议、应用执行”的分工是端侧隐私与安全的关键:模型只负责理解与决策,敏感数据操作留在应用可控的代码中。配合思考模式(Thinking Mode)——即让模型在给出最终答案前生成中间推理步骤——可显著提升复杂工具选择与参数填充的准确性,文中13个百分点的提升即源于此。
端到端实战:跨境包裹诈骗检测
David Cho用一个完整案例展示了如何串联所有API。场景是一位美国摄影师在日本旅行时收到声称需支付6800日元清关费的语音邮件和短信,希望判断是否为诈骗,同时要求信息私密、可解释且支持无障碍访问。
整个流程分为四个阶段:
信息摄取:使用语音翻译API将日语语音邮件转写并翻译,同时用语音识别API处理用户的提问。两者共享同一个经过100多种语言训练的音频编码器。
分诊:通过Prompt API和函数调用,配合系统指令(如“安全审计员”角色)和思考模式,判断需要检索哪些信息。David Cho特别强调,在函数调用时使用思考模式可在100分制下带来13个百分点的准确率提升。
检索:使用多模态嵌入和App Search。在用户下单镜头时,将订单邮件和图片索引为嵌入向量;当需要验证时,用余弦相似度检索,阈值设为0.68。多模态嵌入的价值在于,即使图片和文本没有共享词汇,也能映射到同一语义空间。补充一点,Gemini Nano并不执行任何代码,它只负责提问,实际检索由应用代码完成,从而确保隐私与安全。
审计与反馈:再次生成嵌入向量,比较检索到的订单信息与来电信息,使用Prompt API、结构化输出和语音合成给出判定。输出类中定义了视觉矛盾类型(如关税欺诈、包装不符、状态冲突)和解释字段。最终生成诈骗判定、欺诈风险评分(0-100)、节省金额和矛盾列表。最后通过文本转语音朗读结果,在多数设备上生成响应耗时不到120毫秒,并提供平台API作为后备方案。
端侧AI的规模化前景
这个案例完整展示了端侧AI在速度、成本、可用性和隐私上的综合优势。David Cho表示,这些能力在过去大约六个月内陆续推出,开发者可通过官方文档获取详细信息。随着设备覆盖的扩大和模型效率的持续提升,端侧AI正从概念验证走向大规模生产部署。
相关推荐
Cursor AI实战:用AI IDE加速编程的效率与成本权衡
深入解析 Cursor AI IDE 的界面布局、Agent/Plan/Debug/Ask 四种模式、模型选择与 Git 上下文集成,并结合实操演示讨论其订阅成本与直连 Claude 的性价比权衡。
免费落地页设计规则库:Claude Code与Cursor实测指南
Claude Code 与 Cursor 可用的免费落地页设计技能 Landing Page Design 介绍:MIT 协议、近 9000 星,先问 offer/受众/行动再规划 12 区块,字体与间距均为硬约束,配套 Redesign 技能改造存量页面,附动效技能下架与星数不代表质量的提醒。
Cursor总写错代码?问题可能出在上下文而非提示词
Cursor反复写错代码,问题可能不在提示词而在上下文。本文解析如何通过补充相关文件、完整报错与预期结果,配合先计划、小步改、跑测试的流程,减少AI编程错误,同时提醒代码审查仍是开发者的责任。