Anima:用自然语言生成交互式生物模型的开源工具

Anima 是开源项目,用自然语言描述自动生成可交互的生物学模型。
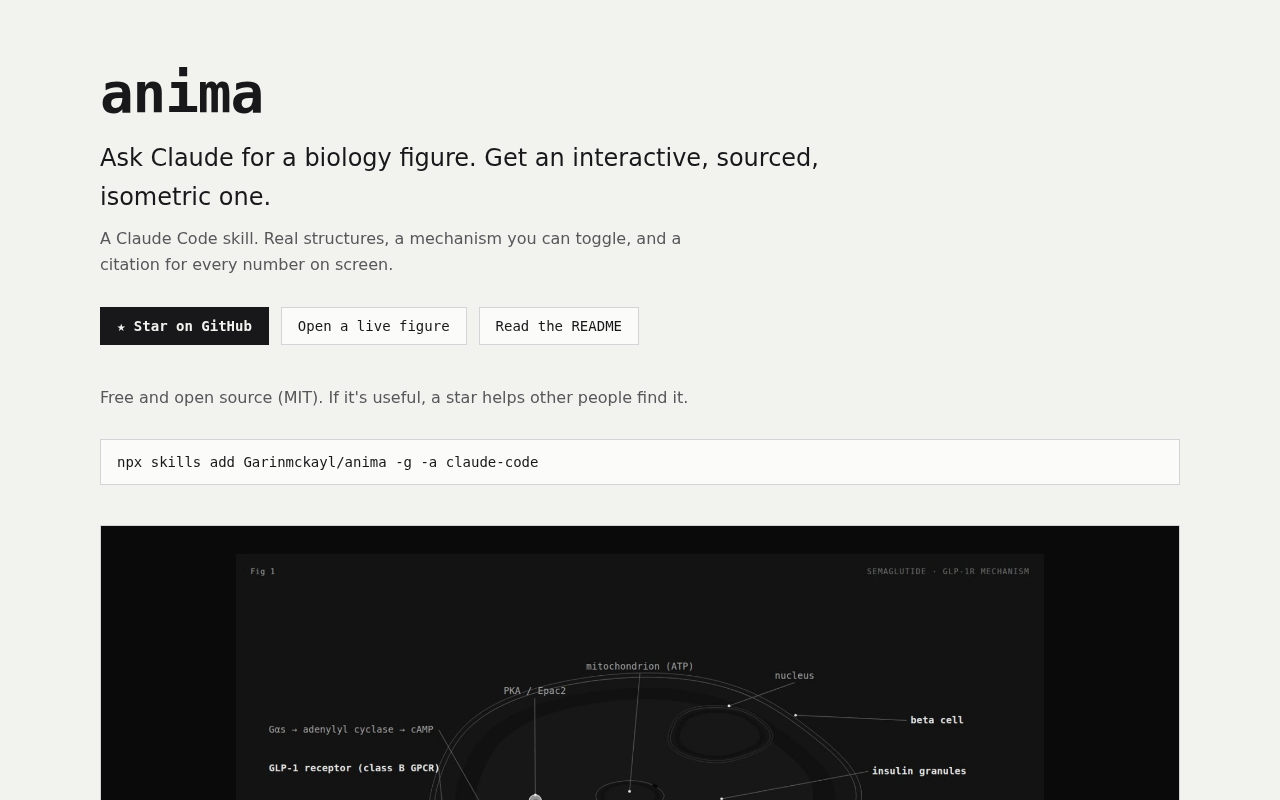
Anima 是一个在 Hacker News 上展示的开源项目,它尝试将日常英语描述的生物学过程自动转化为可交互的仿真模型。传统上,构建基因调控网络或代谢通路模型需要掌握 SBML 等专门语言或 COPASI、VCell 等工具,对湿实验背景的研究者构成门槛,而 Anima 试图把建模入口拉低到自然语言层面。该项目瞄准快速原型和教学场景,交互式模型有助于传达负反馈、振荡等动态行为。开源策略有助于积累信任和社区贡献。然而,项目在 Hacker News 上热度有限(4 points, 0 comments),处于早期阶段。其核心挑战在于自然语言歧义性与模型精确性之间的平衡,语义解析的准确性和对生物学术语的覆盖度将决定它能否从演示走向实用。
在Hacker News的“Show HN”板块,一个名为Anima的开源项目引起了关注:它试图让用户用日常英语(plain English)来描述生物过程,然后自动生成可交互的生物学模型。对于生物信息学、计算生物学以及教育科技领域的开发者来说,这或许是一个值得留意的信号。
它解决的是什么问题?
传统上,构建一个生物学模型——无论是基因调控网络、代谢通路还是细胞信号传导——需要掌握专门的建模语言(如SBML)或仿真工具(如COPASI、VCell)。这对湿实验背景的研究者构成了技术门槛。Anima的思路是把“建模”的入口拉低到自然语言层面:你写一段关于某个生物机制的描述,工具尝试将其解析为结构化的模型,并生成可交互的界面。
从“plain English”这个定位看,它瞄准的是快速原型和教学场景,而非替代严谨的定量建模平台。
SBML(Systems Biology Markup Language) 是一种基于 XML 的标准化交换格式,用于描述生化反应网络,包括物种、反应、参数和数学表达式。它由 SBML 社区维护,目前已被数百个建模与仿真工具所支持,是目前系统生物学领域事实上的通用语言。SBML 的核心价值在于互操作性:同一个模型文件可以在 COPASI、VCell、BioModels 数据库等不同平台之间自由流转。不过,SBML 本身只描述模型结构和数学关系,并不直接包含仿真算法,用户通常还需要搭配专门的求解器。
COPASI 是一款开源、跨平台的生化系统仿真工具,支持确定性 ODE 求解、随机仿真、稳态分析和参数扫描等。它提供了图形化界面,研究者无需编程即可构建和运行模型,也支持 Python 脚本调用。VCell 则更侧重于空间建模和细胞级仿真,能够处理反应-扩散系统以及细胞几何结构。两者都要求用户理解建模语言的语法,这正是 Anima 试图降低的门槛。
交互式模型意味着什么
“Interactive”这个词在Anima的语境里很关键。生物学模型如果只是静态图片或公式,很难传达动态行为——比如负反馈回路如何维持稳态、振荡器在什么参数下失稳。交互式模型允许用户调整参数、观察系统响应,这更接近“计算思维”在生物教育中想要培养的能力。
如果Anima能稳定地把一段文字转换为可调参数的仿真模型,它在课堂演示、假设检验、甚至论文的补充材料中都有用武之地。
负反馈回路是生物系统中维持稳态的核心机制之一:当系统输出偏离设定值时,反馈机制会抑制偏离,使系统回到动态平衡。在建模中,负反馈通常表现为一组带抑制项的微分方程,其稳态和收敛速度取决于参数取值。振荡器(如昼夜节律、细胞周期)则通常需要负反馈加上时滞或非线性项,在特定参数区间内产生周期性行为;一旦参数越界,振荡可能失稳或消失。这些动态行为很难用静态公式直观传达,交互式模型能让用户通过拖动参数滑块实时观察系统的响应变化,从而更直观地理解“参数-行为”之间的关系。
开源带来的可能性
选择开源是这类工具积累信任的务实做法。生物学建模涉及大量领域特定的假设,闭源黑盒很难让研究者放心。开源允许社区审查解析逻辑、贡献模型模板、适配新的生物系统。
不过,当前该项目在Hacker News上的热度有限(4 points, 0 comments),意味着它尚处于早期阶段。对于一个“从自然语言到可执行模型”的工具,最大的挑战往往不在于界面,而在于语义解析的准确性和对生物学术语的覆盖度。自然语言的模糊性与模型所需的精确性之间存在天然张力,Anima如何处理歧义、是否提供人工校正环节,决定了它能否从演示走向实用。
语义解析在这里指的是将自然语言描述映射为结构化的模型元素——识别出基因、蛋白质、反应、调控关系、参数(如速率常数、浓度)以及它们之间的因果和数学关系。生物学术语的同义词、缩写和上下文依赖使这一任务尤为困难:例如“表达”可能指基因转录或蛋白质翻译,“抑制”可能对应竞争性结合或变构调节。LLM 在通用语言理解上表现出色,但在精确的领域语义和数值约束上容易产生“合理但错误”的输出。因此,可行的方案通常是在 LLM 解析之后加入校验层,或者提供人工校正界面,让领域专家确认关键建模假设后再生成仿真代码。
值得关注的方向
对于AI应用于科学建模这一赛道,Anima代表了一种趋势:用大语言模型的语义理解能力充当“建模助手”。它能否成功,取决于一个朴素的问题——生物学家愿不愿意用文字描述来代替直接操作建模工具。这个问题的答案,可能需要等社区给出更多反馈后才能浮现。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。