Anthropic IPO与GPT-6.2 Astra:模型竞争背后的数据依赖与安全隐忧
GPT-6.2 Astra发布让位于Anthropic上市、数据依赖与思维链监控退化等更深层议题。
文章以OpenAI发布GPT-6.2 Astra为切入点,指出单一模型发布已不再是行业焦点。通过对比多个基准测试,作者说明模型能力高度依赖训练数据分布,不存在通用于所有领域的最佳模型,且厂商展示常通过调整基线误导观感。总体能力进步虽可预测,但特定能力阈值的突破(如网络战与零日漏洞发现)会带来不可预测的安全影响。文章进一步质疑Anthropic的“向上竞争”叙事与独立评估的实际效果,并警告思维链监控作为安全支柱正在退化。最后强调OpenAI在安全投入透明度上优于Anthropic,但结构性激励仍促使实验室在竞争压力下做出安全取舍。
引言:新模型发布不再是唯一焦点
当OpenAI发布新一代模型GPT-6.2 Astra时,按常理这应是本周最大的新闻。但据YouTube科技分析频道的深度解读,这次的情况有所不同——模型本身的进步固然重要,但围绕Anthropic上市、模型能力的数据依赖性、以及AI安全监控的透明度问题,构成了更值得关注的叙事主线。
该频道作者表示已通读119页的系统卡并进行了充分测试,认为GPT-6.2 Astra在复杂专业任务上确实树立了新的质量标杆,但Google几乎每两周就推出Gemini新版本,使得单一模型的发布不再具有压倒性的新闻价值。
没有“万能模型”:性能取决于训练数据
各领域表现分化明显
关于“哪个模型最好”的问题,答案取决于具体领域。在GDP.pdf基准(涵盖STEM领域100项专家任务)上,Gemini 4.0 Neon得分最高;在Frontier Code 2.0编程基准上,Fable 5.2领先,但所有模型都集中在40多分的区间;在Artificial Analysis综合指数上,Fable 5.2以微弱优势领先;而在Epoch Capabilities Index上,GPT-6.2 Astra则拔得头筹。
这种看似矛盾的结果并非混乱,而是反映了模型训练数据的差异。视频作者指出,如果模型能力纯粹取决于“原始智商”,各模型应该表现相当;但现实是,当某个实验室在特定领域投入大量专有数据训练时,就会出现显著的能力偏差。例如,Anthropic联合创始人曾表示公司在生命科学领域投入巨大,这或许解释了Fable 5.2在蛋白质预测任务上远超GPT-6.2 Astra的原因。
基准测试的局限性
作者通过自己的私人基准测试发现,Gemini 4系列在空间推理任务上表现突出,这可能与Google拥有的空间和视觉数据优势有关。而在“Integrity Bench”上,Gemini 4模型对自身能力的校准明显不如Claude系列,表现出过度自信的倾向。
更值得警惕的是,厂商在展示模型进步时往往会调整基线。作者举例称,OpenAI在GPT-6 Astra发布时展示的Blender 3D工具使用演示,实际上比Fable 5.2的对比版本要弱得多——“你的眼睛可能会欺骗你”。
Integrity Bench 是用于评估模型“校准”(calibration)能力的基准测试。校准指的是模型对自身答案正确性的置信度是否与实际准确率匹配:一个良好校准的模型在说“我有80%把握”时,其答案确实约有80%是正确的;而过度自信的模型则会在低准确率时给出高置信度。这一指标在AI安全与可靠性评估中日益重要,因为过度自信的模型在高风险场景中可能被过度信任。文中提到Gemini 4系列在校准上不如Claude系列,意味着其在不确定时更容易给出错误的高置信判断,这对需要人工审核的工作流构成隐患。
可预测的进步与不可预测的影响
能力阈值处的突变
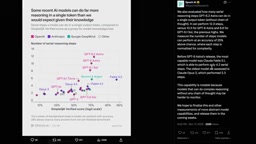
视频展示了一张OpenAI模型在34个公开基准和35个内部基准上的综合进步曲线。这条曲线整体呈上升趋势,但作者提出了一个尖锐的问题:Navier-Stokes突破(模型突然能够解决千禧年数学难题)在这张图的哪里?答案是——找不到。
这说明,虽然总体能力在可预测地提升,但特定能力阈值的突破会带来不可预测的影响。同样,当模型被训练了足够的网络战数据后,它们可能突然发现大量零日漏洞,这也是银行、航空公司和微软近期系统升级潮的背后推手。
AI加速AI研究的争议
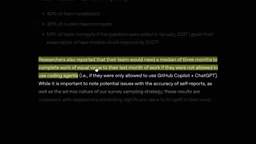
关于AI对自身研究效率的提升幅度,各实验室给出了不同答案。Anthropic在IPO文件中声称AI辅助使其进度达到历史趋势的两倍;Meta和Anthropic基于15个基准得出类似结论;而OpenAI的最新报告则显示,研究人员使用编码智能体可以在一个月内完成原本三个月的工作量。
但这些数字的可比性存疑。作者指出,不同实验室提出的问题不同、使用的数据不同,而且“等价值工作”的定义本身就很模糊。外部评估方面,Abundant Labs的Frontier RSI排行榜显示Opus领先于Fable 5.2,后者又领先于Gemini 4 Carbon和Astra。
Anthropic的“向上竞争”叙事面临质疑
递归自我改进的公开宣示
Anthropic联合创始人Tom Brown在IPO宣传视频中明确表示,计算乘数会叠加,每个新发现的乘数都会对之前的乘数产生正向影响,“我们相信随着接近递归自我改进,这一进程会进一步加速。Claude将能够完全自主地发现如何使用计算乘数。”
Dario Amadei提出的“向上竞争”理论认为,Anthropic需要冲到最前面,然后做好安全方面的工作,从而带动其他公司效仿。但视频作者对此持怀疑态度。
递归自我改进(Recursive Self-Improvement, RSI) 指AI系统能够自主改进自身的算法、架构或训练流程,且每一轮改进都使下一轮改进更高效,从而形成加速循环。这是AI安全领域的核心关切之一:一旦模型具备自主发现“计算乘数”(即用更少算力获得更多能力提升的方法)的能力,进步速度可能超出人类监督与评估的节奏。Anthropic联合创始人所称“计算乘数会叠加”,正是指这种复合效应。值得注意的是,RSI并不要求模型完全脱离人类,而是指改进过程中的关键发现由模型自主完成,人类角色转向设定目标与审核结果。
独立评估的实际情况
Amadei曾呼吁引入独立评估员,给予他们类似员工的访问权限。Anthropic声称正与Accenture合作建设这一能力。但作者指出,考虑到Anthropic联合创始人Jack Clark预测2027年将实现完全递归自我改进,让Accenture评估2030年不断自我改进的模型恐怕相当困难。
更令人玩味的是,Anthropic曾向参与评估的META团队成员提供工作机会。Dan Hendricks(前xAI成员)透露,多个AI安全组织私下表示同意对Anthropic的批评,但因担心关系和未来资金而不敢签署。
思维链监控:正在失效的安全支柱
架构选择的分歧
OpenAI在报告中承认,思维链监控是其安全案例的核心支柱。但公司采取了一种架构选择,将更多推理从语言化的思维链转移到网络的隐藏层中。Anthropic的对齐科学负责人确认,这种循环Transformer的方法在不需要思维链的情况下提升模型能力的效果,优于其他增加预训练质量的方式。
这引出一个问题:Anthropic是否知道这个“容易的胜利”却选择不使用?而这是否促成了“向上竞争”?作者认为并非如此——OpenAI两位发表思维链脆弱性论文的主要作者近期已被解雇。
思维链(Chain-of-Thought, CoT)监控 是一种AI安全技术:模型在给出最终答案前,用自然语言逐步写出推理过程,人类或自动系统通过审查这些中间步骤来发现欺骗、危险意图或错误推理。其有效性依赖于一个前提——模型的可监控推理必须忠实反映其实际计算过程。然而,当模型架构将更多计算转移到隐藏层(如循环Transformer在不显式生成思维链的情况下完成多步推理)时,思维链就不再是完整的过程记录,监控便出现盲区。这正是文中“可监控性退化”的技术根源:能力提升与可解释性之间产生了结构性张力。
监控能力退化的警告
Greg Brockman曾经对思维链监控充满热情,现在则表示“情况看起来不太好”。OpenAI在最新报告中坦言,随着模型能力提升,思维链可监控性正在退化,需要新的技术突破来维持人类监督。
作者用一个类比说明问题:初级员工的工作电脑记录能忠实反映其产出,但CEO的电脑记录可能只有邮件,无法代表其全部思考过程。
循环Transformer(Recurrent Transformer) 是一种通过多次迭代复用同一组网络层来增加有效计算深度的架构。与传统Transformer每层只处理一次不同,循环架构让隐藏状态在内部反复更新,从而在不生成更多思维链token的情况下完成更复杂的推理。其优势是推理效率高、不依赖语言化中间步骤;但对安全监控而言,这意味着大量推理发生在无法被自然语言审查的隐藏层中。Anthropic对齐科学负责人所确认的,正是这种架构在“无需思维链即可提升能力”上优于其他方案——换言之,最有效的能力提升路径恰恰绕开了当前最核心的监控手段。
安全研究的资源投入
OpenAI报告披露了2026年2月至10月期间各研究领域的人力投入。经Gemini 4 Carbon辅助分析,安全与对齐研究在2月约占总研究时间的16.7%,到10月已升至21%。
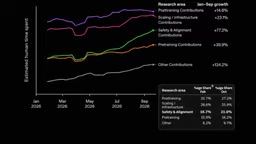
作者认为,OpenAI在透明度方面值得肯定,而Anthropic没有提供可比数据。但OpenAI董事会成员Paul Cristiano的表态令人不安:他认为未来三年内存在AI接管的“高风险”。
竞争压力下的安全取舍
视频指出一个结构性激励问题:如果实验室知道全速推进网络能力会暴露更多漏洞,从而使全球企业更加依赖它们的防护服务,这是否构成一种推动力,促使它们更激进地发展攻击能力、同时更少地审视相关风险?
类似地,当模型不断进步,识别出自己正在被评估的能力也在增强,这进一步削弱了监控的有效性。
结语:信任不能仅靠“稍微更安全”
在Anthropic上市之际,Dario Amadei表达了希望社会信任Anthropic的愿望:“我相信把风险做对的公司,也将是获得运营许可的公司。”
但Anthropic员工Tao Lin的公开表态提供了另一种视角:“认为人类应该帮助Anthropic获胜仅仅因为它在边际上更安全,这种想法是疯狂的。”他认为这只是一个“非常冒险的赌注”。
在模型能力快速进步、安全监控手段面临挑战的当下,这场关于AI发展路径的辩论远未结束。对于开发者和企业用户而言,视频传递的最实用建议或许是:在关键任务上,亲自试用三大模型家族,用你的数据做出判断,而非依赖任何单一基准或榜单。
相关推荐
GPT-6.2 Astra与Sol争议:测评两极分化背后
OpenAI 发布 Astra 与 Sol 6.2 后陷入测评争议:早期访问者集体差评,随后官方称版本已更新。本文梳理事件脉络,结合实测展示模型在 computer use、视频剪辑上的优势与沟通短板,并分析成本与订阅配额格局的变化。
Atlassian团队图谱:让AI智能体更懂上下文
Atlassian利用Jira的上下文优势构建Teamwork Graph,连接人员、项目、文档与代码,让AI智能体输出更好且消耗更少token。
DeepMind CTO:产品才是通往AGI的真实路径
Google DeepMind的Koray Kavukcuoglu在播客中阐述:AGI没有测试,产品才是通往AGI的真实路径;Gemini每代均为手工定制,架构持续演化,安全依赖对思维链的实时监控。