Anthropic"Mythos"安全狂潮为何归于沉寂?Glasswing项目复盘

Anthropic的Mythos漏洞发现能力宣传在半年后面临"雷声大雨点小"的质疑,同时引发安全合作背后数据流向的隐忧。
Anthropic曾高调宣称其Mythos模型的漏洞发现能力"强到不敢公开",并以"Project Glasswing"的形式向精选企业提供闭源代码审计服务。然而近六个月后,预言中的漏洞大爆发并未出现,被披露的漏洞多集中于冷门功能,Linux内核中出现的少量AI辅助LPE漏洞也并非Mythos独家成果。社区对此提出了两层质疑:一是实际安全贡献是否匹配宣传声势;二是Glasswing合作是否实质上为Anthropic提供了获取稀缺闭源代码训练数据的通道。文章指出,"太危险不能公开"是AI公司惯用的叙事框架,在缺乏第三方独立核实的前提下,更接近品牌营销而非技术事实,观察者应以公开、可复现的证据作为判断依据。
一场高调预警后的沉默
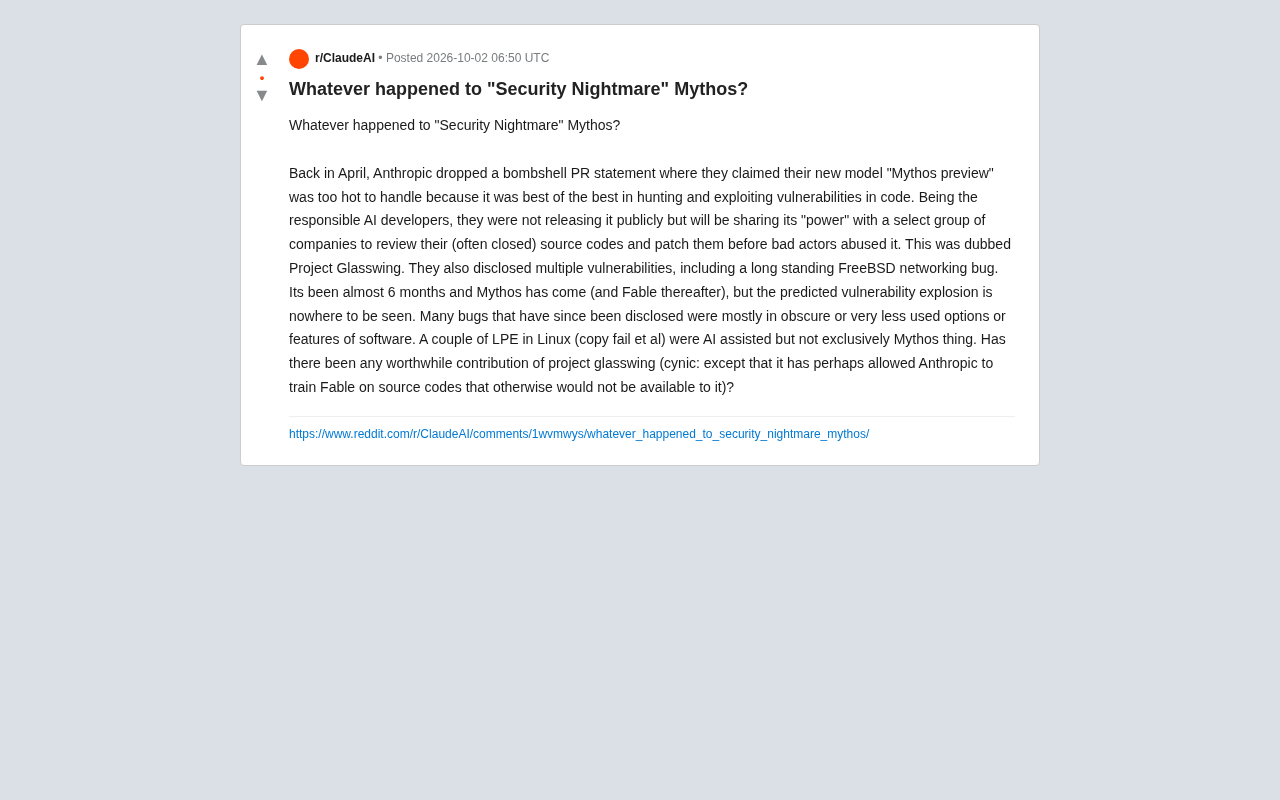
几个月前,Anthropic抛出了一份颇具震撼力的公关声明:他们的新模型"Mythos preview"在挖掘和利用代码漏洞方面表现过于强大,以至于"烫手到无法公开发布"。作为一家强调责任的AI公司,Anthropic选择不对外开放这一能力,而是将其"威力"分享给一小部分精选企业,帮助它们在恶意行为者滥用之前,审查(通常是闭源的)源代码并修补漏洞。这个计划被命名为"Project Glasswing"(玻璃翼计划)。
在宣传中,Anthropic还披露了多个漏洞,其中包括一个长期存在的FreeBSD网络栈缺陷。这种"模型强到不敢放出来"的叙事,在当时引发了关于AI驱动漏洞发现是否会颠覆网络安全格局的广泛讨论。
预言中的"漏洞爆炸"并未到来
一位Reddit用户近期提出了一个尖锐的问题:将近六个月过去,Mythos已经发布(之后又有了后续模型"Fable"),但当初预言的"漏洞大爆发"却始终没有出现。
从这位发帖者的观察来看,期间被披露的漏洞大多集中在软件中冷门或极少使用的选项与功能上,而非核心、广泛部署的组件。Linux内核中出现的几个本地提权(LPE)漏洞——例如所谓的"copy fail"类问题——确实有AI辅助的成分,但并非Mythos独有的成果,更谈不上是它的"专利"。
这与最初宣传中"最强漏洞猎手"的定位形成了明显落差。如果一个模型真的具备碾压式的漏洞发现能力,那么在半年的实战窗口期里,理应留下更密集、更具冲击力的公开战果。
本地提权漏洞(Local Privilege Escalation,LPE)是指攻击者在已获得系统低权限访问的前提下,利用内核或系统组件的缺陷将权限提升至root或管理员级别的一类漏洞。这类漏洞在Linux内核中历史上有较高发现频率,因为内核代码庞大复杂、长期积累,且内存拷贝路径(如"copy fail"类问题,即copy_to_user/copy_from_user等函数在错误处理时的边界条件缺陷)极为细碎,人工审计效率有限。AI辅助代码审计在这类"高代码量、低语义复杂度"的模式匹配场景中确有一定优势,但LPE漏洞的发现本身并非新鲜事,安全研究员通过模糊测试、静态分析等传统工具也能稳定产出。因此,若要证明某个模型具备"碾压式"能力,仅凭LPE漏洞的数量是不足够的;更有说服力的证据应是在高度复杂的逻辑漏洞或远程代码执行(RCE)层面取得突破。
Glasswing计划的实际价值存疑
帖子中最值得玩味的,是一个带着质疑色彩的推断:Project Glasswing对安全社区究竟贡献了多少实质价值?
发帖者提出了一种偏向怀疑论的解读——这个项目最大的"成果",或许是让Anthropic得以在那些本来无法获取的(闭源)源代码上训练后续模型Fable。换言之,以"负责任地保护企业安全"为名义推进的合作,可能同时为模型厂商打开了一条获取高价值训练数据的通道。
这一视角触及了当前AI安全叙事中一个微妙的利益结构问题:当一家公司既是漏洞发现工具的提供方,又是能从中获取独家数据的模型训练方时,"安全协作"与"数据获取"之间的边界该如何界定?企业在让AI审查自己闭源代码时,是否充分意识到了潜在的数据暴露风险?
在AI与网络安全的交叉地带,"数据飞轮"问题正逐渐成为行业关注焦点。所谓数据飞轮,是指模型提供商通过向外部用户提供服务,将用户输入的高价值数据(如专有代码、内部文档)反哺到下一代模型训练中,从而形成竞争壁垒的循环机制。闭源代码历来是训练数据中最稀缺的资源之一——公开的开源代码虽量大,但无法覆盖企业级软件的独特模式与安全边界。如果合作企业在未明确限制的情况下将内部代码库提交给AI审查,实际上可能在无意间为模型提供商贡献了极高价值的私有训练素材。这一担忧并非针对Anthropic的特定指控,而是整个"AI安全服务"商业模式都需要面对的结构性透明度问题,值得行业在合同条款和数据治理层面建立更清晰的规范。
从营销叙事到现实检验
这起事件提供了一个观察AI能力宣传的典型样本。"模型太强不敢公开"是近年来AI公司常用的一种叙事框架,它既能制造话题热度,又能塑造负责任开发者的形象。但真正检验这类宣称的,是时间和可验证的公开成果。
从目前的情况看,Mythos在漏洞发现上的实际产出,与其登场时的声势之间存在落差。这并不必然意味着其能力造假——AI辅助漏洞发现本身是真实且在进步的技术方向——但它提醒从业者和观察者:对带有强烈营销色彩的能力声明,应保持审慎,以实际披露、可复现的案例作为判断依据。
需要说明的是,上述内容来自单一Reddit讨论帖,反映的是社区用户的个人观察与推断,相关模型名称、项目细节及漏洞归因尚缺乏权威第三方的系统性核实,读者应将其视为提出问题的起点而非定论。
"模型太强不敢公开"这一叙事框架在AI领域有其特定语境,通常与"能力保守发布"(capability gating)或"双重用途风险"(dual-use risk)概念相关联。双重用途问题指某项技术既可用于防御(如帮助企业修补漏洞),也可被攻击者利用(如自动化漏洞利用链的生成),因此是否公开往往需要在收益与风险之间权衡。然而,这一框架本身难以被外部独立核实——声称"能力太危险"的一方同时也是判断危险程度的裁判,存在天然的信息不对称。学界和安全研究机构通常要求通过独立的红队测试(red teaming)和公开的评估基准来佐证此类能力声明,而非仅凭厂商自述。缺乏第三方验证的能力宣传,在客观上更接近品牌定位而非技术事实。
几点值得追问的问题
围绕这类"高调预警、低调交付"的AI安全项目,有几个问题值得持续追踪:
- 可验证的成果在哪里:有多少公开披露的高危漏洞可以明确归因于该模型,而非常规研究或其他AI工具的协同结果?
- 数据流向是否透明:参与企业提交的闭源代码,是否被用于模型训练?合作协议中对此是否有明确约束?
- 能力宣传与现实的差距:"太危险不能公开"的框架,在多大程度上是技术判断,在多大程度上是品牌营销?
在AI能力被反复放大的当下,用公开、可复现的证据去校准宣传,是每一个技术观察者应有的习惯。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。