Anthropic Python SDK v1.9.0发布:引入between_tools思考与Claude Sonnet 5.5
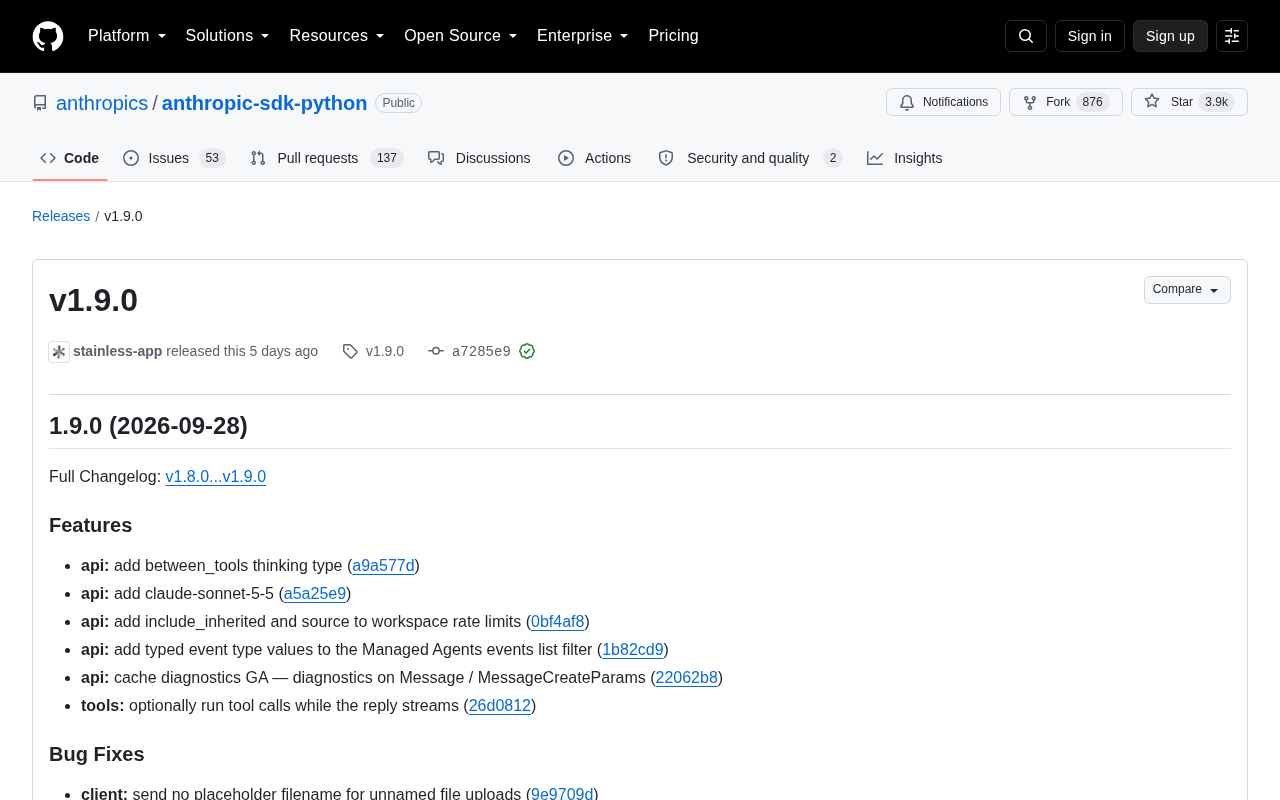
Anthropic Python SDK v1.9.0 增强 Agent 工具链推理能力,并将缓存诊断推向正式可用。
Anthropic Python SDK v1.9.0 聚焦于 Agent 工作流成熟化,带来三项核心升级:新增 `between_tools` 思考类型,让模型能在连续工具调用之间显式推理,提升多步任务决策质量;支持工具调用与回复流式输出并行执行,降低延迟敏感场景的用户等待时间;以及将缓存诊断(cache diagnostics)推向 GA,使开发者能直接从 Message 对象读取缓存命中统计,方便优化成本。此外,本版本新增对 Claude Sonnet 5.5 模型的支持,修复了未命名文件上传、流式解析诊断等多个 Bug,并完善了 Workspace 速率限制 API 和 Managed Agents 的类型化事件过滤器。
Anthropic 官方的 Python SDK 迎来 v1.9.0 版本更新。这次发布在工具调用、模型支持和流式处理等方面带来了多项值得关注的改进,尤其是针对 Agent 工作流和实时推理场景的增强。对于使用 Claude API 构建应用的开发者而言,这次更新提供了更灵活的工具编排能力与更细粒度的诊断信息。
核心新特性
这次版本更新的重点集中在 Agent 能力和模型支持上。
新增 between_tools 思考类型
SDK 引入了 between_tools 思考(thinking)类型,这意味着模型可以在连续的工具调用之间进行推理。在复杂的多步 Agent 任务中,模型通常需要调用多个工具并根据前一步的结果决定下一步动作,between_tools 思考允许模型在工具调用的间隙显式地组织推理过程,从而提升决策质量。
值得关注的是,SDK 同时在 helpers 中加入了降级逻辑:当发生 fallback(回退)时,between_tools 思考会被降级为 disabled 状态,以保证兼容性和稳定性。
between_tools 思考类型属于 Claude 扩展思考(Extended Thinking)能力的一部分。扩展思考让模型在给出最终回复前,先生成一段内部推理"草稿"(thinking block),这段内容对用户可见但不计入对话上下文的指令部分。between_tools 是其在工具调用场景下的具体形式:每次工具返回结果后,模型会先输出一段 thinking block 来分析结果、规划后续步骤,再决定是否继续调用工具或直接回复用户。这与 OpenAI o 系列模型的"链式思考"(chain-of-thought)在外观上类似,但实现机制不同——Claude 的 thinking block 是显式的结构化内容块,可被 SDK 捕获和检查,方便开发者调试推理过程。降级为 disabled 的 fallback 机制则保证了当模型版本或 API 参数不支持扩展思考时,调用不会因此报错,而是静默退化到无 thinking block 的普通模式。
支持 Claude Sonnet 5.5
版本加入了对 claude-sonnet-5-5 模型的支持。对于希望第一时间接入新模型的开发者,升级 SDK 后即可直接调用该模型标识符。同时,SDK 在 Model 类型定义中将已知的模型 ID 优先排列,方便开发者在 IDE 中快速选择。
工具调用可与回复流式输出并行
一项实用的改进是:工具调用现在可以在回复流式传输的同时运行(optionally run tool calls while the reply streams)。这对需要低延迟体验的应用场景意义重大——过去工具执行与内容生成往往是串行的,现在两者可以部分重叠,减少用户感知到的等待时间。
传统的 API 调用生命周期是严格串行的:模型生成完整回复 → 客户端发起工具调用 → 等待工具结果 → 模型再次生成。这在多轮工具编排中会产生明显的累积延迟。并行化的核心思路是:当模型在流式输出过程中确定需要调用某个工具时,客户端可以立即在后台发起工具请求,而无需等待本轮流式内容全部传输完毕。这种"边流边算"的模式在工具调用耗时较长(如搜索、数据库查询)时收益最为显著,可将用户感知的端到端延迟降低一个数量级。需要注意的是,该特性目前是可选的(optionally),开发者需要在代码中主动启用,并妥善处理工具结果与流式内容的合并逻辑,以避免竞态条件。
诊断与流式处理增强
缓存诊断正式可用
本次更新将缓存诊断(cache diagnostics)推向 GA(正式可用),诊断信息现在可以挂载在 Message 与 MessageCreateParams 上。这让开发者能够更清晰地观察缓存命中情况,对优化成本和性能有直接帮助。
相应地,stream() 和 parse() 方法现在也能接受并解析 diagnostics 信息,保证了诊断数据在不同调用方式下的一致性。
Claude API 支持 Prompt Caching(提示词缓存)机制:当请求中存在与之前完全相同的前缀内容时,API 会复用已缓存的 KV(Key-Value)计算结果,从而降低 token 处理费用并缩短首 token 延迟(TTFT)。缓存命中的 token 通常比非缓存 token 便宜约 90%,因此在长系统提示、大型文档问答等场景中有显著的成本优势。缓存诊断(cache diagnostics)提供了每次请求的缓存读写统计,包括 cache_read_input_tokens(命中读取的 token 数)和 cache_creation_input_tokens(本次写入缓存的 token 数),让开发者能量化缓存策略的实际效果,而不必依赖账单数据事后分析。将诊断信息挂载在 Message 对象上,意味着开发者无需额外解析响应头或调用独立接口,直接从消息对象即可读取诊断数据。
速率限制与 Managed Agents 改进
Workspace 速率限制 API 新增了 include_inherited 和 source 字段,让多工作区环境下的限额管理更加透明——开发者可以明确知道某个限额是继承而来还是直接设置的。此外,Managed Agents 的事件列表过滤器增加了类型化的事件类型值(typed event type values),提升了 API 的类型安全性。
重要的 Bug 修复
这次版本也修复了几个影响实际使用的问题:
- 未命名文件上传:客户端在上传未命名文件时不再发送占位文件名,避免了潜在的命名冲突问题。
- 流式与解析中的诊断支持:修复了
stream()和parse()无法接受 diagnostics 的问题。 - beta header 行为调整:parse 和 tool runner 不再发送 beta header,使这些路径的行为更符合预期。
文档与工程细节
除了功能层面,团队在工程规范上也做了不少梳理。文档明确了 stream: true 返回的是原始事件流(raw event stream),并恢复了 Dream 类型上的 research-preview 提示。在代码风格方面,团队在 CLAUDE.md 中补充了字段 docstring 间距规则和函数体间距规则,并在 api.md 中列出了可导入的类型名称。这些改动虽不直接影响运行时行为,但对维护代码质量和开发者体验有长期价值。
CI 配置也进行了调整,现在会根据仓库选择对应的 CI runner。
对开发者的意义
从整体来看,v1.9.0 的更新路线清晰地指向了 Agent 工作流的成熟化。between_tools 思考、工具调用与流式输出并行、Managed Agents 的类型化事件——这些特性共同表明 Anthropic 正在把 Claude 从单纯的对话模型推向更复杂的自主任务执行方向。
对于正在构建 Agent 应用的团队,建议升级到 v1.9.0 并关注以下几点:评估 between_tools 思考能否改善现有多步任务的决策质量;利用缓存诊断 GA 优化调用成本;在延迟敏感场景中尝试工具调用与流式输出的并行能力。完整变更可参考官方 Changelog(v1.8.0...v1.9.0)。
相关推荐

mcp.so 实用指南:一站式发现MCP服务器扩展AI编程能力
mcp.so 是一个发现 MCP 服务器的目录平台,帮助 AI 编程开发者为智能体连接外部工具和服务。本文介绍它的功能、使用方法以及对 AI 工作流的价值。

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。