Anthropic 自研 Scion 替代 Git:日合并量破 3 万

Anthropic 因 AI 编码提速导致合并量暴涨,自研 Scion 替代 Git。
Anthropic 工程团队披露,其核心代码库日均合并量在四个月内从约 2500 次暴涨至 30000 次以上,主分支历史约 100 GB,每天 CI 检出约 2500 万次,Git 基础设施已无法支撑。为此,七人团队耗时五个月自研集中式版本控制系统 Scion,并推出代码审查系统 Antique,在 7 月中旬基本取代原有 Pull Request 流程。Fable 与 Mythos 系列模型的内部启用被认为是编码速度跃升的关键因素。Anthropic 还分享了对抗性审查的实践:模型善于发现漏洞,但缺乏优先级判断,容易针对假设性问题过度设计,需要工程师介入引导。这一案例表明,AI 辅助编码正把软件工程瓶颈从“写代码”转移到“管理代码”。
Anthropic 自研 Scion 替代 Git:日合并量破 3 万
当代码变更量的增速超过工具本身的承载能力时,换工具就成了唯一选择。Anthropic 工程团队在官方博客中披露了其自研版本控制系统 Scion 的完整动机与落地过程——这家公司的核心代码库合并量在六个月内暴涨超过十倍,原有的 Git 基础设施已经无法支撑。
六个月翻十倍:Git 撑不住了
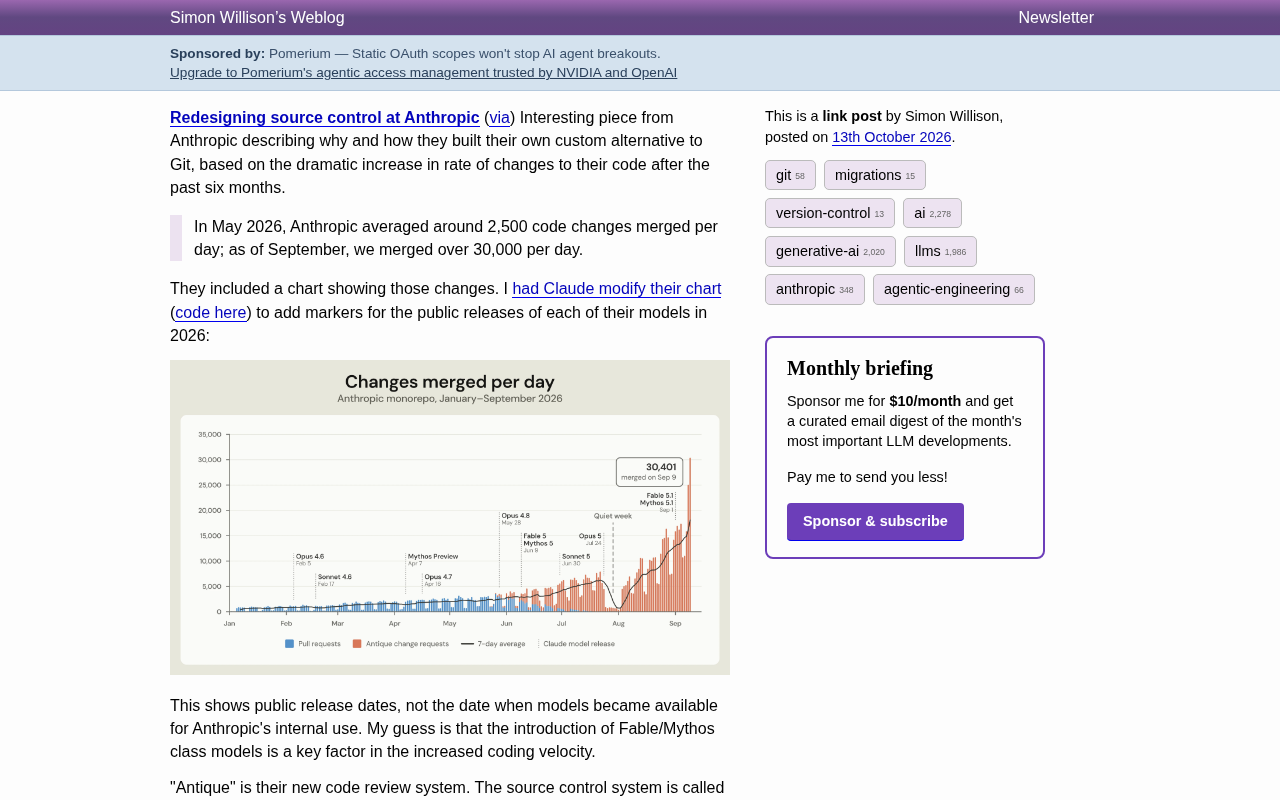
Anthropic 公布的数据相当直接:2026 年 5 月,公司平均每天合并约 2,500 次代码变更;到 9 月,这个数字已经超过 30,000。四个月时间,规模化代码生产的节奏发生了数量级的跃迁。
Simon Willison 在其博客中分析了 Anthropic 公开的合并量曲线图,并将其模型发布时间节点叠加在这张图上。从趋势可见,合并量的三次陡增分别对应 Fable 5 与 Mythos 5(6 月 9 日)、Opus 5(7 月 24 日)以及 Fable 5.1 与 Mythos 5.1(9 月 1 日)的发布。Willison 判断,Fable 与 Mythos 系列模型的内部启用,是编码速度跃升的关键催化因素。
真正把 Git 逼到墙角的还不是合并量本身,而是检出(checkout)的规模。Anthropic 在文中给出了一个令人窒息的数字:主分支历史约 100 GB,压缩后的工作副本超过 25 GB。仅 CI 场景每天就要执行约 2,500 万次代码检出,若不计开发者环境、Agent 沙箱和研究任务,朴素的 fetch 操作每天就会产生超过 600 PB 的 Git 流量。
为什么 Git 会在高频检出场景下成为瓶颈? Git 是分布式版本控制系统(DVCS),其设计核心是每个开发者持有完整仓库副本,操作在本地完成、通过网络同步。这一模型在“人类开发者提交频率有限”的前提下极其高效,但当检出操作从每天数百万次跃升到2500万次时,服务器端需要反复处理克隆、抓取和打包操作,网络带宽与存储IO都承受巨大压力。Git 的 packfile 对象存储虽然压缩效率高,但每次检出仍需解压并重建工作树,尤其是100 GB级别的主分支历史,单次完整克隆就可能消耗数十GB带宽。此外,Git 的引用管理和索引设计偏向于中等规模仓库,面对超大规模历史与超高并发时,缺乏集中式系统那种“只取所需文件、按需缓存”的天然优势。这正是 Anthropic 选择回归集中式架构的根本原因。
Scion 与 Antique:一套完整的替代方案
Anthropic 并非只替换了 Git 本身,而是一次性重构了从版本控制到代码审查的整条链路。
新版本控制系统命名为 Scion,其设计思路被 Simon Willison 描述为"沿着 Subversion 路线的集中式源码控制再发明"——不是分布式模型的改良,而是重新回到集中式架构来解决规模问题。代码审查系统则被命名为 Antique,在 5 月底开始出现在合并数据中,到 7 月中旬已经基本取代了原有的 Pull Request 流程。
整个迁移由一个七人团队完成,从 Git 到 Scion 的切换耗时五个月。对于一个承载着公司全部核心代码、每天数千万次检出操作的系统来说,这个节奏相当激进。
集中式与分布式版本控制的关键区别。 集中式版本控制(如 Subversion、Perforce)依赖单一中央服务器保存所有历史与文件,客户端只取出所需的工作副本,提交和检出都直接与服务器交互。这种方式在超大规模仓库和高频检出场景下优势明显:服务器可以统一优化缓存、按文件粒度传输、精确控制权限和审计,而不需要每个客户端都维护完整历史。分布式版本控制(如 Git)则让每个副本都包含完整历史,离线操作与分支合并非常灵活,但在仓库巨大、并发极高的场景下,同步成本急剧上升。Scion 被描述为“沿着 Subversion 路线的集中式再发明”,意味着它更接近 Perforce 或 Google 内部 Piper 的思路:用集中式存储和智能缓存来支撑海量检出,而非依赖分布式副本的本地操作。
对抗性审查好用,但会跑偏
Anthropic 在文中还透露了一个值得关注的工程实践细节:他们在构建 Scion 的过程中大量使用了对抗性审查(adversarial review),即让模型主动寻找设计方案中的缺陷。
Simon Willison 在博客中印证了类似的个人体验——他最近在自己的项目中尝试让 Claude 和 GPT 互相挑错。这种做法在很多场景下确实极其有效,但 Anthropic 也承认了它的副作用:对抗性审查"在很多方面非常有效,但也可能视野狭窄",导致工程师不得不花精力引导 Claude 不要针对假设性问题过度设计系统的某些部分。
这个观察值得所有在工程流程中引入 AI 审查的团队注意:模型善于发现漏洞,但缺乏对"哪些漏洞值得修"的判断力,人类的判断在回路中仍然不可替代。
对抗性审查(adversarial review)的机制与局限。 对抗性审查指让一个模型或智能体专门扮演“挑错者”角色,主动寻找设计方案、代码或架构中的缺陷、边界情况和潜在失败模式。常见做法是让两个模型互相审查,或让同一模型在已知答案存在漏洞的前提下反向推理。这种方法之所以有效,是因为生成模型在“找问题”模式下往往比“写代码”模式更敏锐,能够发现人类审阅者容易忽略的假设。但它的核心缺陷在于缺乏优先级判断:模型会平等地对待所有潜在问题,包括那些在实际运行中几乎不可能触发的假设性缺陷,从而推动过度设计。Anthropic 工程师需要额外引导 Claude 不要围绕假想问题重构系统,这说明对抗性审查的输出必须经过人类判断过滤,才能转化为有效决策。
这件事真正说明了什么
Anthropic 自研版本控制系统的故事,表面上是基础设施工程案例,实质上反映了一个更宏观的趋势:AI 辅助编码正在把软件工程的瓶颈从"写代码"转移到"管理代码"。
当模型可以以极高速率生成代码变更时,传统的代码审查、版本控制、CI 检出流程都会成为新的约束条件。Anthropic 的应对方式是自建整套工具链,但这对于绝大多数团队来说并不现实。更普遍的问题或许是:现有的开发基础设施,究竟能承载多快的 AI 编码节奏?
软件工程瓶颈的阶段性迁移。 过去二十年,软件工程的主要瓶颈经历了从“写代码”到“集成与交付”再到“可观测性与运维”的多次转移。每一次转移都由工具链的进化驱动:IDE 和高级语言降低了编码门槛,CI/CD 解决了集成效率,云原生与可观测性工具缓解了运维压力。AI 辅助编码正在催生新一轮迁移:当模型能以极高速度生成代码变更时,版本控制、代码审查、CI 检出这些“下游”环节反而成为新的约束。Anthropic 的案例表明,如果这些环节不随之升级,AI 带来的编码加速会被基础设施瓶颈抵消。对多数团队而言,自建整套工具链不现实,更可行的路径可能是优化现有流程、引入更高效的缓存层,或重新审视代码审查的粒度与自动化程度。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。