Anthropologic:用「人类语境协议」重构消费者研究

Anthropologic 以「人类语境协议」为核心,主打兼具速度与文化深度的AI消费者研究平台。
Anthropologic 是一款定位于「零距离消费者研究」的 AI 平台,试图填补传统定性调研(慢)、社交媒体监听(浅)和通用 LLM 工具(文化盲视)三者之间的断层。其核心技术卖点「人类语境协议」宣称可读取全网内容,提取带有文化语境的消费者洞察,而非仅停留在关键词频率统计。产品覆盖 9 个工作流、239 个市场、100 余种语言,承诺在数分钟内响应研究、创新与趋势前瞻类问题。上线首日即登 Product Hunt 当日第 6,目标用户指向品牌营销人员和产品创新团队。不过,协议的技术实现细节尚未公开,数据来源合规性、跨语言洞察准确度及其与常规 NLP 流程的实质差异,仍有待独立验证。
传统消费者研究陷入了一个长期困境:定性调研深入却缓慢,往往要花上数周才能得出结论;社交媒体监听(social listening)虽然迅速,却停留在表面情绪的抓取;而当下火热的大语言模型语言流畅,却缺乏对文化背景的理解。登陆 Product Hunt 并冲上单日榜单第 6 名的 Anthropologic,正是瞄准了这三者之间的裂缝。
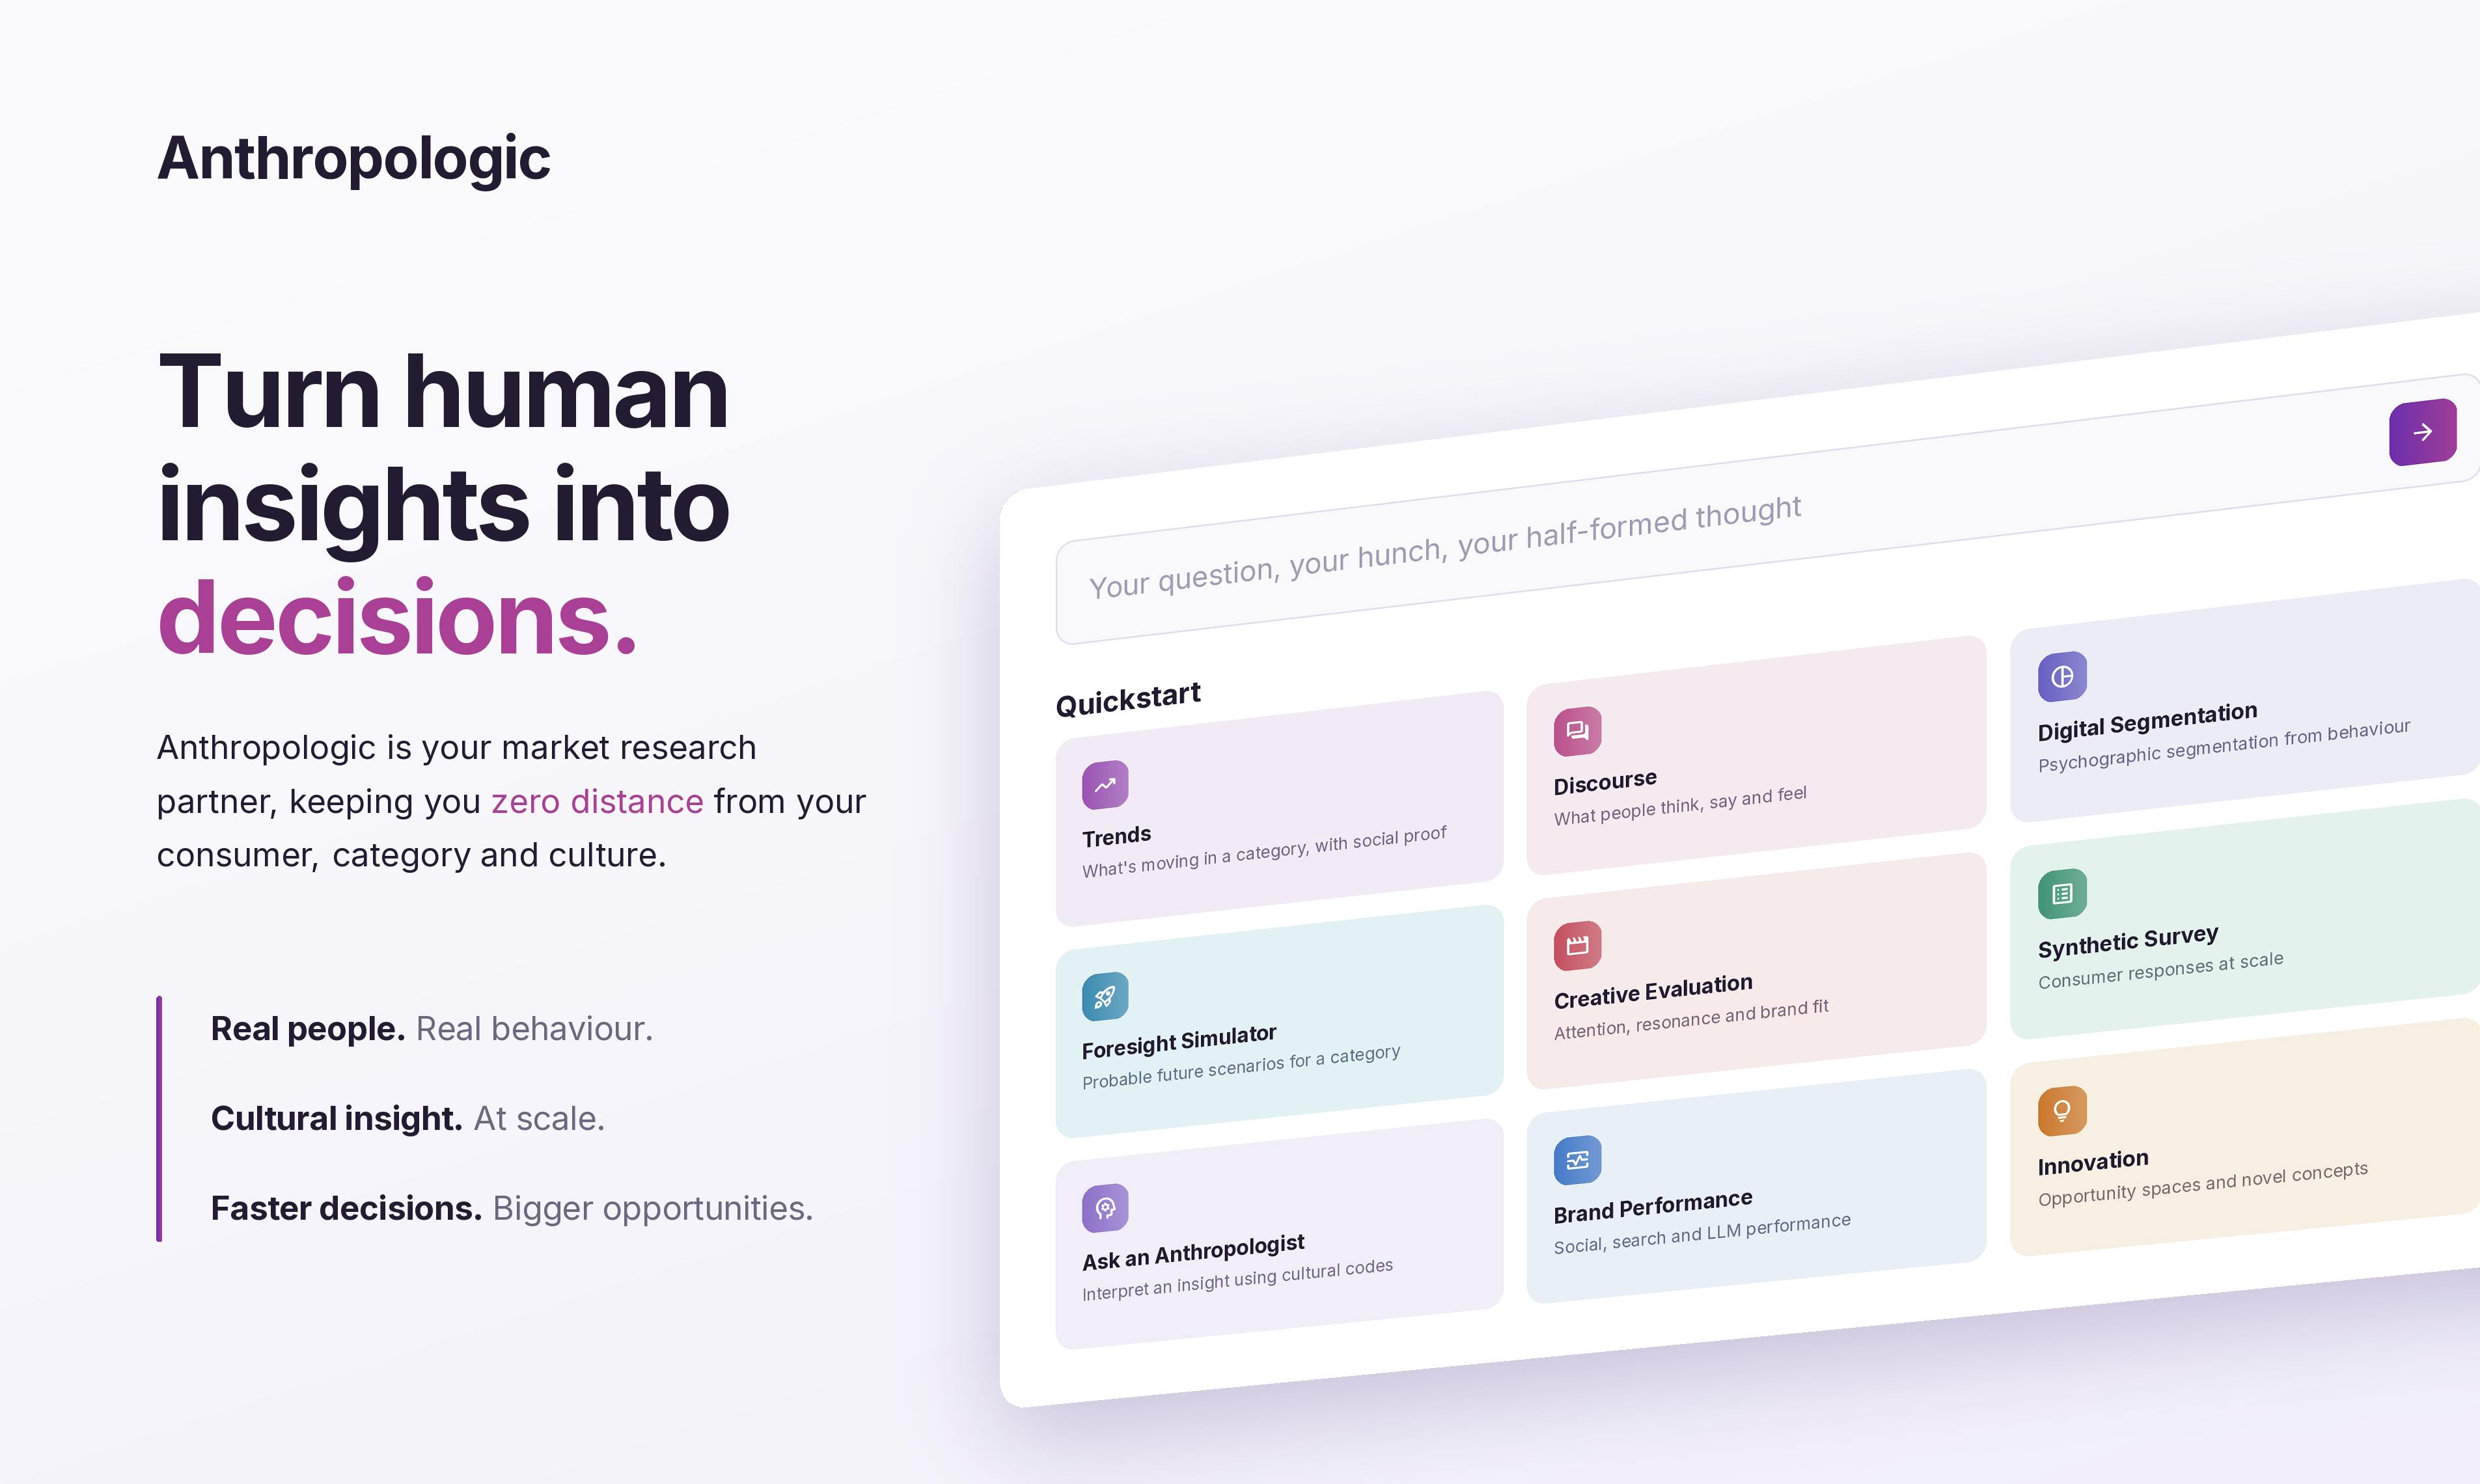
三种研究范式的断层
Anthropologic 对自身的定位是「零距离消费者研究平台」(zero distance consumer research platform)。这个说法背后是对现有市场研究工具链的一次直接批评。
按照官方的描述,市场上主流的洞察获取方式各有短板:传统研究「深度有余、速度不足」,一份严谨的报告可能要经历招募受访者、执行访谈、数据编码等多个环节;社交监听工具「快而浅」,能实时捕捉到品牌提及量和情绪倾向,却难以解释背后的文化动因;而 LLM 类工具「语言流畅但文化盲视」,它们能生成看似合理的分析,却无法真正理解特定市场、特定人群的语境。
在营销和产品创新领域,这三种能力——深度、速度、文化理解——很少能同时获得。团队的判断是,这个断层本身就是一个值得攻克的产品机会。
社交媒体监听(Social Listening)作为一种方法论,诞生于品牌需要实时追踪公众舆论的背景下。主流工具如 Brandwatch、Sprinklr、Meltwater 等,核心能力是抓取 Twitter/X、Reddit、Instagram 等平台的公开内容,通过情感分析(Sentiment Analysis)和关键词聚类,输出品牌声量、情绪比例、话题热度等指标。这类工具的局限在于它本质上是「计数」而非「理解」——它能告诉你有多少人在抱怨某款产品,却无法解释这种抱怨背后是文化期待落差、消费习惯差异还是竞品对比效应。另一个结构性缺陷是语言覆盖不均:英语内容的情感识别准确率远高于小语种,这导致跨国品牌在非英语市场的洞察质量往往打折扣。Anthropologic 将自己与这一范式的对比,切中的正是「解释力」这个核心痛点。
核心机制:Human Context Protocol
Anthropologic 的技术卖点是所谓的「人类语境协议」(Human Context Protocol)。据产品介绍,该协议让平台能够「读取整个互联网」,从中挖掘关于消费者、品类和文化的真相。
从表述来看,这套机制的目标是把海量的公开网络内容转化为带有文化语境的洞察,而不仅仅是统计层面的关键词频率。换句话说,它试图在大规模数据处理的效率之上,叠加一层对人群动机、文化符号和消费心理的解读能力——这恰恰是纯粹 LLM 方案常被诟病的短板。
需要说明的是,官方目前对该协议的具体实现细节披露有限,「读取整个互联网」更像是一种能力宣称而非技术白皮书。对于潜在用户而言,这套机制在真实业务场景中的准确度和可靠性,仍需要通过实际使用来验证。
「读取整个互联网」这一表述,在技术实现上通常对应两类路径:一是基于大规模网络爬虫与公开数据集(如 Common Crawl)的预训练或检索增强生成(RAG,Retrieval-Augmented Generation)架构;二是对接第三方数据供应商的结构化内容库(涵盖新闻、论坛、评测、电商评论等)。RAG 的核心思想是在语言模型生成答案时,实时检索外部知识库以提供时效性更强的事实依据,从而缓解纯 LLM「知识截止日期」和「幻觉」问题。如果 Anthropologic 的人类语境协议建立在类似架构之上,其差异化的关键就不在于模型本身,而在于数据源的质量与覆盖、检索策略的设计,以及将检索结果映射为「文化洞察」的后处理层。这也是为何在没有技术白皮书的情况下,外界难以判断其实质竞争壁垒的原因。
规模化的洞察能力
除了方法论层面的叙事,Anthropologic 用一组具体数字来支撑其覆盖广度:
- 9 个工作流(Nine workflows):覆盖研究、创新与前瞻(foresight)等多类需求;
- 239 个市场:几乎覆盖全球主要国家和地区;
- 100+ 种语言:支持跨语言的内容读取与分析;
- 分钟级响应:研究、创新与前瞻问题可在数分钟内得到答案。
这组数据指向的是一种「广覆盖 + 快响应」的产品形态。对跨国品牌和全球营销团队来说,能够在统一平台上横跨上百个市场、多种语言获取洞察,理论上可以显著压缩传统调研在多地区执行时的时间与协调成本。
面向谁,解决什么问题
Anthropologic 在 Product Hunt 上归入 Marketing、Artificial Intelligence 与 Data & Analytics 三个分类,目标用户画像相当清晰:品牌营销人员、产品创新团队和市场研究者。
它试图替代或补充的,是那些既需要速度又需要深度的场景——比如新品概念验证、进入新市场前的文化洞察、趋势前瞻等。这些场景过去往往依赖外部调研公司,周期长、成本高。Anthropologic 提供的「分钟级答案」如果能保证质量,将对咨询式研究服务构成实质性冲击。
上线首日获得 104 个投票、39 条评论并排进当日榜单第 6,说明这一方向在社区中确实引发了关注。研究工具的 AI 化是近年的明显趋势,Anthropologic 的差异化在于它没有把自己包装成「又一个 AI 分析助手」,而是强调文化语境这一更难攻克的维度。
值得关注的问题
作为一款新发布的产品,Anthropologic 目前给出的更多是愿景和能力宣称,而非可验证的效果证据。几个关键问题仍待观察:「读取整个互联网」的数据来源合规性如何?跨 100 多种语言的文化洞察,其准确度能否达到专业调研的水准?「人类语境协议」究竟是一套可复用的方法论,还是营销包装下的常规 NLP 流程?
对于考虑采用的团队,理性的做法是先在自己熟悉的市场做小范围验证,用已知答案去检验平台的输出质量,再决定是否将其纳入正式的研究工作流。
数据合规性是此类产品最容易被忽视却风险最高的维度。大规模抓取公开网络内容在法律层面并非一片坦途:欧盟《通用数据保护条例》(GDPR)对涉及自然人的数据处理设有严格限制,即便是公开发帖,若能关联到个人身份,仍可能触发合规义务;美国《计算机欺诈和滥用法案》(CFAA)的边界也因 hiQ Labs 诉 LinkedIn 等案件而持续演变。对于将 Anthropologic 输出用于商业决策的企业团队而言,在引入工具前有必要向供应商明确询问:数据来源协议是否合规、是否有数据处理协议(DPA)可供签署、跨境数据流转是否符合目标市场的本地法规。这不仅是法律风险管理的要求,也直接关系到洞察结论能否在正式业务场合使用。
相关推荐
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。