AnySearch:专为AI Agent设计的搜索插件,省Token提效果

AnySearch通过为AI Agent提供结构化高质量数据,大幅降低token消耗并提升答案质量。
AI Agent联网搜索时面临SEO垃圾、过时内容等低质量信息的困扰,导致大量token浪费在信息筛选上。AnySearch搜索插件通过信息过滤前置、结构化输出、时效性判断等机制,将信息清洗工作从Agent端转移到中间层,实测可将token消耗降低三倍,同时显著提升答案的深度和准确性。
AI Agent联网搜索的隐藏痛点
当我们让AI Agent联网搜索时,一个被忽视的问题正在悄然吞噬效率——互联网上充斥的SEO垃圾信息、过时内容和低质量帖子,让Agent不得不花费大量token去筛选和整理,最终交付的答案质量却不尽如人意。
这里需要理解一个关键背景:Token是大语言模型处理信息的基本计量单位,每次AI Agent进行联网搜索、阅读网页内容、生成回答时都会消耗token。对于GPT-4等高端模型,每百万token的成本可达数十美元。当Agent需要处理大量低质量网页内容时,token消耗会急剧膨胀——一个普通网页可能包含数千token的导航栏、广告、侧边栏等无关内容,而真正有价值的信息可能只占其中的10-20%。这意味着80%以上的token开销实际上被浪费在了信息噪声上。
最近,一款名为AnySearch的搜索插件在海外开发者圈子中迅速走红。它的核心理念很简单:为AI Agent提供优质、实时、准确的结构化数据,让Agent在联网搜索时能一眼找到最需要的内容,而不是在信息海洋中漫无目的地"冲浪"。
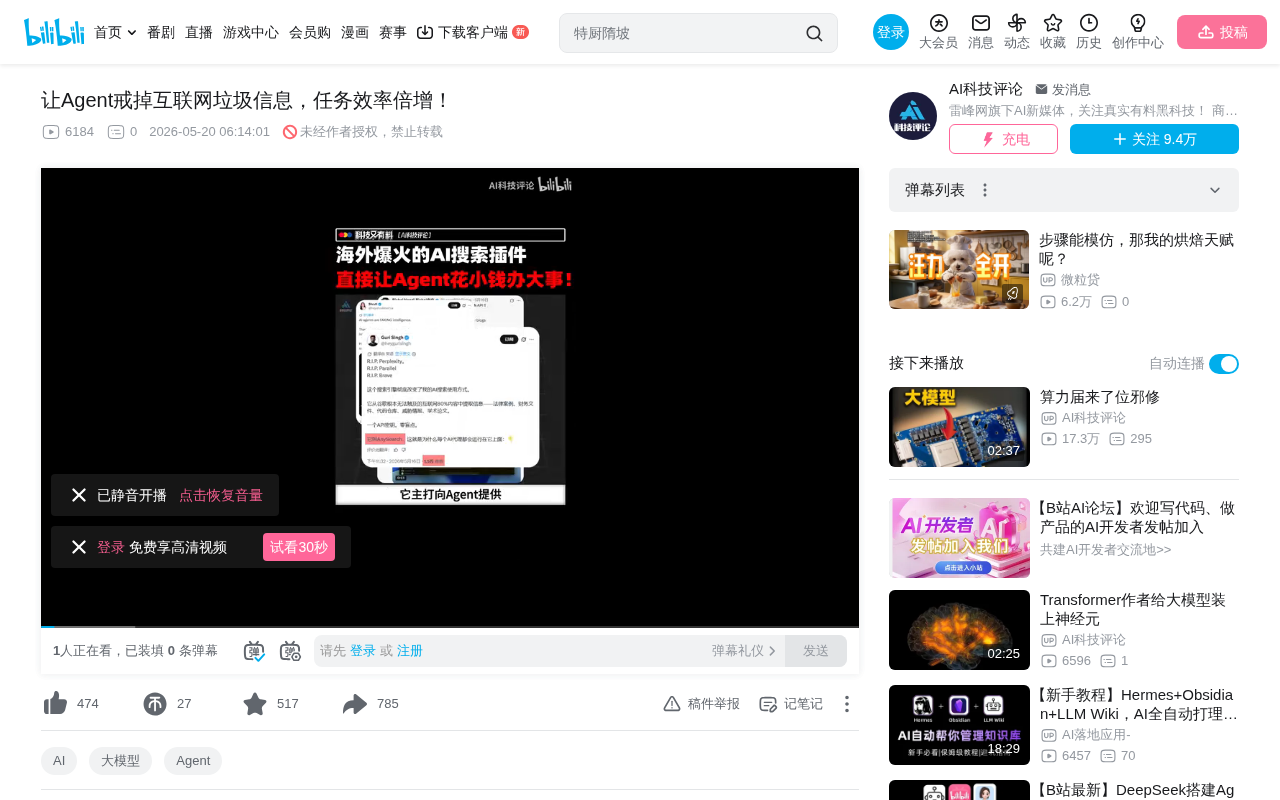
AnySearch的核心价值:从"给人看"到"给AI看"
传统搜索引擎为什么不适合AI Agent
传统搜索引擎提供的信息本质上是为人类阅读设计的,里面掺杂了大量SEO优化内容、广告信息和冗余文本。SEO(搜索引擎优化)原本是帮助优质内容获得更好排名的技术手段,但近年来已演变为一个严重的互联网污染问题。大量网站通过关键词堆砌、AI批量生成低质量内容、建立链接农场等手段操纵搜索排名。Google在2024年的核心算法更新中承认,搜索结果中约40%的内容存在不同程度的SEO操纵。对人类用户而言,识别这些内容相对容易;但对AI Agent来说,它缺乏人类的直觉判断能力,容易将高排名等同于高质量。
当AI Agent调用这些搜索结果时,需要额外花费token去:
- 过滤SEO垃圾信息
- 整理非结构化的网页内容
- 判断信息的时效性和可靠性
- 从冗长的页面中提取关键数据
这些步骤不仅消耗大量token,还经常导致Agent"迷路",给出不相关或低质量的答案。
AnySearch如何解决这些问题
AnySearch的核心差异化在于,它提供的信息经过专门优化,更垂直、更具结构性。这里所说的结构化数据,是指按照预定义模式组织的信息(例如JSON、XML格式),包含明确的字段名、数据类型和层级关系。与普通网页中的自由文本不同,AI Agent接收到结构化数据后,可以直接按字段提取所需信息,无需进行复杂的自然语言理解和信息抽取,这大幅减少了推理步骤和token消耗。
AI Agent接收到这些数据后,可以直接跳过筛选和整理步骤,立即进入推理阶段。具体优势包括:
- Token消耗大幅降低:省去了信息清洗的开销
- 答案质量更优:基于高质量结构化数据推理
- 响应速度更快:减少了中间处理环节
实测对比:三个场景验证AnySearch效果
场景一:AI视频提示词搜索
在使用AI视频工具制作故事看板的工作流中,需要在Reddit上寻找高质量的提示词模板。
未使用AnySearch时:Agent在Reddit上大量消耗token"冲浪",但返回的答案空洞,几乎没有找到有用的提示词。整个过程花费53积分,其中联网搜索就占了44积分。
接入AnySearch后:同样的提示词,Agent直接返回了8个AI视频提示词模板,全部来自Reddit上短时间内讨论飙升的热门内容。整个过程仅花费15积分——Token消耗降低了三倍,但答案一次到位。
这个对比清晰地展示了AI Agent工作流中的效率瓶颈所在。现代AI Agent通常遵循"感知-推理-行动"的循环模式:首先调用搜索工具获取信息(感知),然后对信息进行分析和筛选(推理),最后生成回答或执行下一步操作(行动)。如果感知阶段获取的信息质量低下,Agent往往需要多次循环——反复搜索、交叉验证、重新筛选——每次循环都会消耗额外的token和时间。优化信息输入质量本质上是在减少Agent的推理循环次数。
场景二:新闻深度信息收集
以"智源机器人进厂打工"这一新闻为例:
普通搜索模式:Agent返回的答案像新闻通稿,只知道机器人进厂了、有99.5%的成功率,但完全不知道具体做什么、怎么做。
AnySearch模式:答案直接变成深度分析——机器人在厂里具体干了什么、怎么干的、效率如何、相当于人类什么水平。还引用了各家专业媒体的评价,甚至包括福布斯等付费文章的内容总结。最后附带"独家发现模块",给出结构性的总结回复。
整个答案的逻辑性和结构性达到了"投资人看一眼就能明白"的程度。
场景三:编程工具智能选择
在开发项目时,需要Agent选择合适的视频抠背景工具。问题在于:一些年份久远的工具在GitHub上收藏量很高,但已经停止维护,性能远不如新工具。Agent经常"犯迷糊"选择老工具,导致抠图质量参差不齐。
接入AnySearch后,这个问题彻底解决。AnySearch找项目不是死板地看收藏量,而是综合考虑发布时间、网络评价以及项目的适用性,确保推荐的工具是当前最优解。
技术原理:AnySearch为什么能省Token
深入分析AnySearch省token的机制,核心在于信息预处理的位置发生了转移:
- 信息过滤前置:在数据到达Agent之前,已经完成了垃圾信息的过滤
- 结构化输出:提供的数据已经是Agent可以直接消费的格式
- 时效性判断:自动评估信息的新鲜度和可靠性
- 相关性排序:基于AI使用场景优化的排序算法
这就像一个道理:Agent能看到什么质量的信息,直接决定了它能交付什么质量的答案。AnySearch做的就是在源头把控信息质量。
从技术架构的角度来看,这种设计将原本在Agent端进行的计算密集型任务(信息清洗、去重、结构化提取)转移到了专门的中间层服务上。这不仅节省了昂贵的LLM推理成本,还能利用专门优化的算法和缓存机制来提升处理效率,实现了计算资源的更合理分配。
AnySearch使用方式与平台兼容性
支持的Agent平台
AnySearch支持主流的Agent平台,包括:
- Codex Cloud
- Code Open Cloud
- 国内的QClub等平台
AnySearch能够跨平台接入多个Agent,得益于近期兴起的MCP(Model Context Protocol)等标准化协议。MCP由Anthropic于2024年底提出,旨在为AI模型与外部工具之间建立统一的通信标准,类似于USB接口统一了硬件连接方式。通过这类协议,开发者只需编写一次工具适配代码,就能让工具在不同的Agent平台上运行,大大降低了生态碎片化的问题。这也是为什么AnySearch能够以"一键接入"的方式支持多个平台的技术基础。
安装接入方法
使用非常简单:在AnySearch官网复制安装命令,发送给你想使用的Agent产品,即可完成自动安装。目前面向所有开发者免费开放体验,可接入任意Agent和AI工作流。
总结:优化Agent效率的新思路
当前AI领域的竞争焦点集中在模型能力和提示词优化上,但Agent的一个关键短板被忽视了——它能看到什么。Agent不会像人一样判断哪个帖子是真经验、哪个项目已经过时、哪个回答只是SEO垃圾。
AnySearch的价值在于,它相当于给Agent配了一个"天天泡Reddit、刷GitHub、混技术论坛的老网民"。它不只是帮AI搜集到更多真正有价值的信息,更在帮AI判断当下互联网中什么信息值得信赖。
对于重度使用AI Agent的开发者来说,这可能是一个值得尝试的效率提升方向——与其不断优化提示词,不如先确保Agent看到的信息本身就是高质量的。这个思路也呼应了AI系统设计中的一个基本原则:垃圾进,垃圾出(Garbage In, Garbage Out)。无论模型能力多强,如果输入的信息质量不过关,输出质量也难以保证。从信息源头进行质量把控,可能是当前提升Agent实际表现最被低估的优化方向。
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。