AP Tensor Neural Networks Solve 3D High-Field Kinetic Equations

张量分解加矩约束损失使3D3V动理学方程单GPU半小时训练完成。
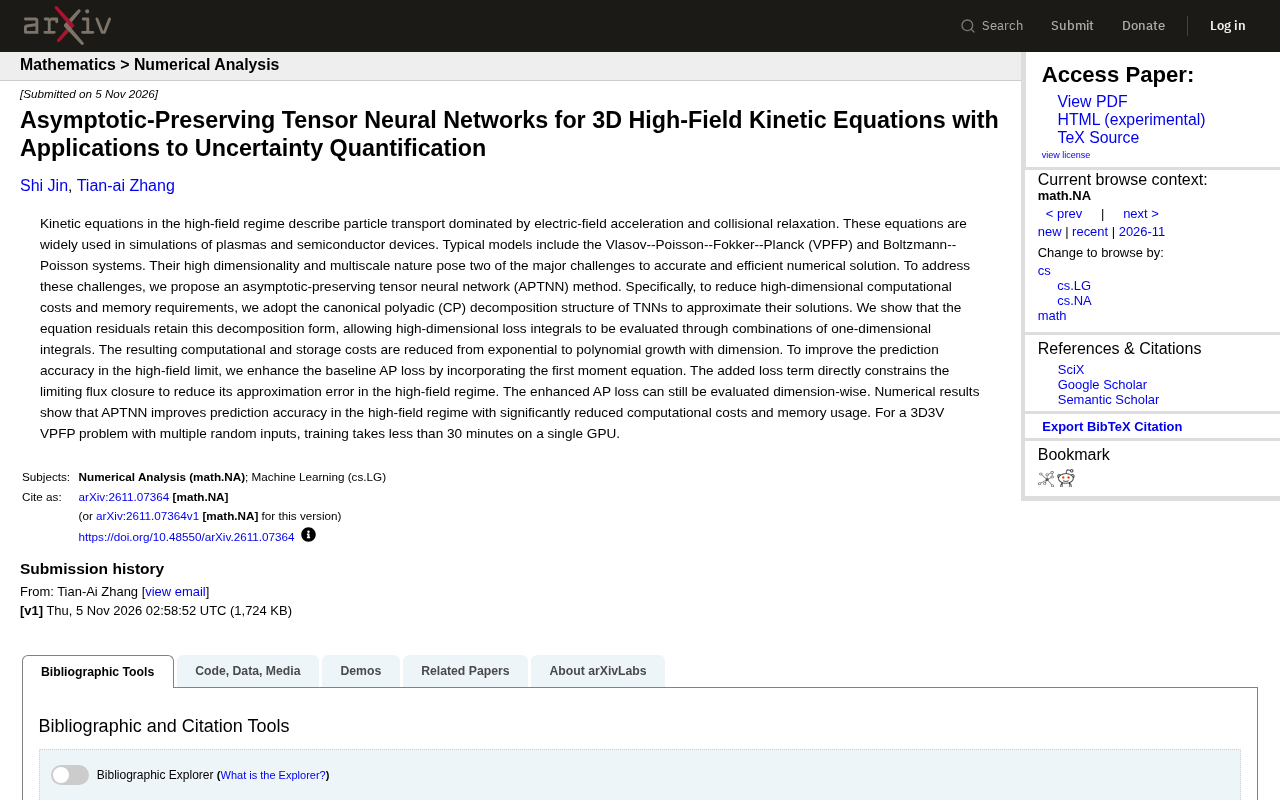
高维动理学方程面临维度灾难与多尺度耦合双重挑战。最新研究提出的渐近保持张量神经网络(APTNN),将张量神经网络的CP分解结构引入解的近似表示,使方程残差保持可分解形式,从而将高维损失积分转化为一维积分组合,计算与存储成本从指数增长降为多项式增长。针对高场极限精度下降问题,该方法在基线AP损失中加入一阶矩方程约束极限通量闭合,且增强后的损失仍可按维度求值。数值实验表明,带多个随机输入的3D3V VPFP问题在单GPU上训练不到30分钟,高场区精度显著提升、内存大幅降低。该方法为PINN类方法处理高维多尺度问题提供了结构性解法,但与传统求解器的系统性效率对比及复杂边界条件下的鲁棒性仍有待验证。
高维动理学方程的数值求解长期受困于"维度灾难"与多尺度耦合两大难题。一篇最新研究提出的渐近保持张量神经网络(APTNN),通过张量分解与物理约束损失的结合,将3D3V Vlasov–Poisson–Fokker–Planck问题的训练时间压缩到单GPU半小时以内,为等离子体与半导体器件仿真提供了新的技术路径。
问题背景:高场动理学方程的双重挑战
在高场区,动理学方程描述的是电场加速主导、碰撞弛豫次之的粒子输运过程。Vlasov–Poisson–Fokker–Planck(VPFP)与Boltzmann–Poisson系统是这类问题的典型代表,广泛用于等离子体物理和半导体器件模拟。
麻烦在于两个层面:一是维度极高——三维空间加三维速度(3D3V)意味着六维相空间,传统网格方法的内存与计算量随维度指数膨胀;二是多尺度——高场极限下系统趋近于流体力学极限,数值格式若不能保持渐近性质,要么在细网格上浪费算力,要么在粗网格上失真。
渐近保持(Asymptotic Preserving, AP)格式是处理多尺度动理学方程的核心数值概念。以高场VPFP系统为例,当碰撞频率趋于无穷大时,方程的解收敛到流体力学极限(如Euler或Navier–Stokes方程)。一个数值格式若不具备渐近保持性,则要么在细网格上解析极小的Knudsen数而浪费算力,要么在粗网格上无法正确捕捉极限行为而失真。AP格式的设计目标是:在离散层面自动保持这一连续极限,使得粗网格计算仍能收敛到正确的流体极限解。APTNN将这一思想从传统离散格式迁移到神经网络训练中,通过损失函数的结构设计来维持极限一致性。
APTNN的核心设计:让残差保持可分解
研究团队的思路是把张量神经网络(TNN)的典范多项式(CP)分解结构引入解的近似表示。关键洞察在于:方程残差在这一表示下仍然保持CP分解形式,于是高维损失积分可以拆解为一维积分的组合来计算。
这一性质直接改变了成本曲线——计算与存储开销从随维度指数增长降为多项式增长。对于六维问题,这种差异是数量级层面的。
增强渐近保持损失:用一阶矩方程约束通量
仅有分解结构还不够。在高场极限附近,基线AP损失的约束力偏弱,预测精度会下降。作者的做法是在损失函数中额外加入一阶矩方程,让新增损失项直接约束极限通量闭合,从而压低高场区的近似误差。
说个细节,增强后的AP损失依然可以按维度分别求值,没有破坏CP分解带来的效率优势。这一点是该方法能否落地的关键——物理约束的加入没有换来计算可行性的丧失。
张量神经网络(Tensor Neural Network, TNN) 是一种将高维函数表示为若干一维函数张量积之和的网络结构,其数学形式与张量分解中的典范多项式(CP)分解密切相关。具体而言,一个d维函数可近似为若干一维网络输出的乘积之和,每个一维网络独立处理一个坐标方向。这种结构的优势在于:高维积分可分解为各一维积分的乘积,从而避免在高维空间中进行网格化或蒙特卡洛采样。TNN已被用于求解高维椭圆型PDE和Schrödinger方程,其精度与维度弱相关。APTNN的关键贡献在于验证了VPFP方程的残差在TNN表示下仍保持CP形式,使得损失函数的计算复杂度从指数级降为多项式级。
实验结果:精度与效率的同步改善
数值结果表明,APTNN在高场区的预测精度有明显提升,同时计算成本和内存占用大幅下降。论文给出的具体算例是一个带多个随机输入的3D3V VPFP问题,在单块GPU上训练耗时不到30分钟。
这个数字的意义在于工程可行性:六维相空间问题此前往往需要大规模并行集群,而现在单卡即可在小时级以内完成训练。对不确定性量化(UQ)应用而言,这意味着多随机输入下的重复训练变得现实可行。
需要客观指出的是,论文目前报告的是训练时间与精度改善,尚未给出与代表性传统求解器在同等精度下的系统性效率对比,这一方向的完整基准测试有待后续工作补充。
不确定性量化(UQ) 在动理学仿真中通常指考察输入参数(如初始条件、碰撞系数、边界数据)的随机扰动如何传播到输出。传统方法需要对每个样本重新运行离散求解器,计算成本与样本数成正比,在高维问题中往往不可承受。APTNN的CP分解结构使得网络可以接受随机输入作为额外维度,训练一次即可获得参数化解映射,从而将UQ的边际成本大幅降低。论文中“带多个随机输入的3D3V VPFP问题”即指这一设定:网络同时学习解对物理变量和随机参数的依赖关系,单次训练后可在参数空间内快速评估。
为什么值得关注:PINN在高维问题上的可行路径
物理信息神经网络(PINN)在高维问题上一直面临"loss积分算不动"的瓶颈。APTNN的价值在于它给出了一个结构性解法:不是靠采样技巧绕过高维积分,而是让被积对象本身保持可分解,从根上消除指数依赖。
方法层面,这项工作的两个组件——CP分解的TNN表示、基于矩方程的增强损失——都具备一定的通用性。前者适用于其他具有低秩结构的高维PDE解,后者则提示了一条思路:把宏观矩约束嵌入微观动理学模型的训练目标,可能是处理多尺度问题的有效手段。
对等离子体和半导体EDA领域的从业者来说,若该方法能在更复杂的碰撞算子与边界条件下保持精度,其作为传统离散求解器的补充工具,价值会相当明确。
物理信息神经网络(PINN) 的核心思想是将PDE残差作为损失函数的一部分,通过最小化残差来训练网络逼近解。其标准做法是在计算域内随机采样配点,用自动微分计算残差,再对残差平方做蒙特卡洛估计。然而在高维问题中,这一策略面临根本困难:均匀采样所需的点数随维度指数增长,而稀疏采样则导致损失估计的方差过大、训练不稳定。APTNN绕开了这一困境——它不依赖采样技巧来近似高维积分,而是通过张量分解使积分本身可精确分解计算。这一区别是结构性的:前者是统计近似,后者是代数恒等,因此在维度升高时不会退化。
局限与展望
CP分解的秩选择、增强损失项在不同参数区域下的权重平衡、以及向更复杂几何与边界条件的推广,都是尚未在摘要中充分展开的问题。从研究到工程部署之间,还需要在真实器件仿真场景中验证其鲁棒性。
不过,单GPU半小时训练3D3V VPFP问题这一结果本身,已经足以让高维动理学仿真领域重新审视神经网络方法的定位。
相关推荐
 科技前沿
GitHub日报·11月07日:Agent就绪与上下文压缩
2026年09月02日(周三)午间版 AI新闻速递+热点深度讨论

T3 Code:免费开源,统一管理所有AI编程代理
T3 Code是一款免费开源应用,将Cloud Code、Codex等AI编程工具聚合到单一界面,支持对话接力、分支隔离审查、自动提交PR及远程访问,帮助开发者告别多窗口切换。

Cursor上线Live Apps:一键生成可分享链接
Cursor 为云端智能体推出 Live Apps 功能,可自动搭建 Web 应用、配置 Postgres 与 Cursor 登录、执行安全检查并部署到指定域名,生成可分享链接。本文解析其适用范围、安全管控与上手建议。